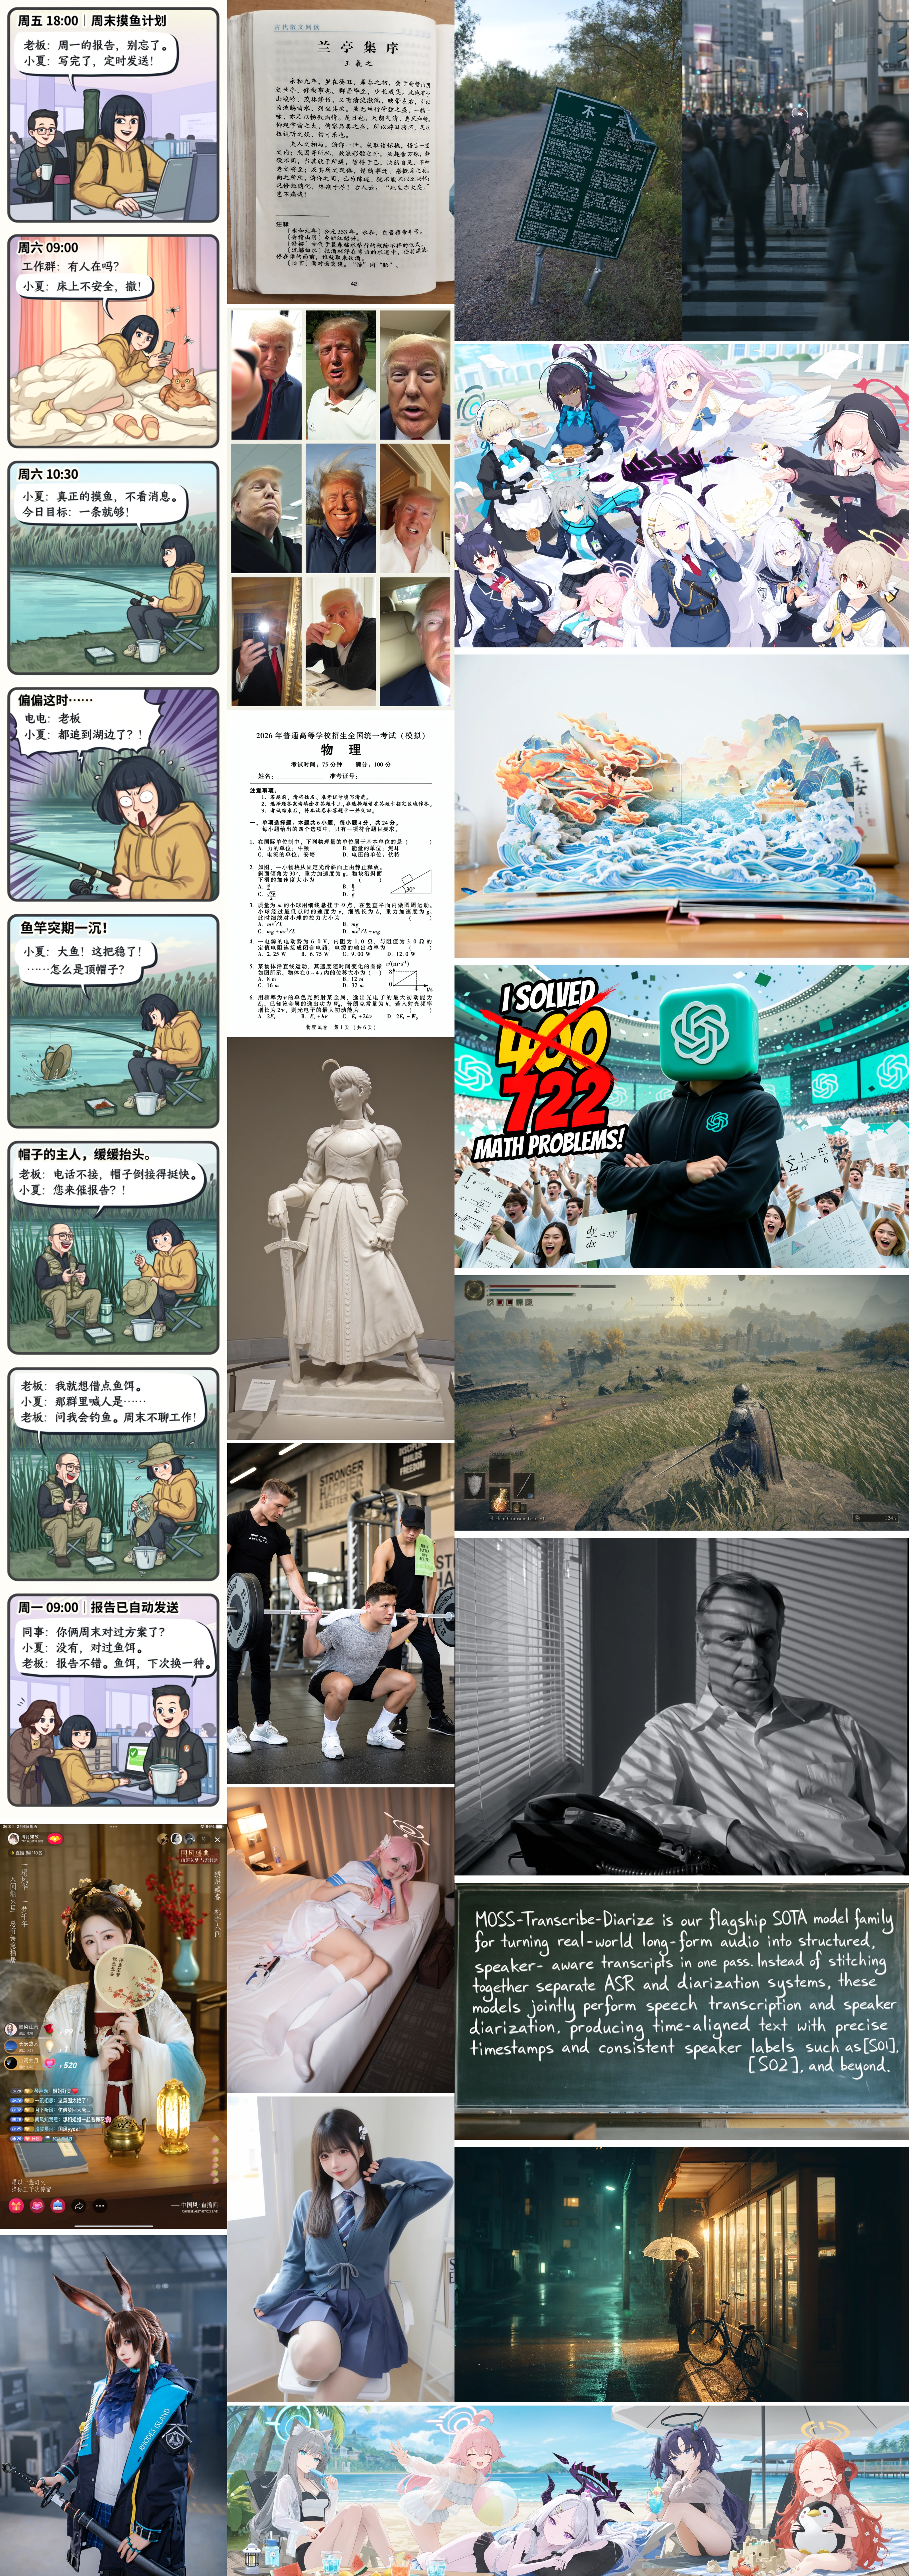
MOSS-Image(也常写作 MOSS Image)是 OpenMOSS 开源的文生图系列。主干是从零预训练的 5B 单流扩散 Transformer(DiT),搭配冻结的 Qwen3.5-9B 文本编码器和 FLUX.2 VAE。除自然语言提示外,还支持标签序列,以及用 JSON 布局指定渲染文字和物体的位置。MOSS-Image-Base 和 MOSS-Image-SFT 权重在 Hugging Face 与 ModelScope 上以 Apache-2.0 发布,代码与文档在 OpenMOSS/MOSS-Image。团队于 2026 年 10 月 16 日公开权重,10 月 19 日在 arXiv 挂出技术报告(arXiv:2610.23374)。
技术报告里,MOSI.AI 的署名单位包括 MOSI Intelligence、SII、复旦大学和上海交通大学。AI Rank 把该仓库归在图像生成类;截至 2026 年 10 月 22 日,它在 GitHub 上有 1,394 个 star、68 个 fork。
要点
| 内容 | |
|---|---|
| 主干 | 5B 单流 DiT(仅生成器参数量;不含冻结的编码器与 VAE) |
| 文本编码器 / VAE | Qwen3.5-9B(冻结) / FLUX.2 VAE(冻结) |
| 提示长度 | 最长约 4K 文本 token(训练最后阶段) |
| 检查点 | MOSS-Image-Base、MOSS-Image-SFT |
| 许可(权重与自带推理代码) | Apache-2.0 |
| 默认采样 | Flow-matching Euler,50 步,CFG 3,shift 5,负向分支在第 22 层跳过 |
| 长文本(作者自报) | 自家 LLTB 榜上开源权重 Mean-6 为 96.3;同表 Qwen Image 2512 为 64.9 |
Base 与 SFT 的区别与选型
两个检查点架构相同,Diffusers / Gradio 接口也相同。
| MOSS-Image-Base | MOSS-Image-SFT | |
|---|---|---|
| 定位 | 预训练基座 | 在 Base 上用精选数据做监督微调 |
| 后训练 | 用户指南写明 Base 未做后训练或 CFG 蒸馏,方便社区继续训 LoRA | 面向开箱即用 |
| 官方对照图 | — | 同一提示下,SFT 的文字分组更清晰,白板布局更整齐 |
选型建议。 打算自己训 LoRA 或做领域适配时用 Base(用户指南要求文本编码器保持冻结)。直接出图、不想再训时用 SFT。两种都可以吃自然语言、标签序列或 JSON 布局。
通过 Diffusers 运行
官方 Quick Start(Python 3.10+,NVIDIA GPU)。可从仓库安装,也可按 Hugging Face 模型卡上的依赖版本(如 diffusers>=0.38、transformers>=5.3)。PyTorch 需与本机 CUDA 匹配。
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "OpenMOSS-Team/MOSS-Image-Base",
    custom_pipeline="pipeline_moss_image",
    trust_remote_code=True,
    torch_dtype={"default": torch.bfloat16, "vae": torch.float32},
)
pipe.scheduler = type(pipe.scheduler).from_config(pipe.scheduler.config)
pipe.to("cuda")
image = pipe(
    "A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese:“\n记得买牛奶和鸡蛋!\n牛奶两盒,鸡蛋一打。\n顺便带一袋面包。”",
    height=1456,
    width=1456,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]
image.save("refrigerator_note.png")
把模型 id 换成 OpenMOSS-Team/MOSS-Image-SFT 就是 SFT。Python API 的宽高必须是正的 16 的倍数。Gradio 高级设置提供三种显存模式:整模驻留 GPU、按组件在 CPU/GPU 间搬移、Sequential。文档写明显存不够就选 Sequential 或缩小分辨率,没有公布固定的显存数字。
用 vLLM-Omni 部署
vLLM 提供了 Base / SFT 的首日配方,通过 vLLM-Omni 对外提供 /v1/images/generations。单卡 Docker 示例(摘自官方 recipe):
export IMAGE=vllm/vllm-omni:mosimage
export MODEL=OpenMOSS-Team/MOSS-Image-Base

docker pull "$IMAGE"
docker run --rm --name moss-image \
  --gpus 'device=0' --ipc=host \
  -p 8000:8000 \
  -v "$HOME/.cache/huggingface:/root/.cache/huggingface" \
  -e HF_TOKEN \
  "$IMAGE" \
  vllm serve "$MODEL" --omni \
    --enforce-eager \
    --port 8000
recipe 上写的检查点体积是 Base / SFT 各 33 GB(下载体积,不是显存占用)。建议至少 50 步、CFG 3.0–6.0、flow shift 5.0,负向分支用 uncond_skip_layers=[22]。完整请求 JSON 与布局示例见 vLLM 的 MOSS-Image-Base 配方。
JSON 布局控制
布局和自然语言走同一条提示通道。JSON 里要有 summary、items,以及 bbox_coord_space: "abs_centralized"、bbox_format: "yxyx"。坐标是相对画布中心的像素 [y_min, x_min, y_max, x_max](1024×1024 时每轴约 −512 到 +512)。项目站和用户指南里的旅行海报示例:
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."
  },
  "items": [
    {
      "label": "text",
      "caption": "Large dark-blue uppercase title centered at the top.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    },
    {
      "label": "object",
      "caption": "A flat blue mountain illustration in the lower center.",
      "bbox": [-192, -288, 384, 288]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
用 json.dumps(layout, ensure_ascii=False) 序列化后当作 prompt,宽高与布局一致。项目还提供 Prompt Enhancer 技能,把想法整理成详细 caption 或布局草稿,本身不会调用生图接口。
与 Qwen-Image 的对比(仅已公开数字)
下表数字全部来自 MOSS-Image 技术报告。LLTB 是作者自建的长文本基准(240 题,中英,Mean-6 文本覆盖率)。排名是作者在自家榜上的结果,不是第三方独立评测。
| 指标 | MOSS-Image | Qwen Image 2512 | 出处 |
|---|---|---|---|
| LLTB 六组平均覆盖率(开源权重大表) | 96.3 | 64.9 | 技术报告 §1 / §5.2 |
| 差距 | +31.4 个百分点 | — | 同上 |
同文还有:在 RealLayoutArena(RLA)端到端对比里,MOSS-Image 得分 1698.70 Elo,排第二,落后于 GPT Image 2;在共享增强自然语言提示的生成器对比里,MOSS-Image 主干 1807.34 Elo,列作者名单中的第一。LongTextBench 上强模型已经挤在 96–99 分附近,所以作者主推更长的 LLTB。
许可与限制
权重与自带推理代码为 Apache-2.0;流水线和其他第三方组件保留各自许可。模型卡感谢了 Diffusers、Qwen 和 FLUX 团队。
技术报告写明的限制:主干只做文生图,不直接吃参考图,也不做图像编辑;智能体式提示增强依赖外部大模型,规划出错时即使渲染准确,布局也会偏。用户指南仍把 JSON 布局标为实验性功能。
常见问题
Base 和 SFT 都要下吗? 不用。二选一即可。要自己微调用 Base;直接出图用 SFT。
中文文字行不行? 可以。官方示例有多行中文手写和标题。场景描述尽量用英文;画面上要出现的中文保留中文,并用显式换行控制行距。
ComfyUI 能用吗? 仓库提供原生插件,在 ComfyUI Manager 搜 MOSS-Image。并入官方 ComfyUI 仓库的工作还在进行中。
论文在哪? arXiv:2610.23374,项目主页也挂了 PDF。
继续探索: 在 AI Rank 的开源项目排名 查看今天增长最快的 AI 开源项目。
或 📱 下载 AI Rank App 在手机上随时查看。
来源
- MOSS-Image 项目站
- GitHub:OpenMOSS/MOSS-Image
- Hugging Face:MOSS-Image-Base
- Hugging Face:MOSS-Image-SFT
- 英文用户指南
- 技术报告(arXiv:2610.23374)
- vLLM-Omni 配方:MOSS-Image-Base
- AI Rank 上的 MOSS-Image
本文使用自动化编辑辅助,于 2026 年 10 月 19 日依据项目站、GitHub README 与用户指南、Hugging Face 模型卡、arXiv:2610.23374、vLLM-Omni 配方和 AI Rank 仓库页核对,2026 年 10 月 22 日补充 GitHub 数据,未安装或运行该模型。
封面图片:官方产品素材;由 AI Rank 编辑排版。