简介
- 本项目的目的是拓展Bert-VITS2的使用边界,比如 TTS 同步产生脸部表情数据。
- 效果参见
2025.8 改进
- 输入从 1D 变为 2D:旧模型输入是 [B, C, T] 的一维序列,而新模型输入是 [B, H, W, C] 即 [批次, 频率, 时间, 1] 的二维数据
- 用 Conv2D 替代了 Conv1D 作为特征提取的起点
- 移除了计算量巨大的 Transformer 模块
- 参考Improvement_2025.md
- Demo 2025
扩展到 CosyVoice
扩展到 GPT-SoVITS
- GPT-SoVITS 表情测试
- 直接在 GPT-SoVITS上重新训练,实测结果比较糟糕
- 暂时使用的方法是从 Bert-VITS2-ext 里直接把后验部分以及表情生成部分模型复制到 GPT-SoVITS 里测试。
- 这会导致一次重复的计算,以及更多的预测变差
TTS
-
TTS 代码源自 Bert-VITS2 v2.3 Final Release [ Dec 20, 2023]
-
测试下来,个人感觉纯中文素材的训练效果 2.1-2.3 版本略微不如 1.0,纯中文需求可以考虑降低版本或混合使用。
-
TTS 本身的训练方法见原文(每个版本都有所不同)
TTS 同步输出表情
思路
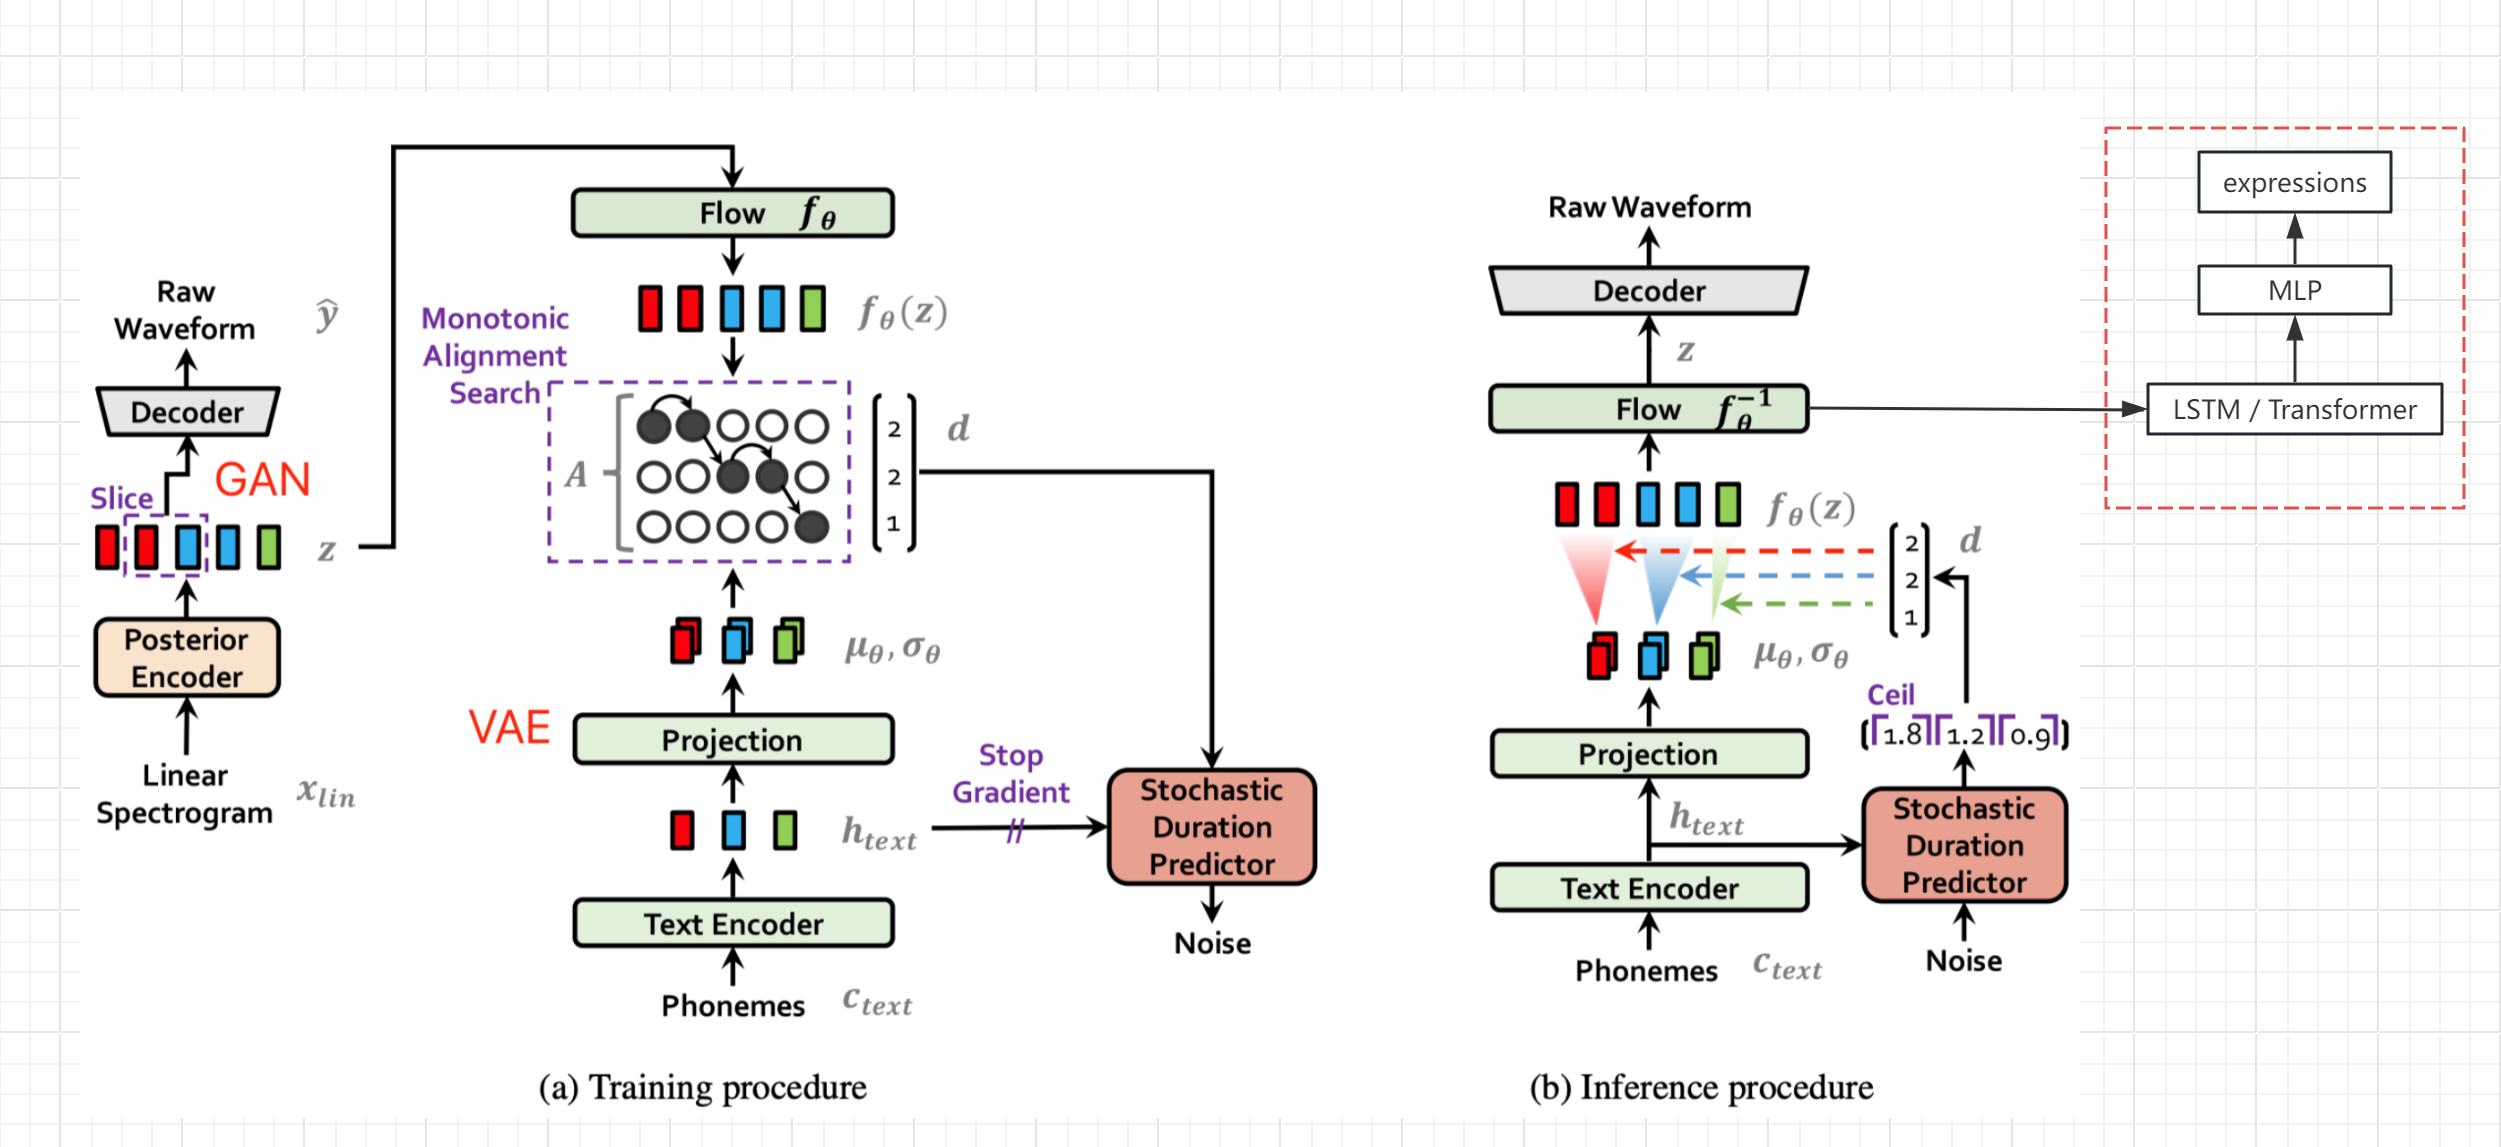
- 参考VITS论文的网络结构图(非 bert-vits2,但大体结构是一样的),获取文本编码及变换后、解码前的隐变量 z,从旁路输出表情值(Live Link Face 数值)
- 冻结原网络的参数,单独增加一路 LSTM 和 MLP 处理,完成 z 到表情的 seq2seq 生成与映射
- 当然如果有高质量的表情数据,也可以把表情也加入原始 TTS 网络训练,应该能提高音频质量
数据采集
- 设置 Live Link Face 的 Targets 为本机 IP,端口默认 11111
- 同步采集语音和对应的 Live Link 输出的表情值,分别存入到 records 文件夹
- 执行一下脚本采集,每次 20 秒
- 音频默认为 44100 Hz
- 音频、表情的采集可能有偏移
- 可对比验证集的损失找到同一数据源的最佳偏移位置
python ./motion/record.py
-
查看数据是否正常
-
测试数据
- 将录下的 bs 数据通过 live link 发给 UE 中的 MetaHuman,同步播放语音,检查是否匹配
python ./motion/tts2ue.py --bs_npy_file ./records/2023-12-23-17-19-54.npy --wav_file ./records/2023-12-23-17-19-54.wav --fps 60
数据预处理
- 读取 records 中的所有音频文件,利用后验编码器,把音频编码后的隐变量 z 存入 *.z.npy
- 写入训练和验证用的文件列表
- filelists/val_visemes.list
- filelists/train_visemes.list
python ./motion/prepare_visemes.py
训练
- 在 train_ms.py 后加上--visemes 来区别和主网的训练
python train_ms.py -m OUTPUT_MODEL --config ./configs/config.json --visemes
推理
- 在 webui.py 执行时,将输出的音频、隐变量、动画数据写入当前目录,可用 tts2ue.py 来查看生成效果
- 生成的动画默认的 fps 是和隐变量一样的 86.1328125
- 44100/86.1328125 = 512,刚好整除,这是 Bert-VITS2 音频采样频率、网络结构和 hidden_channels 决定的
python ./motion/tts2ue.py --bs_npy_file ./tmp.npy --wav_file ./tmp.wav --delay_ms 700
声音到表情
- 利用后验编码器,把声音转换成 z,然后再把 z 转成表情
- 音频需转成 44100hz 的 wav 文件,并只保留一个通道(ffmpeg)
# 音频截取转换
ffmpeg -i input_file -ss 00:00:00 -t 00:00:10 -ar 44100 -f wav test.wav

# 保留通道1
ffmpeg -i test.wav -map_channel 0.0.0 output.wav

python  ./motion/wav_to_visemes.py output.wav
身体动画
MotionGPT
- 有了语音和表情后,还可以在 LLM 驱动下产生与之匹配的动作描述,然后用 text to motion 模型生成与说话内容匹配的身体动画,甚至和场景、他人进行交互。
- text to motion 测试采用的项目是 MotionGPT
- 暂未做动画过度处理,看介绍模型是支持的 motion in-between
- MotionGPT 用的 flan-t5-base,不能理解中文,所以无法用说话的文本产生同步度很高的动画(翻译成英文后语序多少有些变化)
- 是否可以用说话的文本或隐变量 z 来指导动作生成暂未可知
- MotionGPT 输出的是骨骼位置,与 UE 的骨骼动画不能直接对接
audio2photoreal
- 在原项目的基础上修改,Web 界面推理时导出动画数据到本地文件
Bert-VITS2 原版声明
VITS2 Backbone with multilingual bert
For quick guide, please refer to webui_preprocess.py.
简易教程请参见 webui_preprocess.py。
请注意,本项目核心思路来源于anyvoiceai/MassTTS 一个非常好的 tts 项目
MassTTS 的演示 demo 为ai 版峰哥锐评峰哥本人,并找回了在金三角失落的腰子
成熟的旅行者/开拓者/舰长/博士/sensei/猎魔人/喵喵露/V 应当参阅代码自己学习如何训练。
严禁将此项目用于一切违反《中华人民共和国宪法》,《中华人民共和国刑法》,《中华人民共和国治安管理处罚法》和《中华人民共和国民法典》之用途。
严禁用于任何政治相关用途。
Video:https://www.bilibili.com/video/BV1hp4y1K78E
Demo:https://www.bilibili.com/video/BV1TF411k78w
References
- anyvoiceai/MassTTS
- jaywalnut310/vits
- p0p4k/vits2_pytorch
- svc-develop-team/so-vits-svc
- PaddlePaddle/PaddleSpeech
- emotional-vits
- fish-speech
- Bert-VITS2-UI