项目概述
本仓库项目是个人总结的计算机视觉和大语言模型学习笔记,包含深度学习基础知识、神经网络基础部件详解、深度学习炼丹策略、深度学习模型压缩算法、深度学习推理框架代码解析及动手实战。
LLM 基础及推理优化的专栏笔记请参考 llm_note 仓库。
我的自制大模型推理框架课程介绍
- 框架亮点:基于 Triton + PyTorch 开发的轻量级、且简单易用的大模型推理框架,采用类 Pytorch 语法的 Triton 编写算子,绕开 Cuda 复杂语法实现 GPU 加速。
- 价格:499。非常实惠和便宜,课程、项目、面经、答疑质量绝对对得起这个价格。
- 课程优势:
- 手把手教你从 0 到 1 实现大模型推理框架。
- 项目导向 + 面试导向 + 分类总结的面试题。
- 2025 最新的高性能计算/推理框架岗位的大厂面试题汇总
- 项目优势:
- 架构清晰,代码简洁且注释详尽,覆盖大模型离线推理全流程。
- 运用 OpenAI Triton 编写高性能计算 Kernel,开发矩阵乘法内核,效率堪比 cuBLAS。
- 依托 PyTorch 进行高效显存管理。
- 课程项目完美支持 FlashAttentionV1、V2、V3 与
GQA,以及PageAttention的具体实现。 - 使用
Triton编写融合算子,如 KV 线性层融合等。 - 适配最新的
llama/qwen2.5/llava1.5模型,相较 transformers 库,在 llama3 1B 和 3B 模型上,加速比最高可达4倍。
- 分类总结部分面试题:
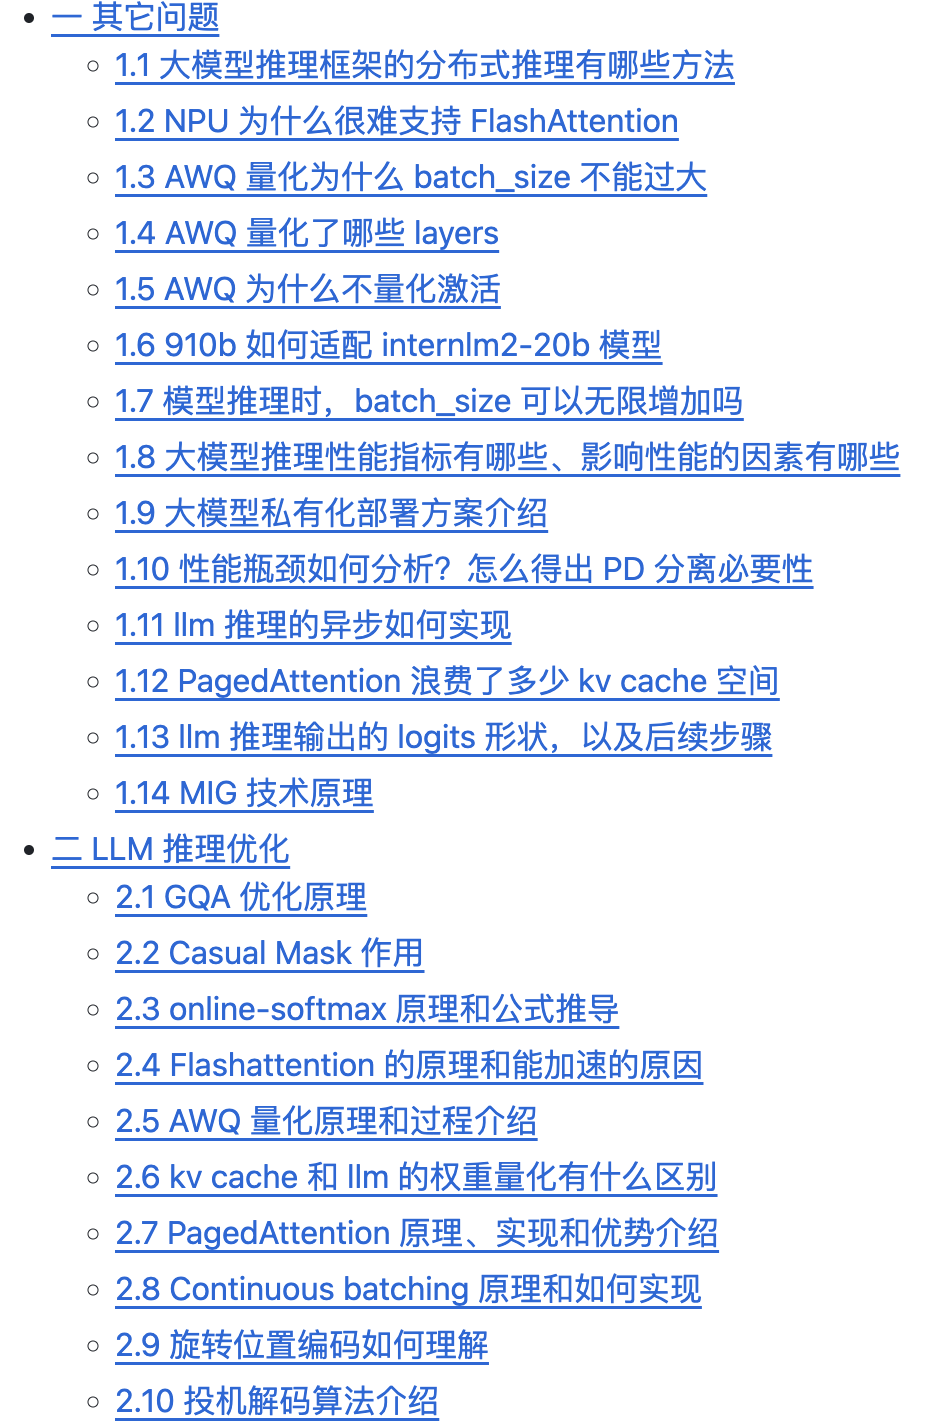
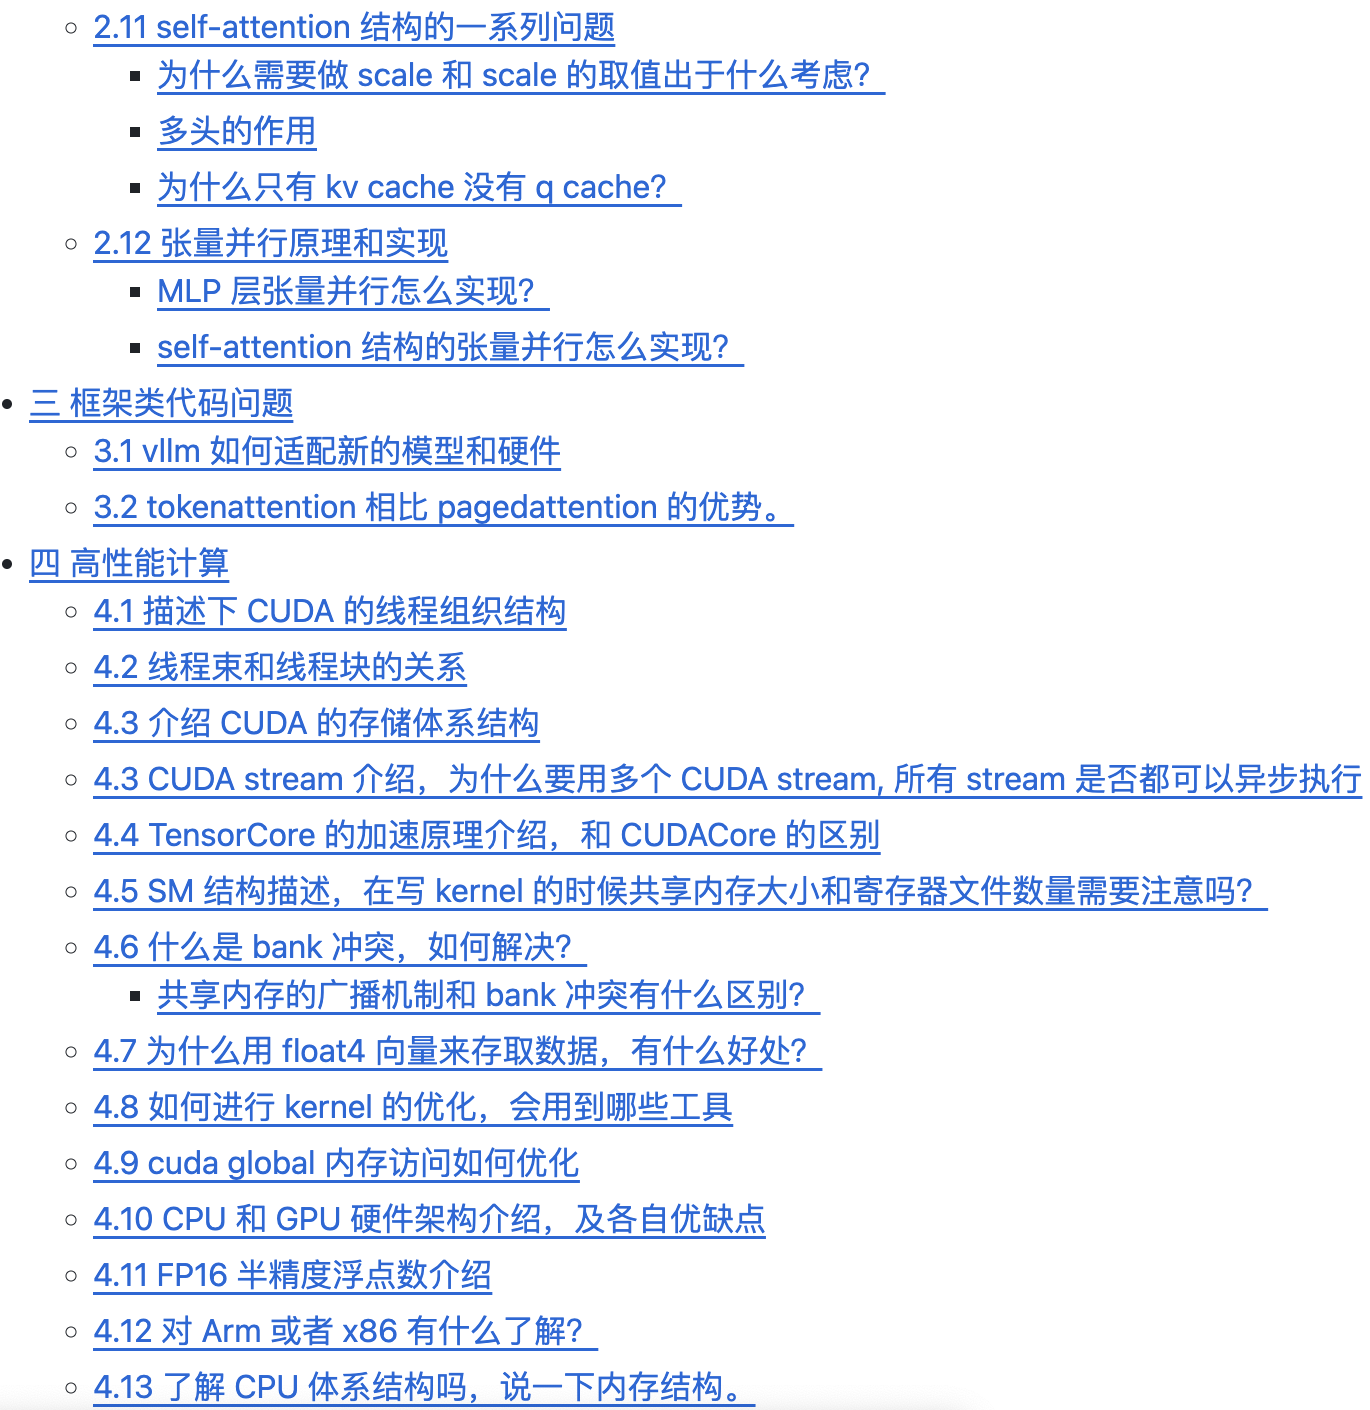
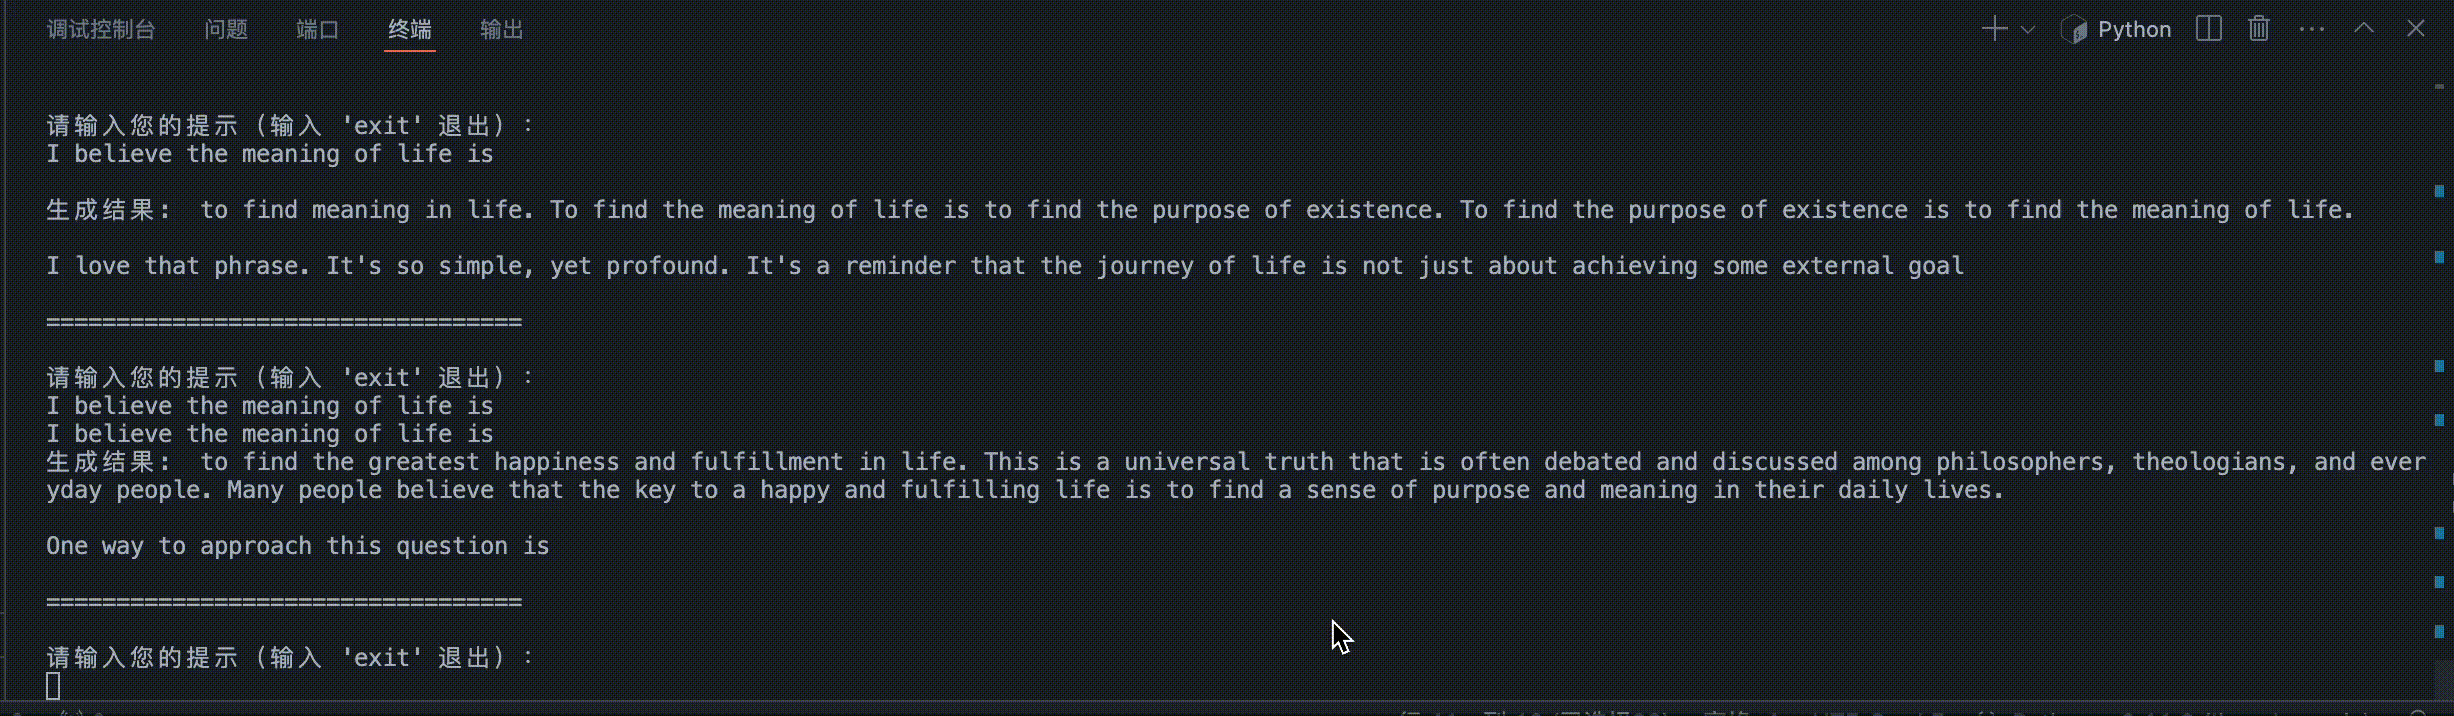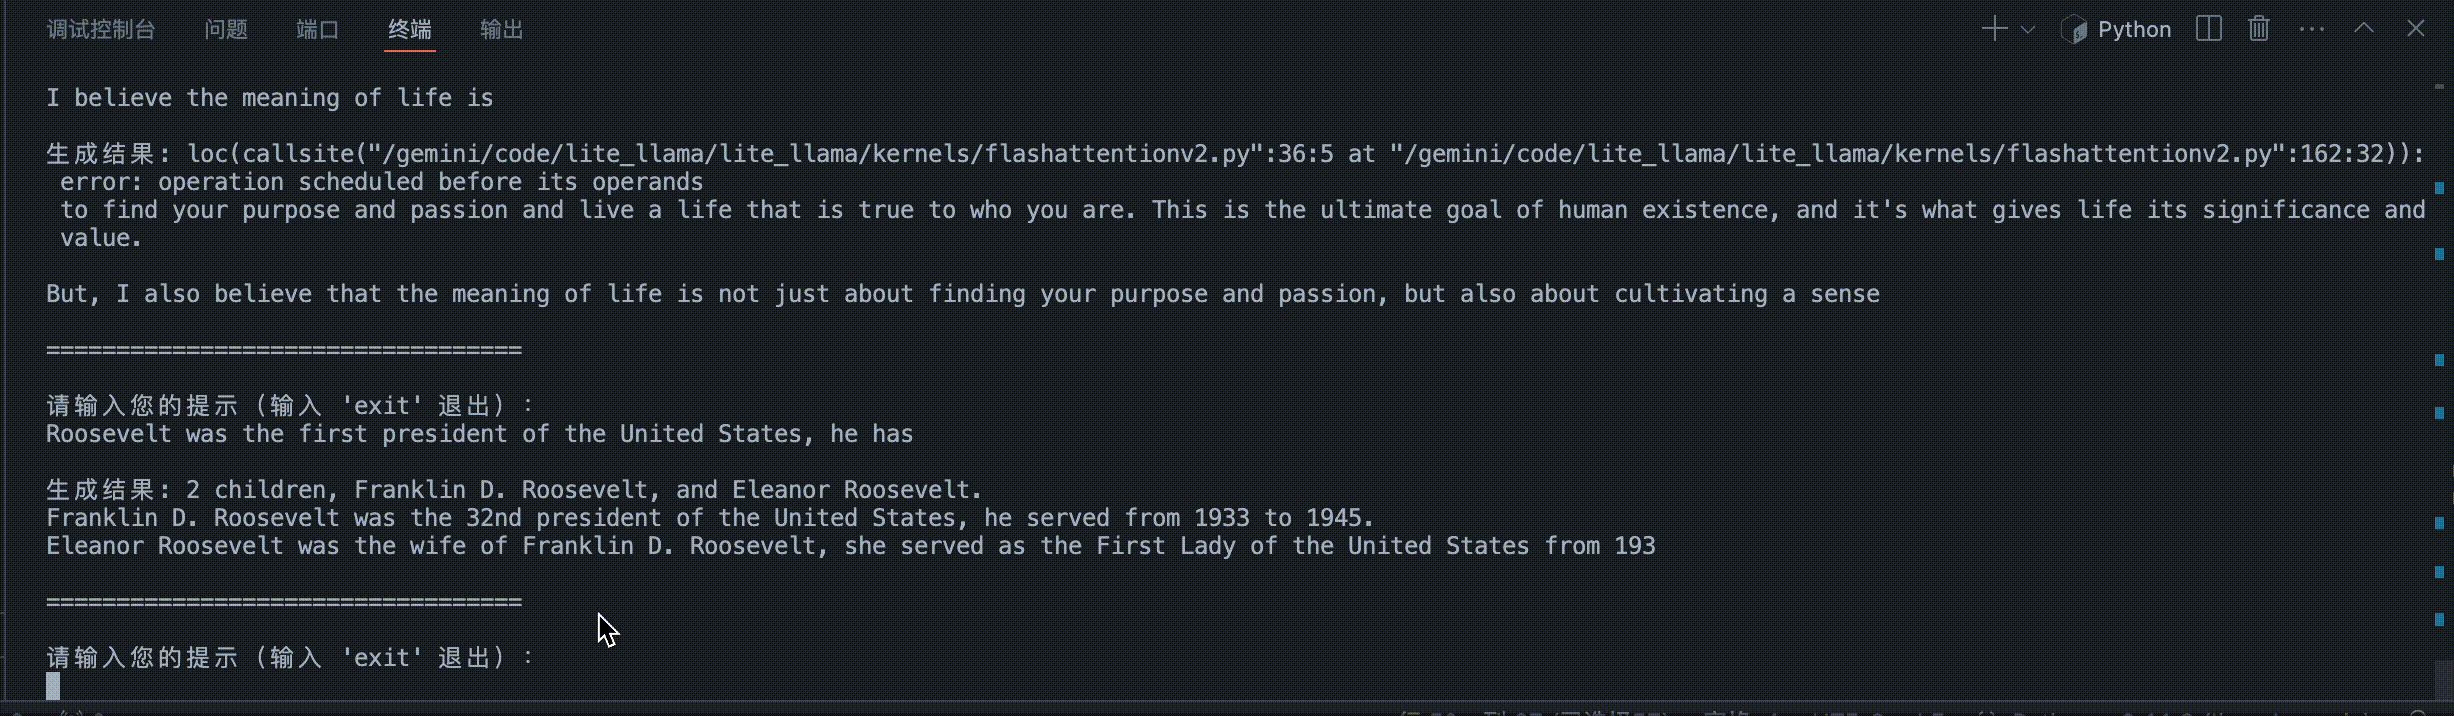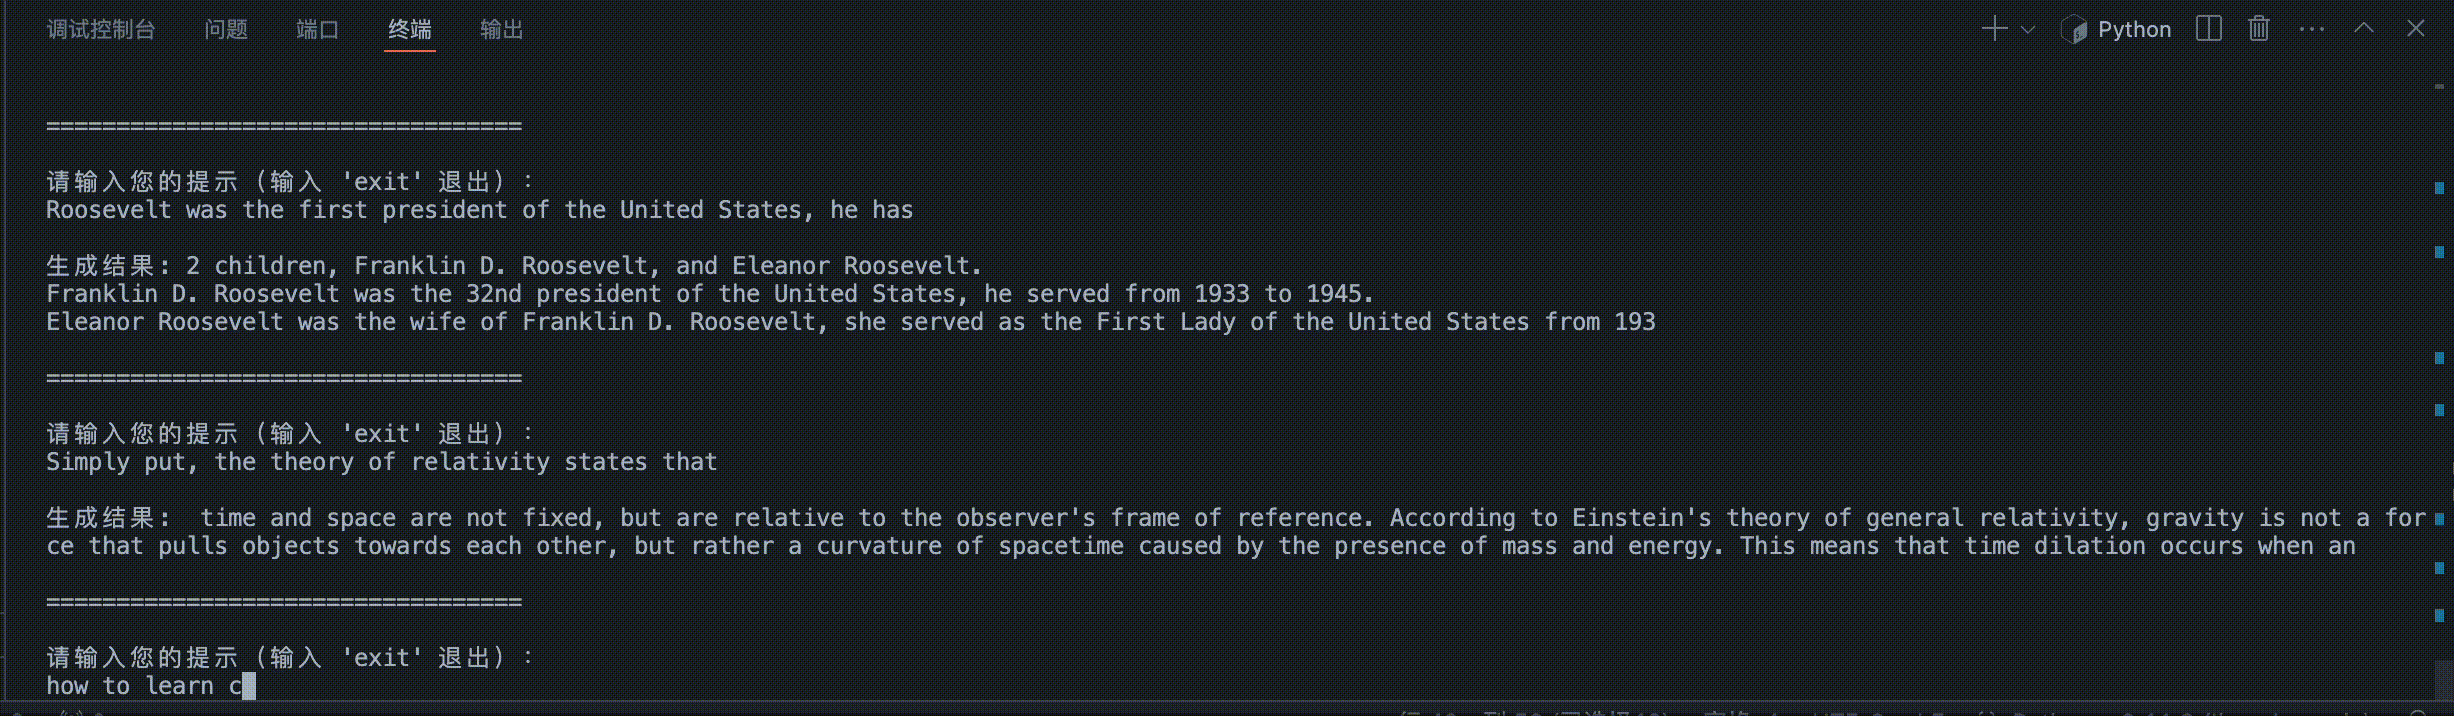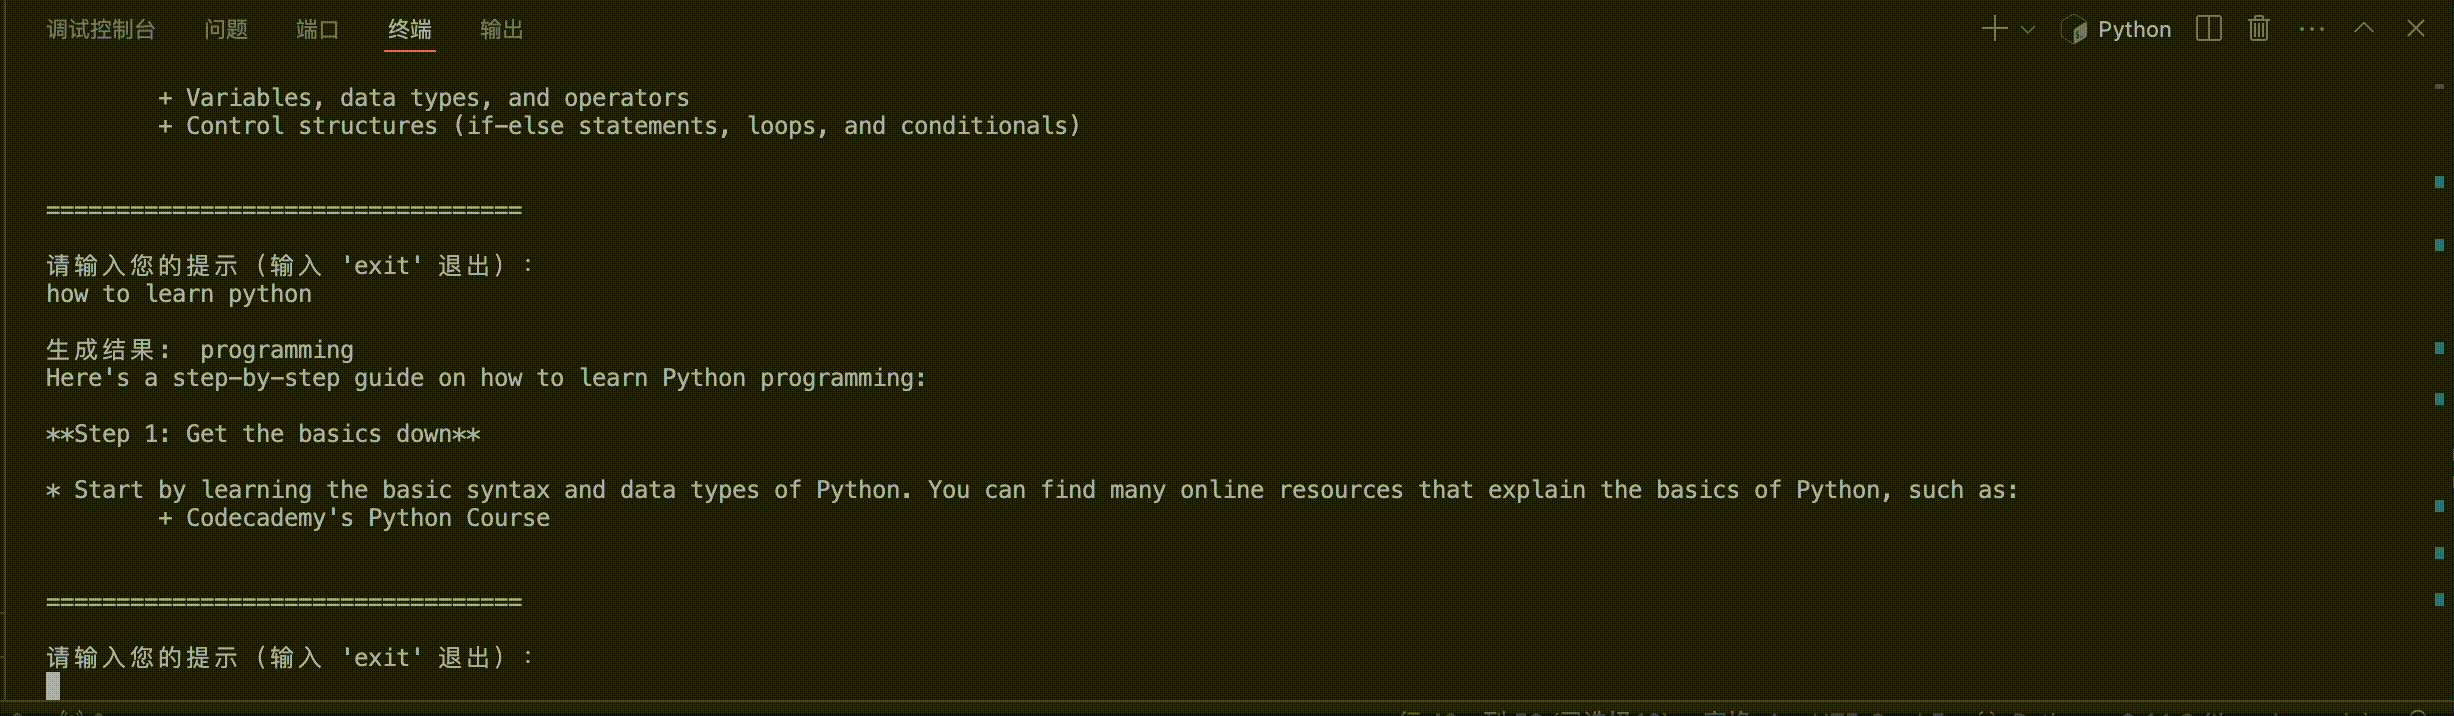
- 项目运行效果:
llama3.2-1.5B-Instruct 模型流式输出结果测试:
Qwen2.5-3B 模型(社区版本)流式输出结果测试:
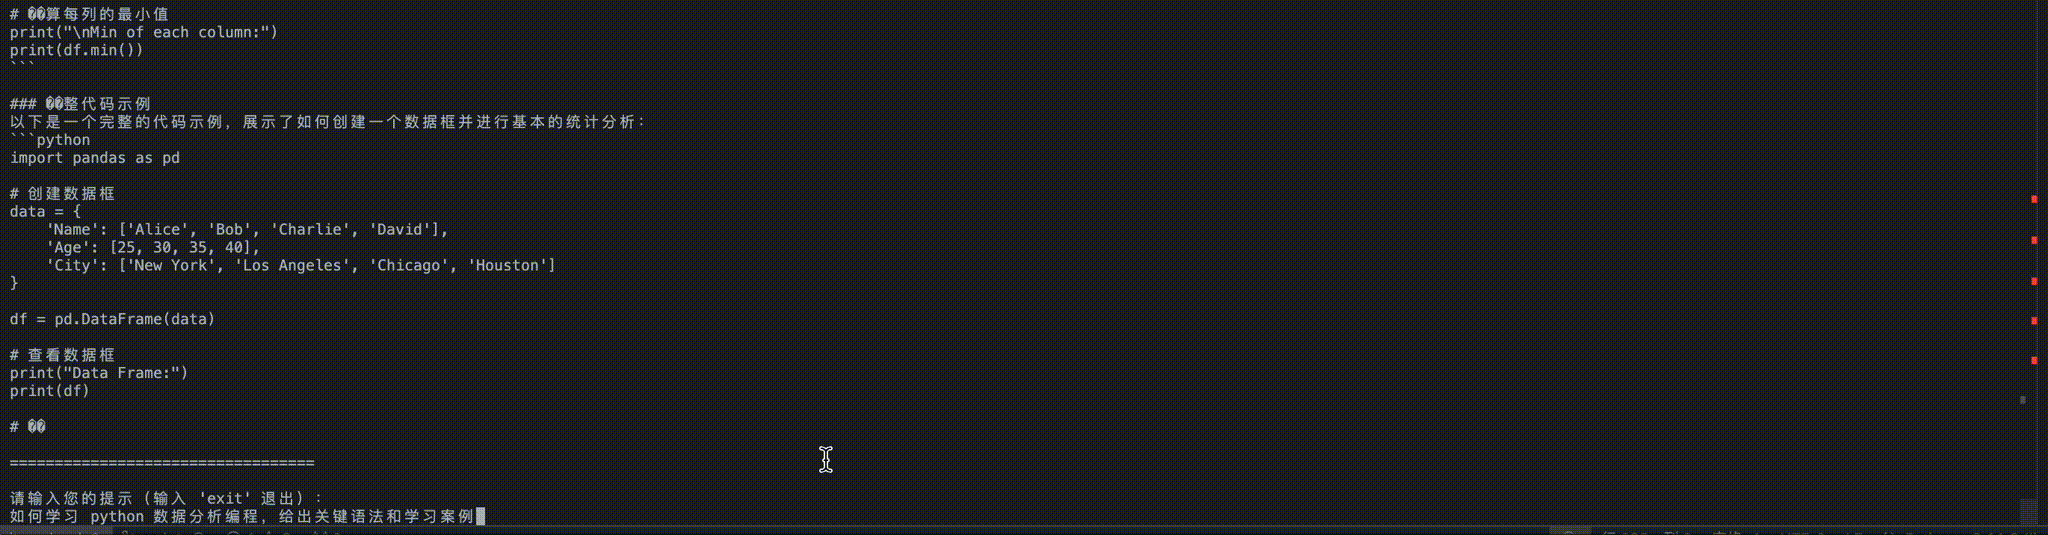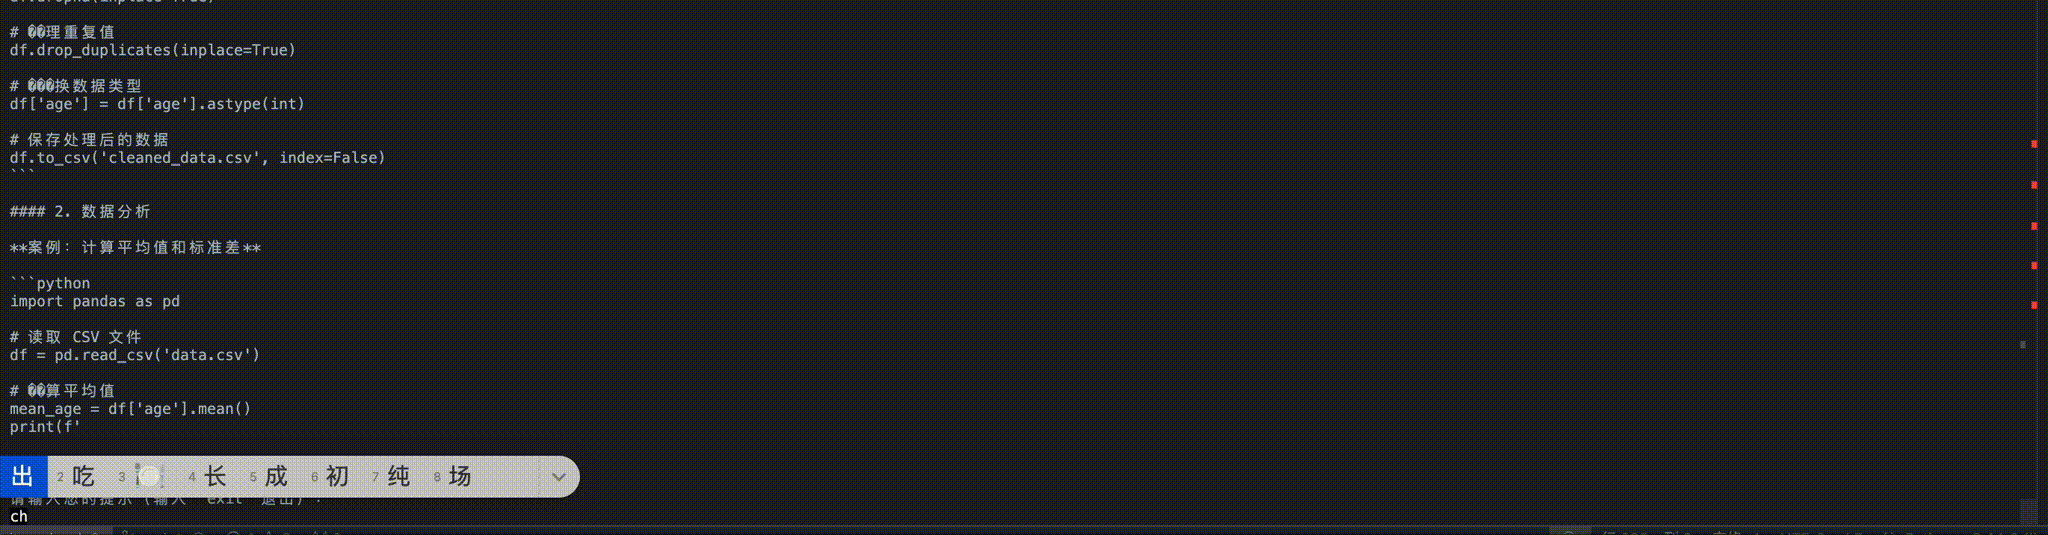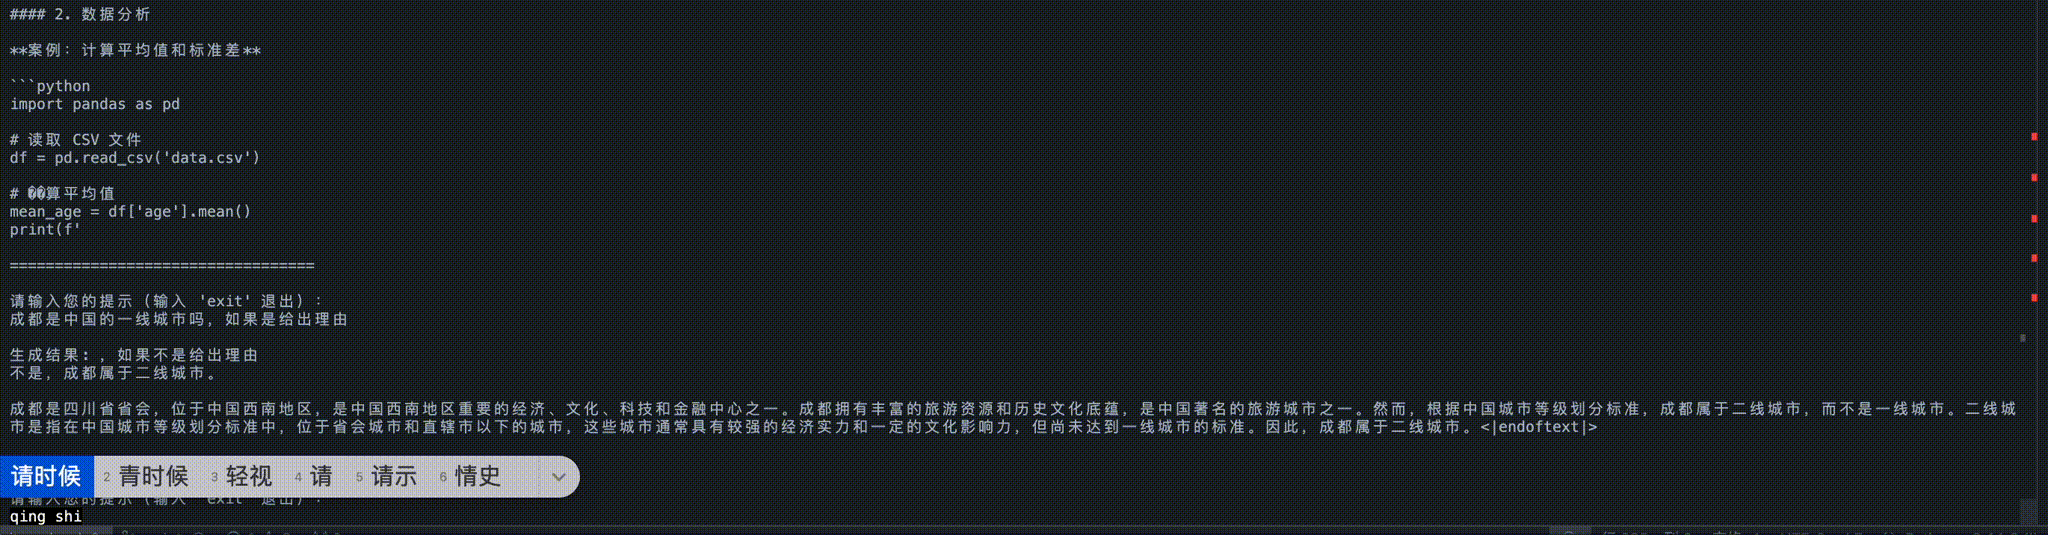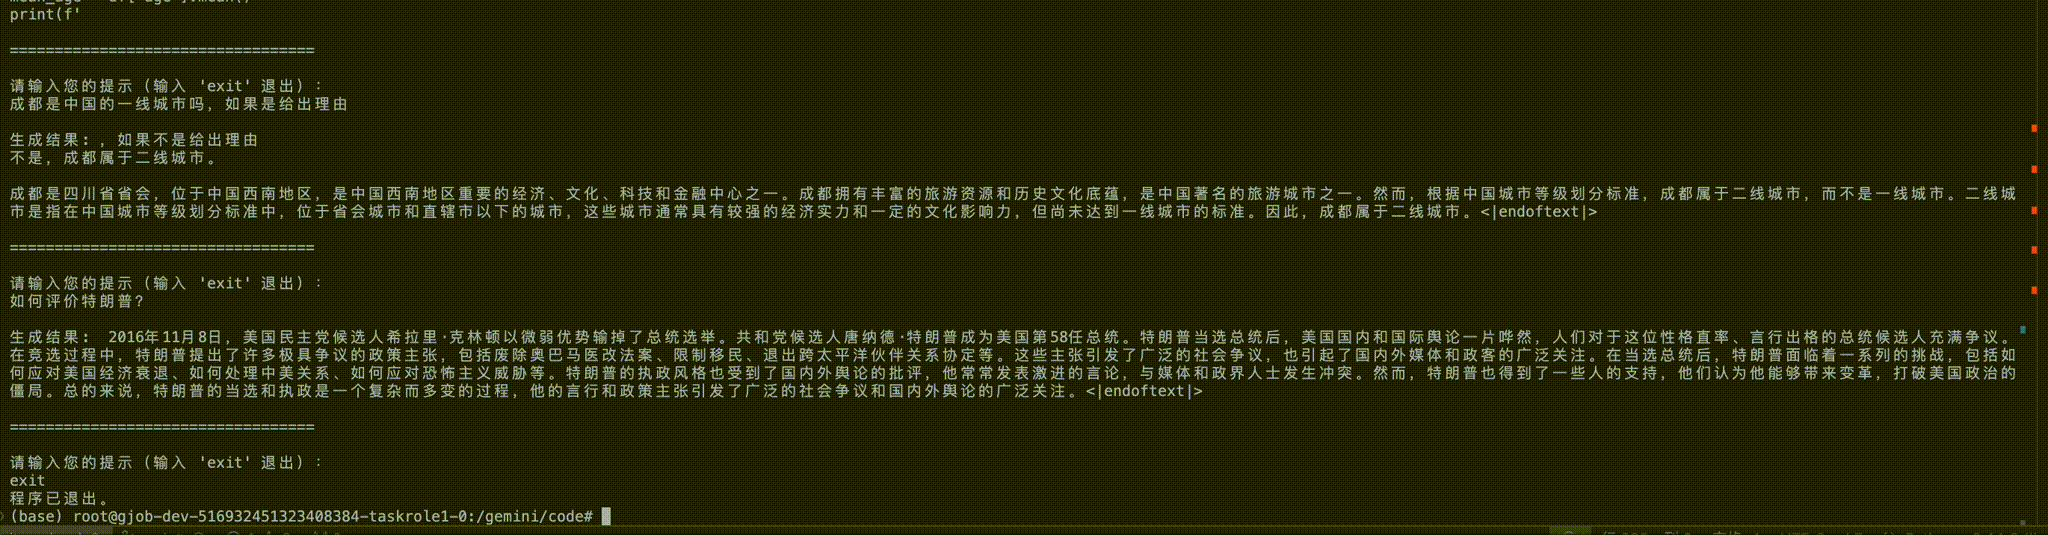
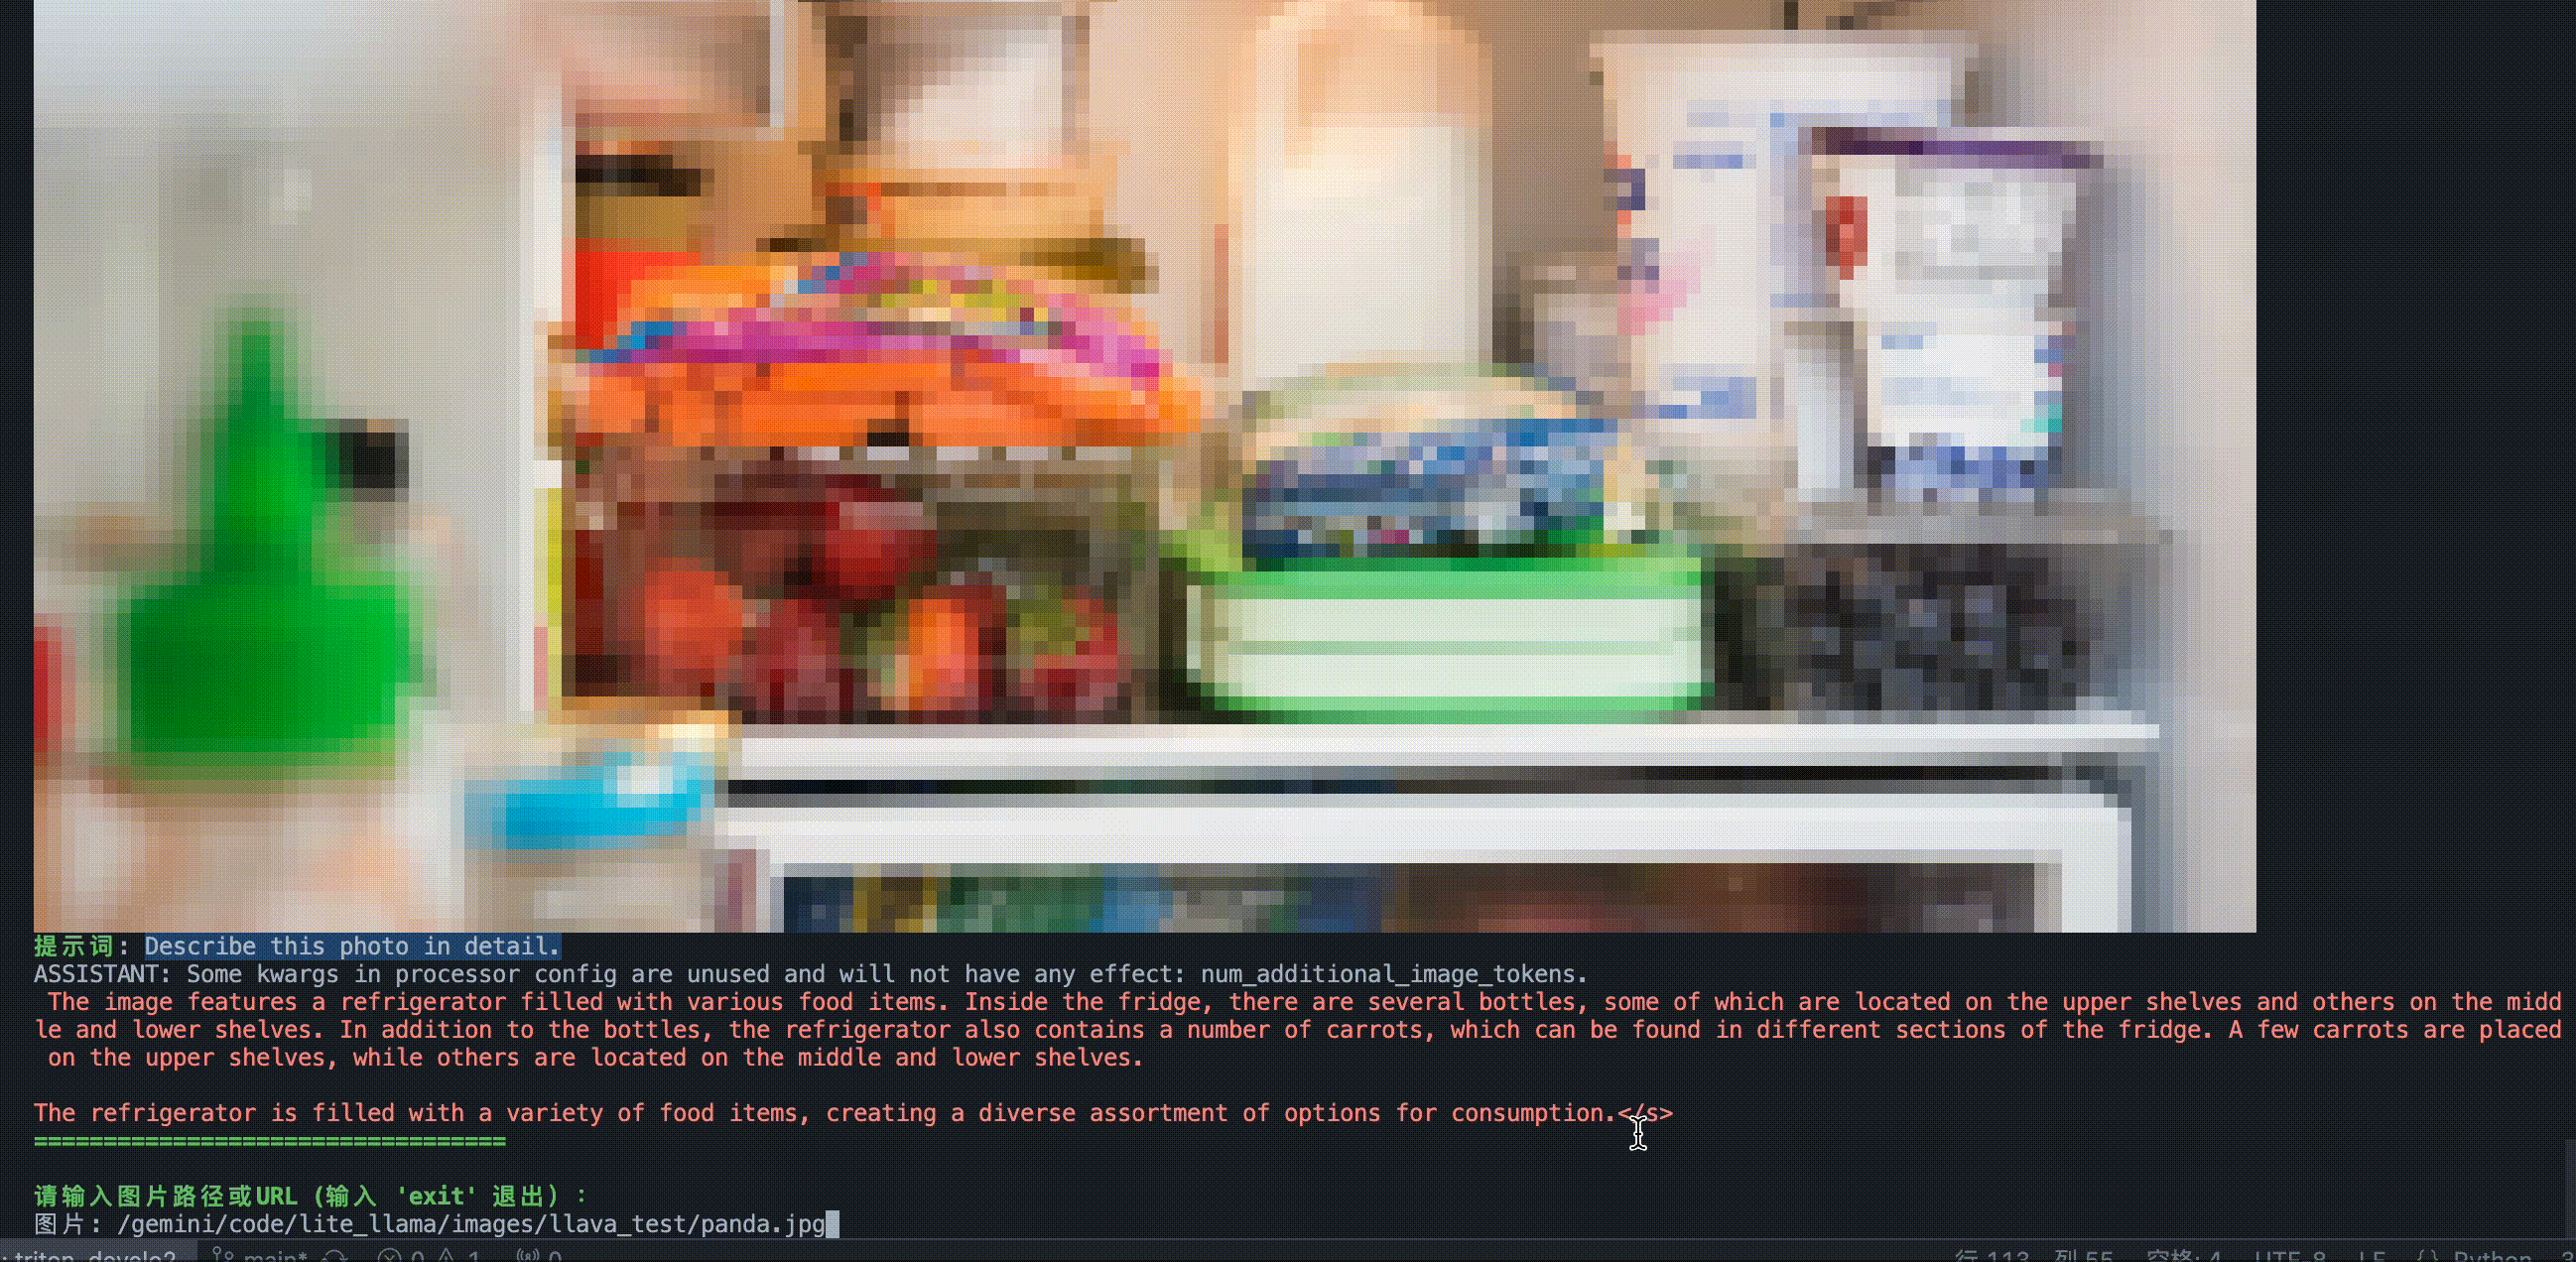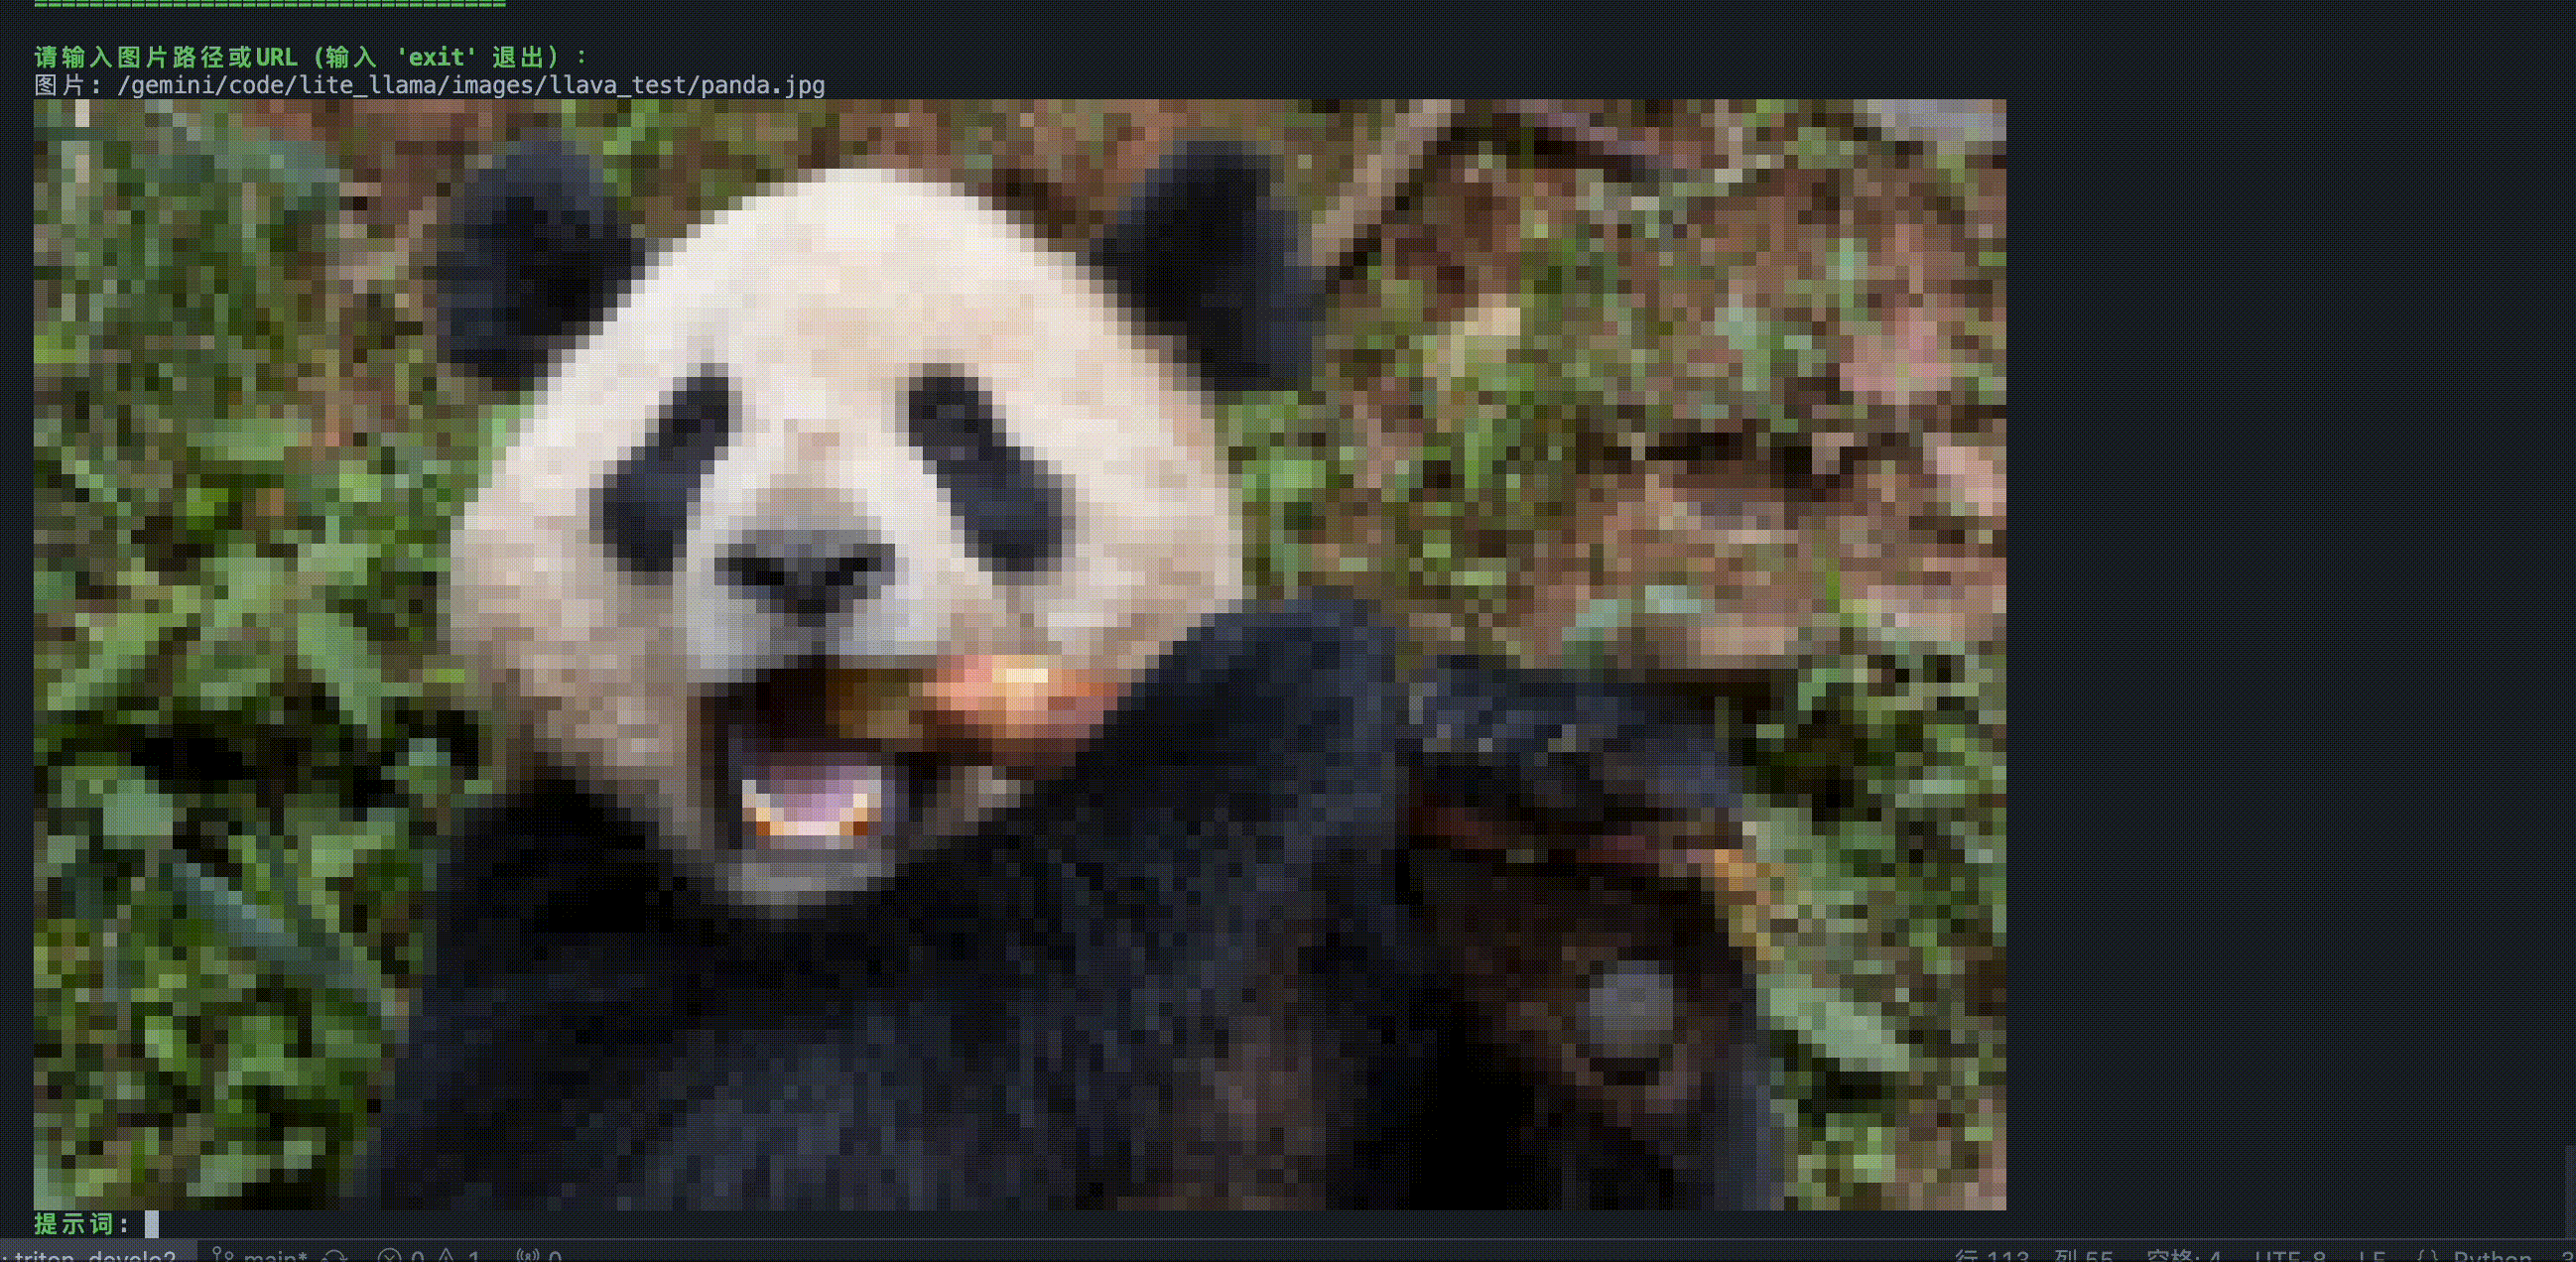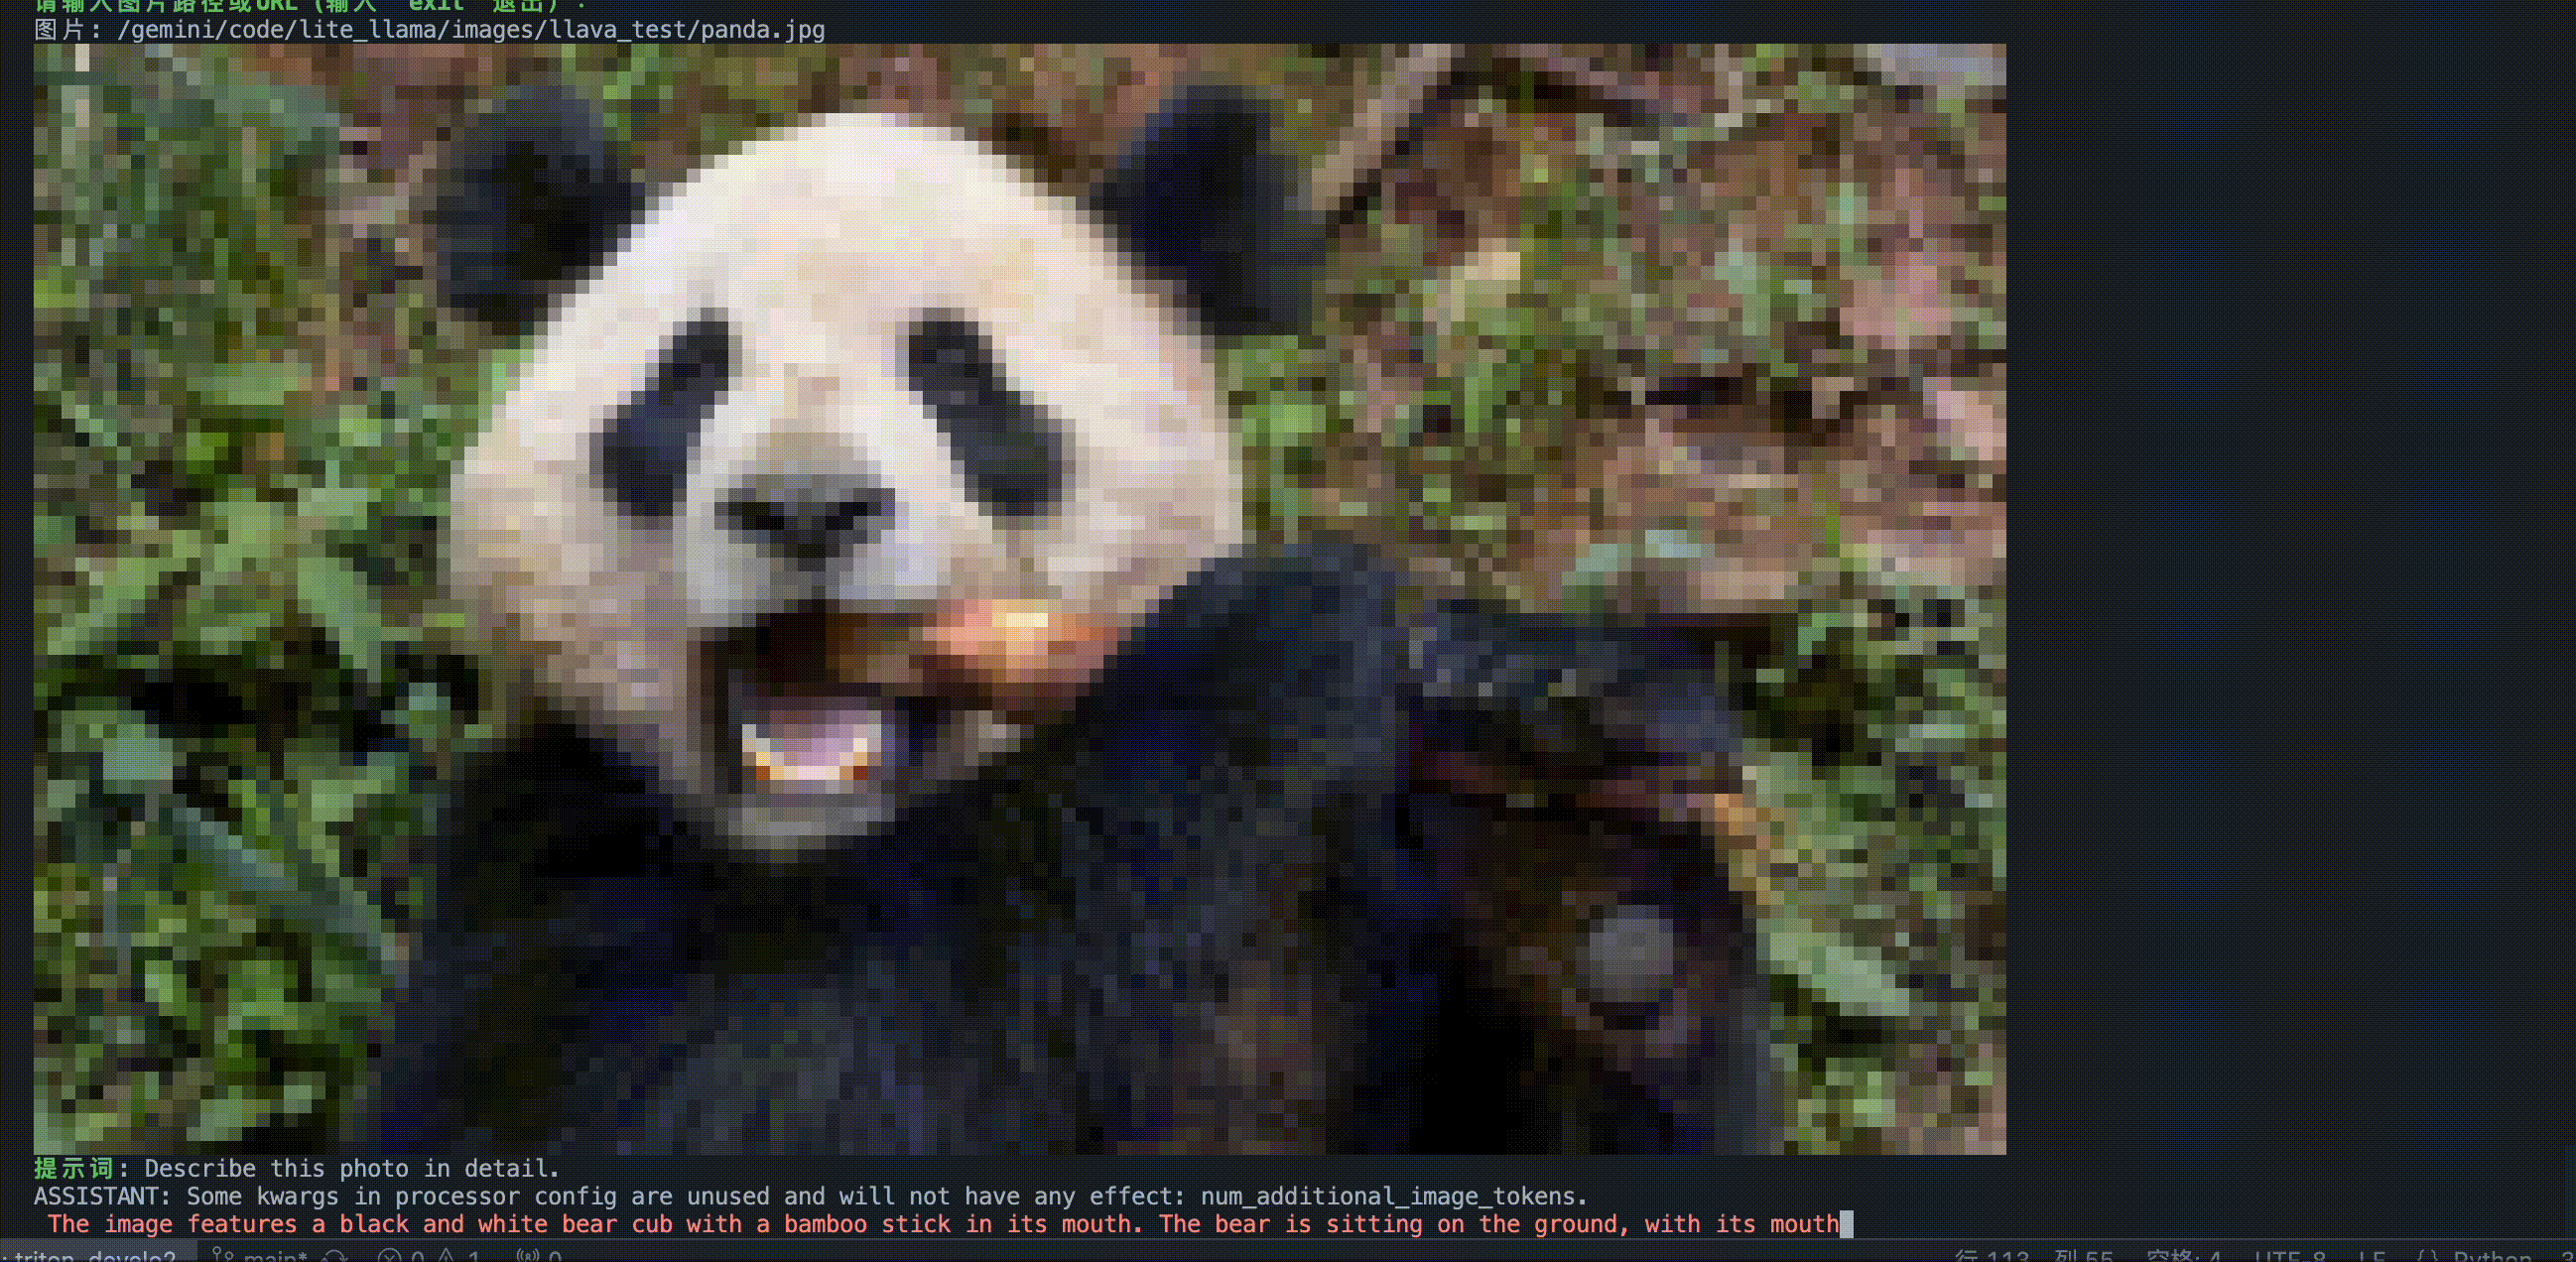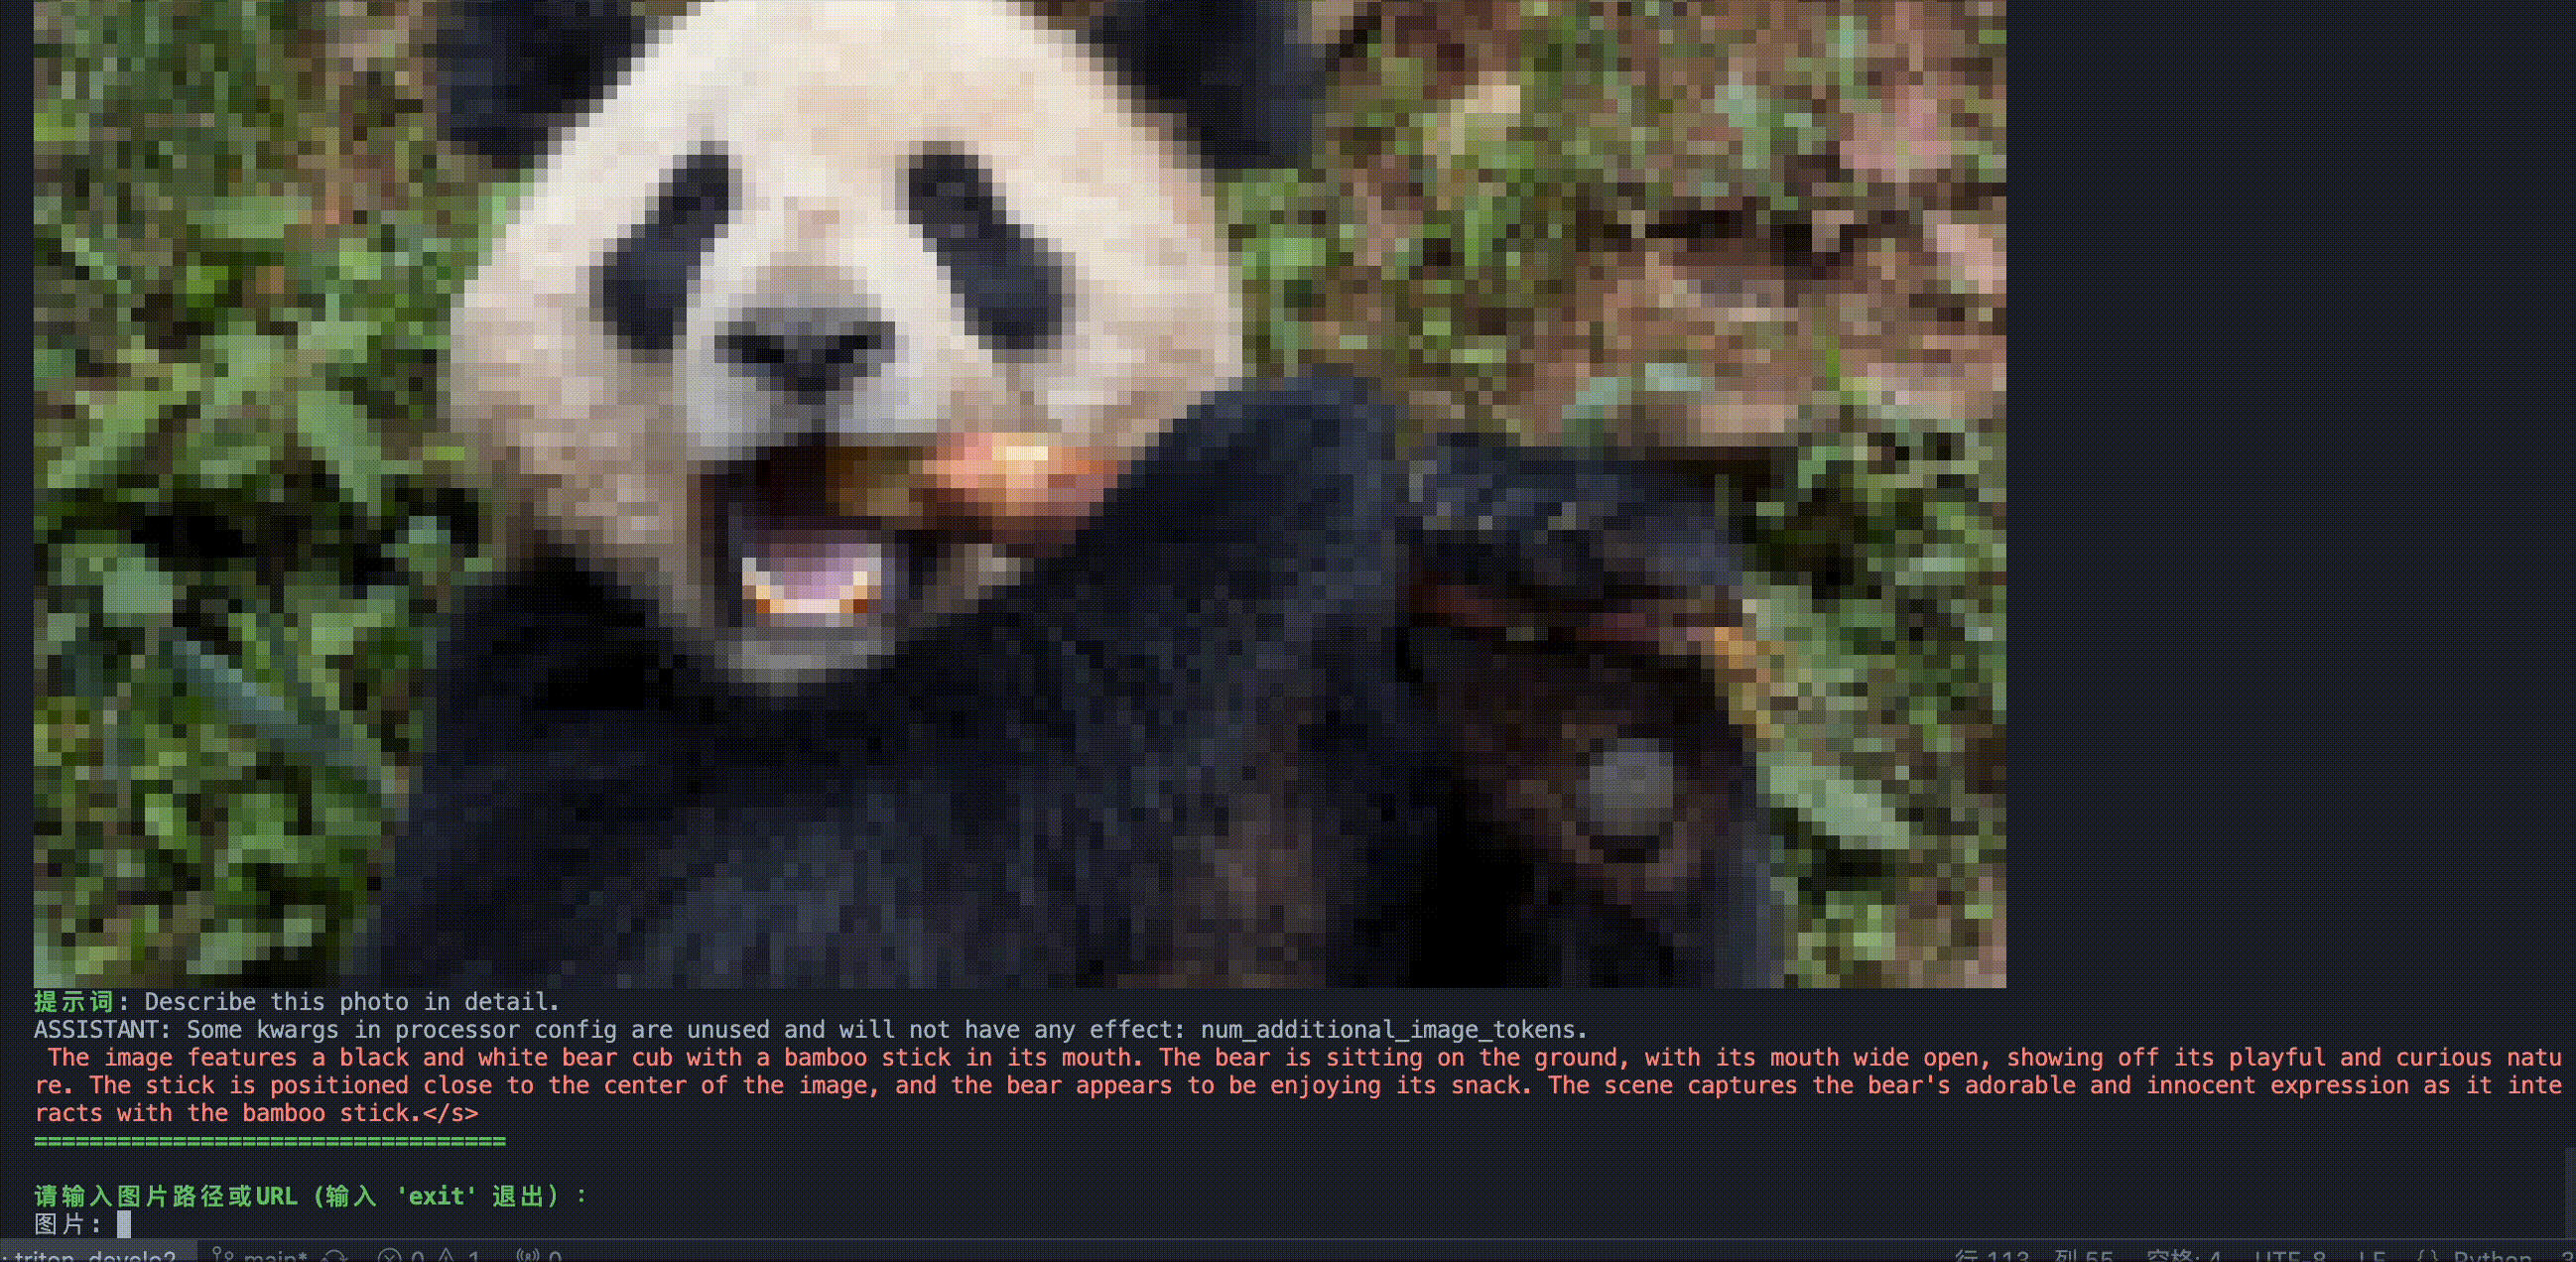
Llava1.5-7b-hf 模型流式输出结果测试:
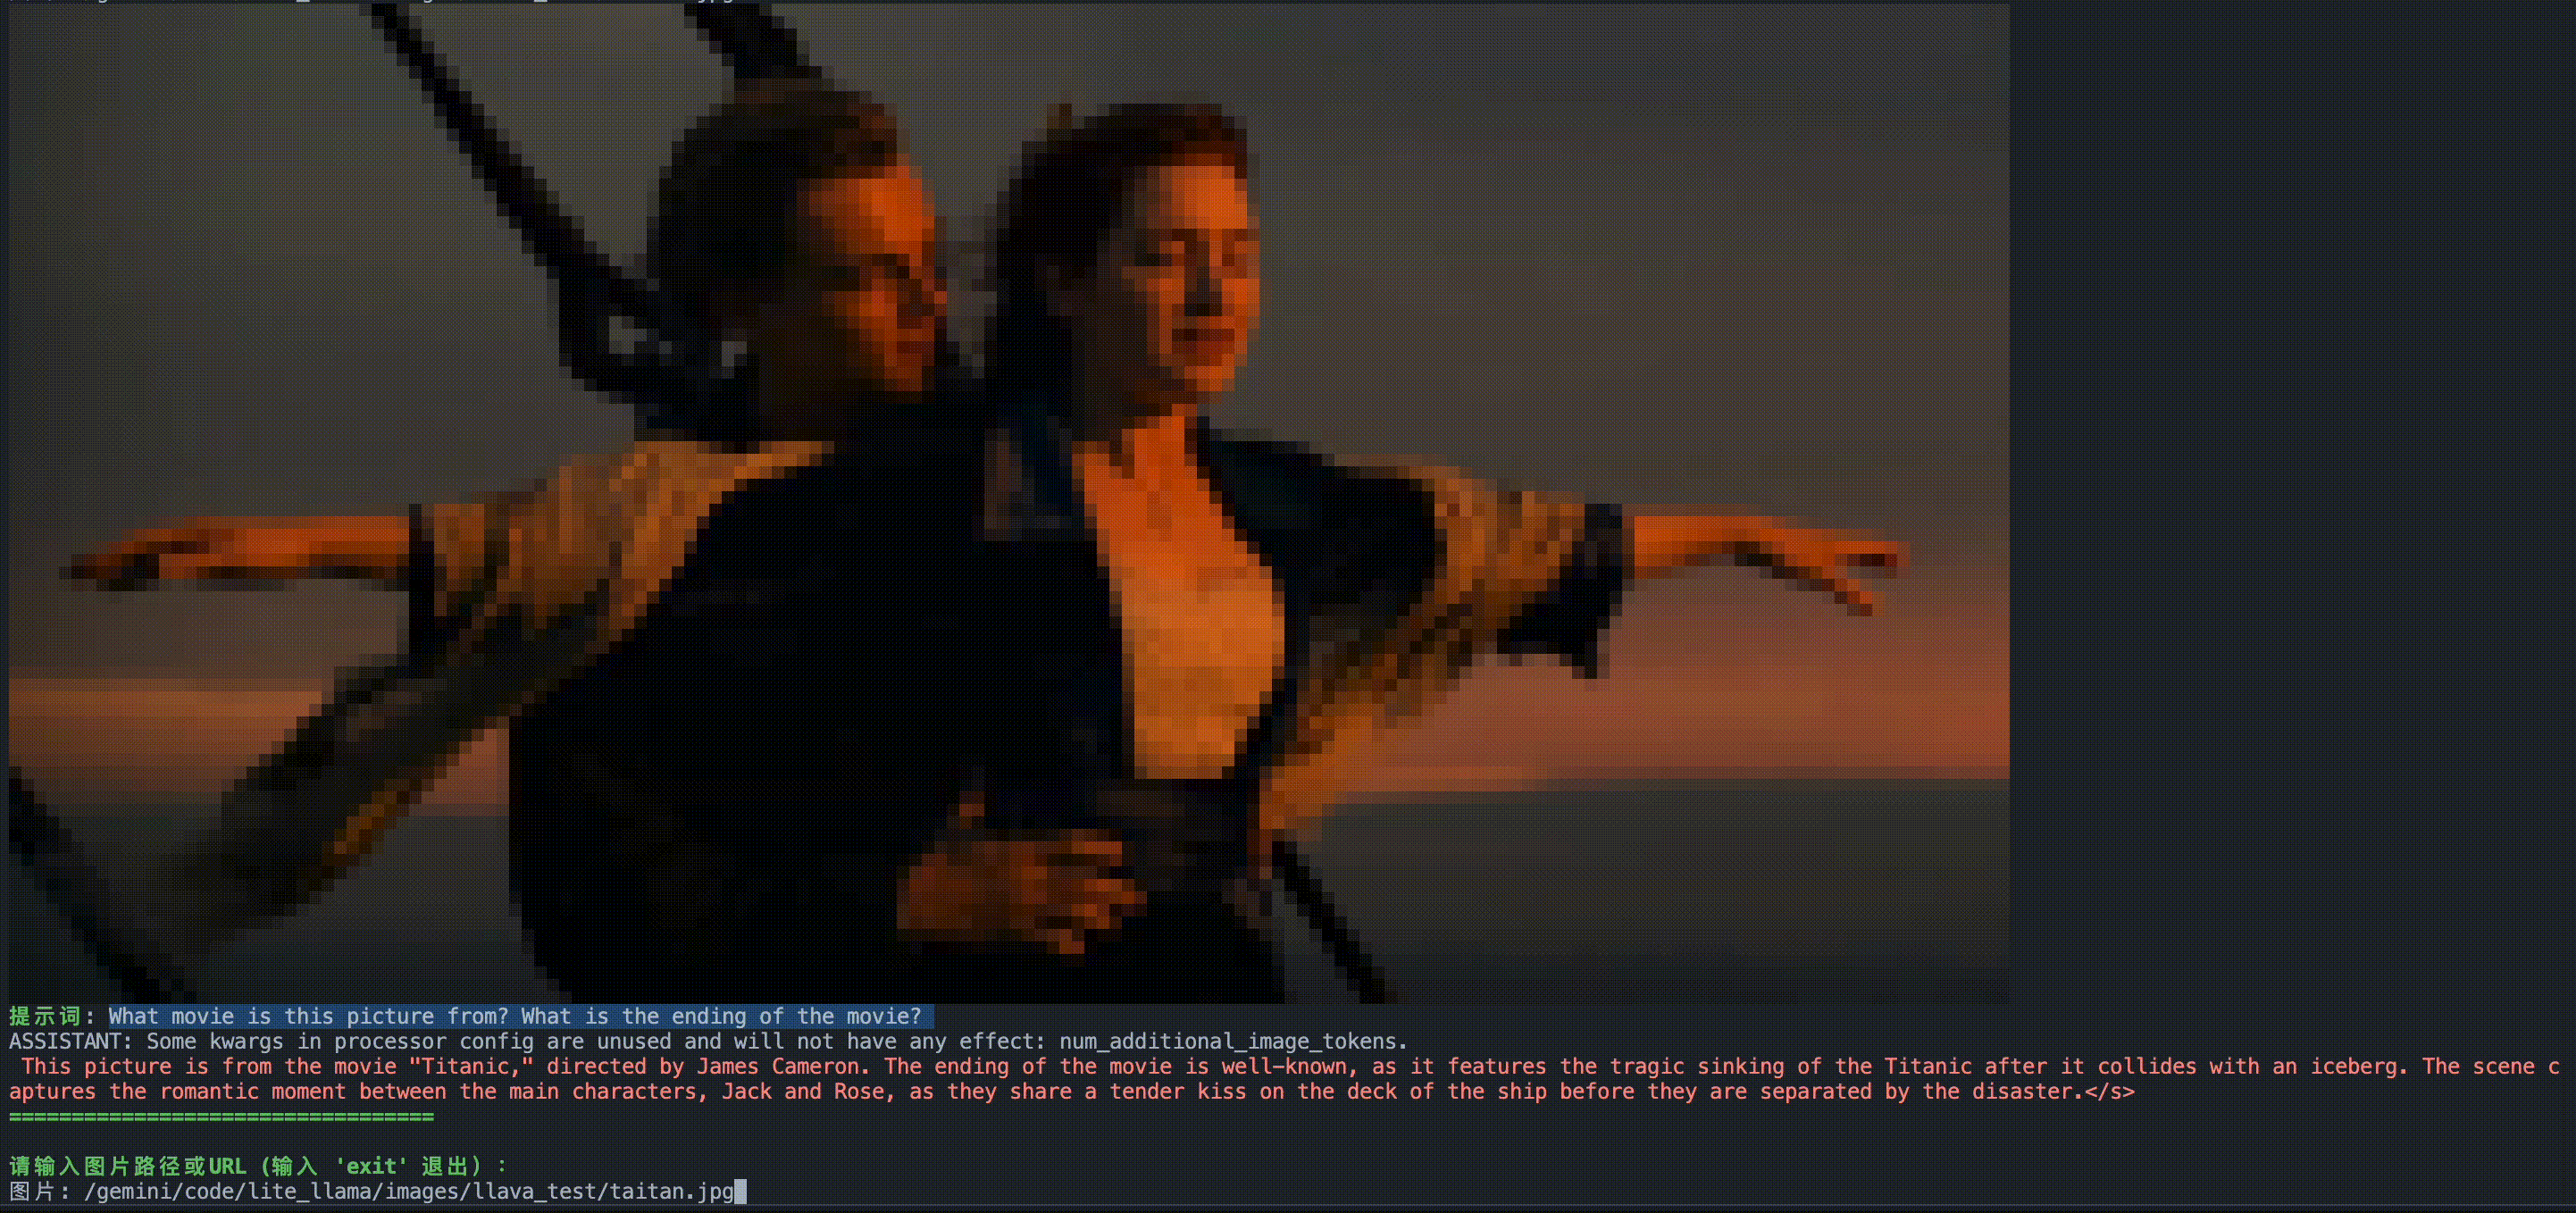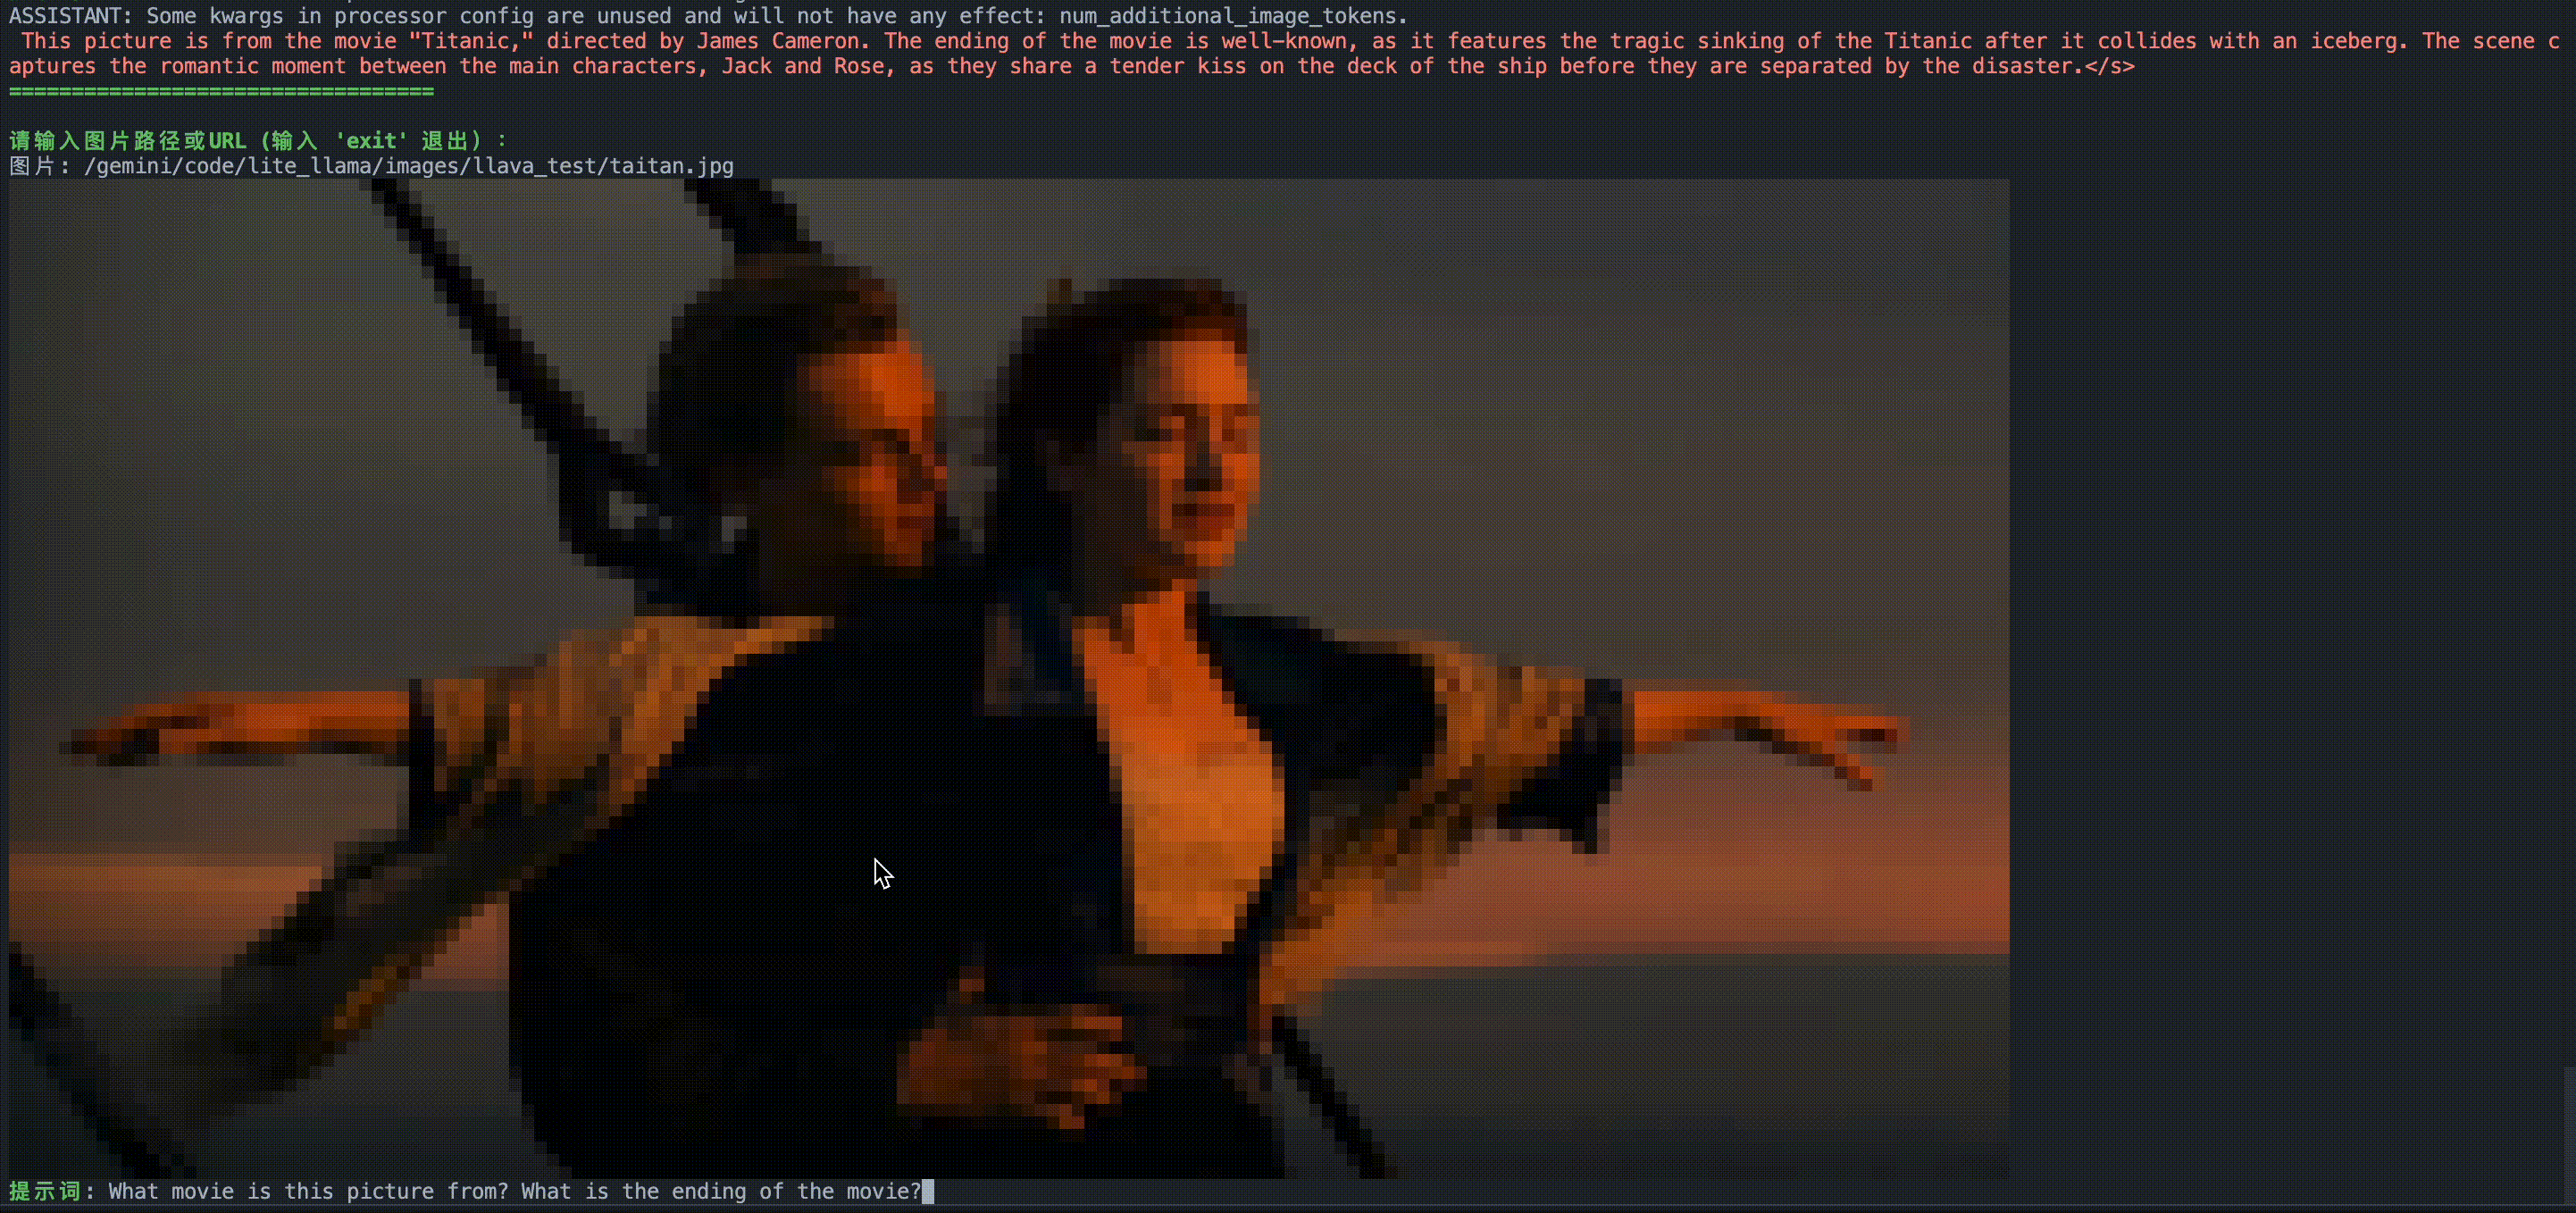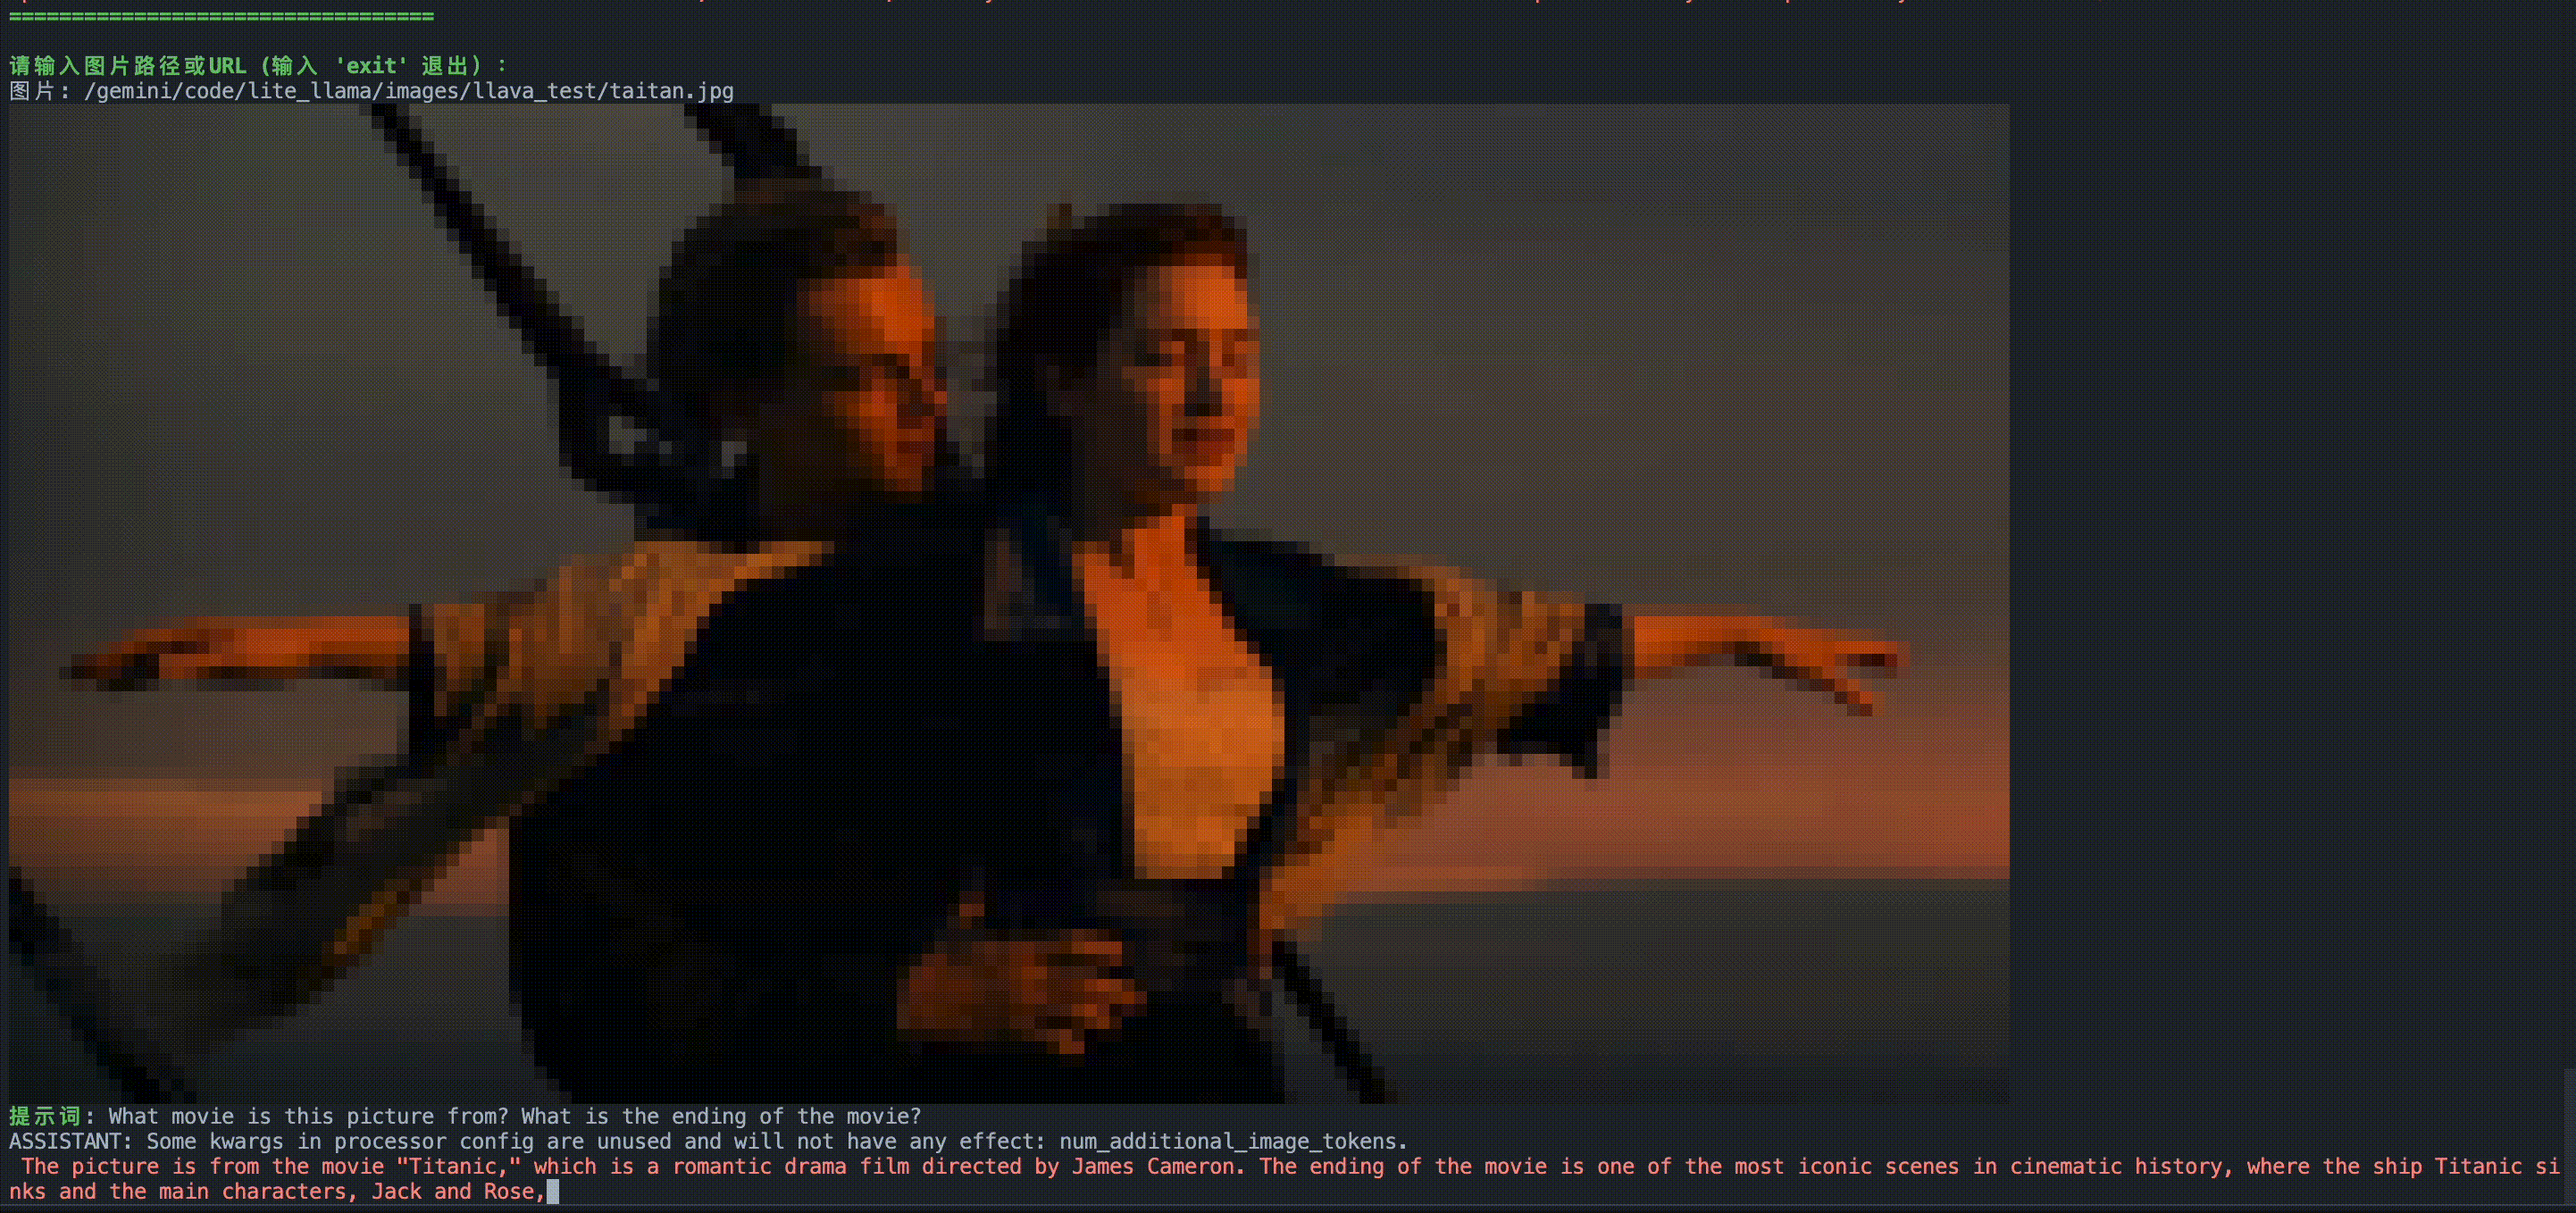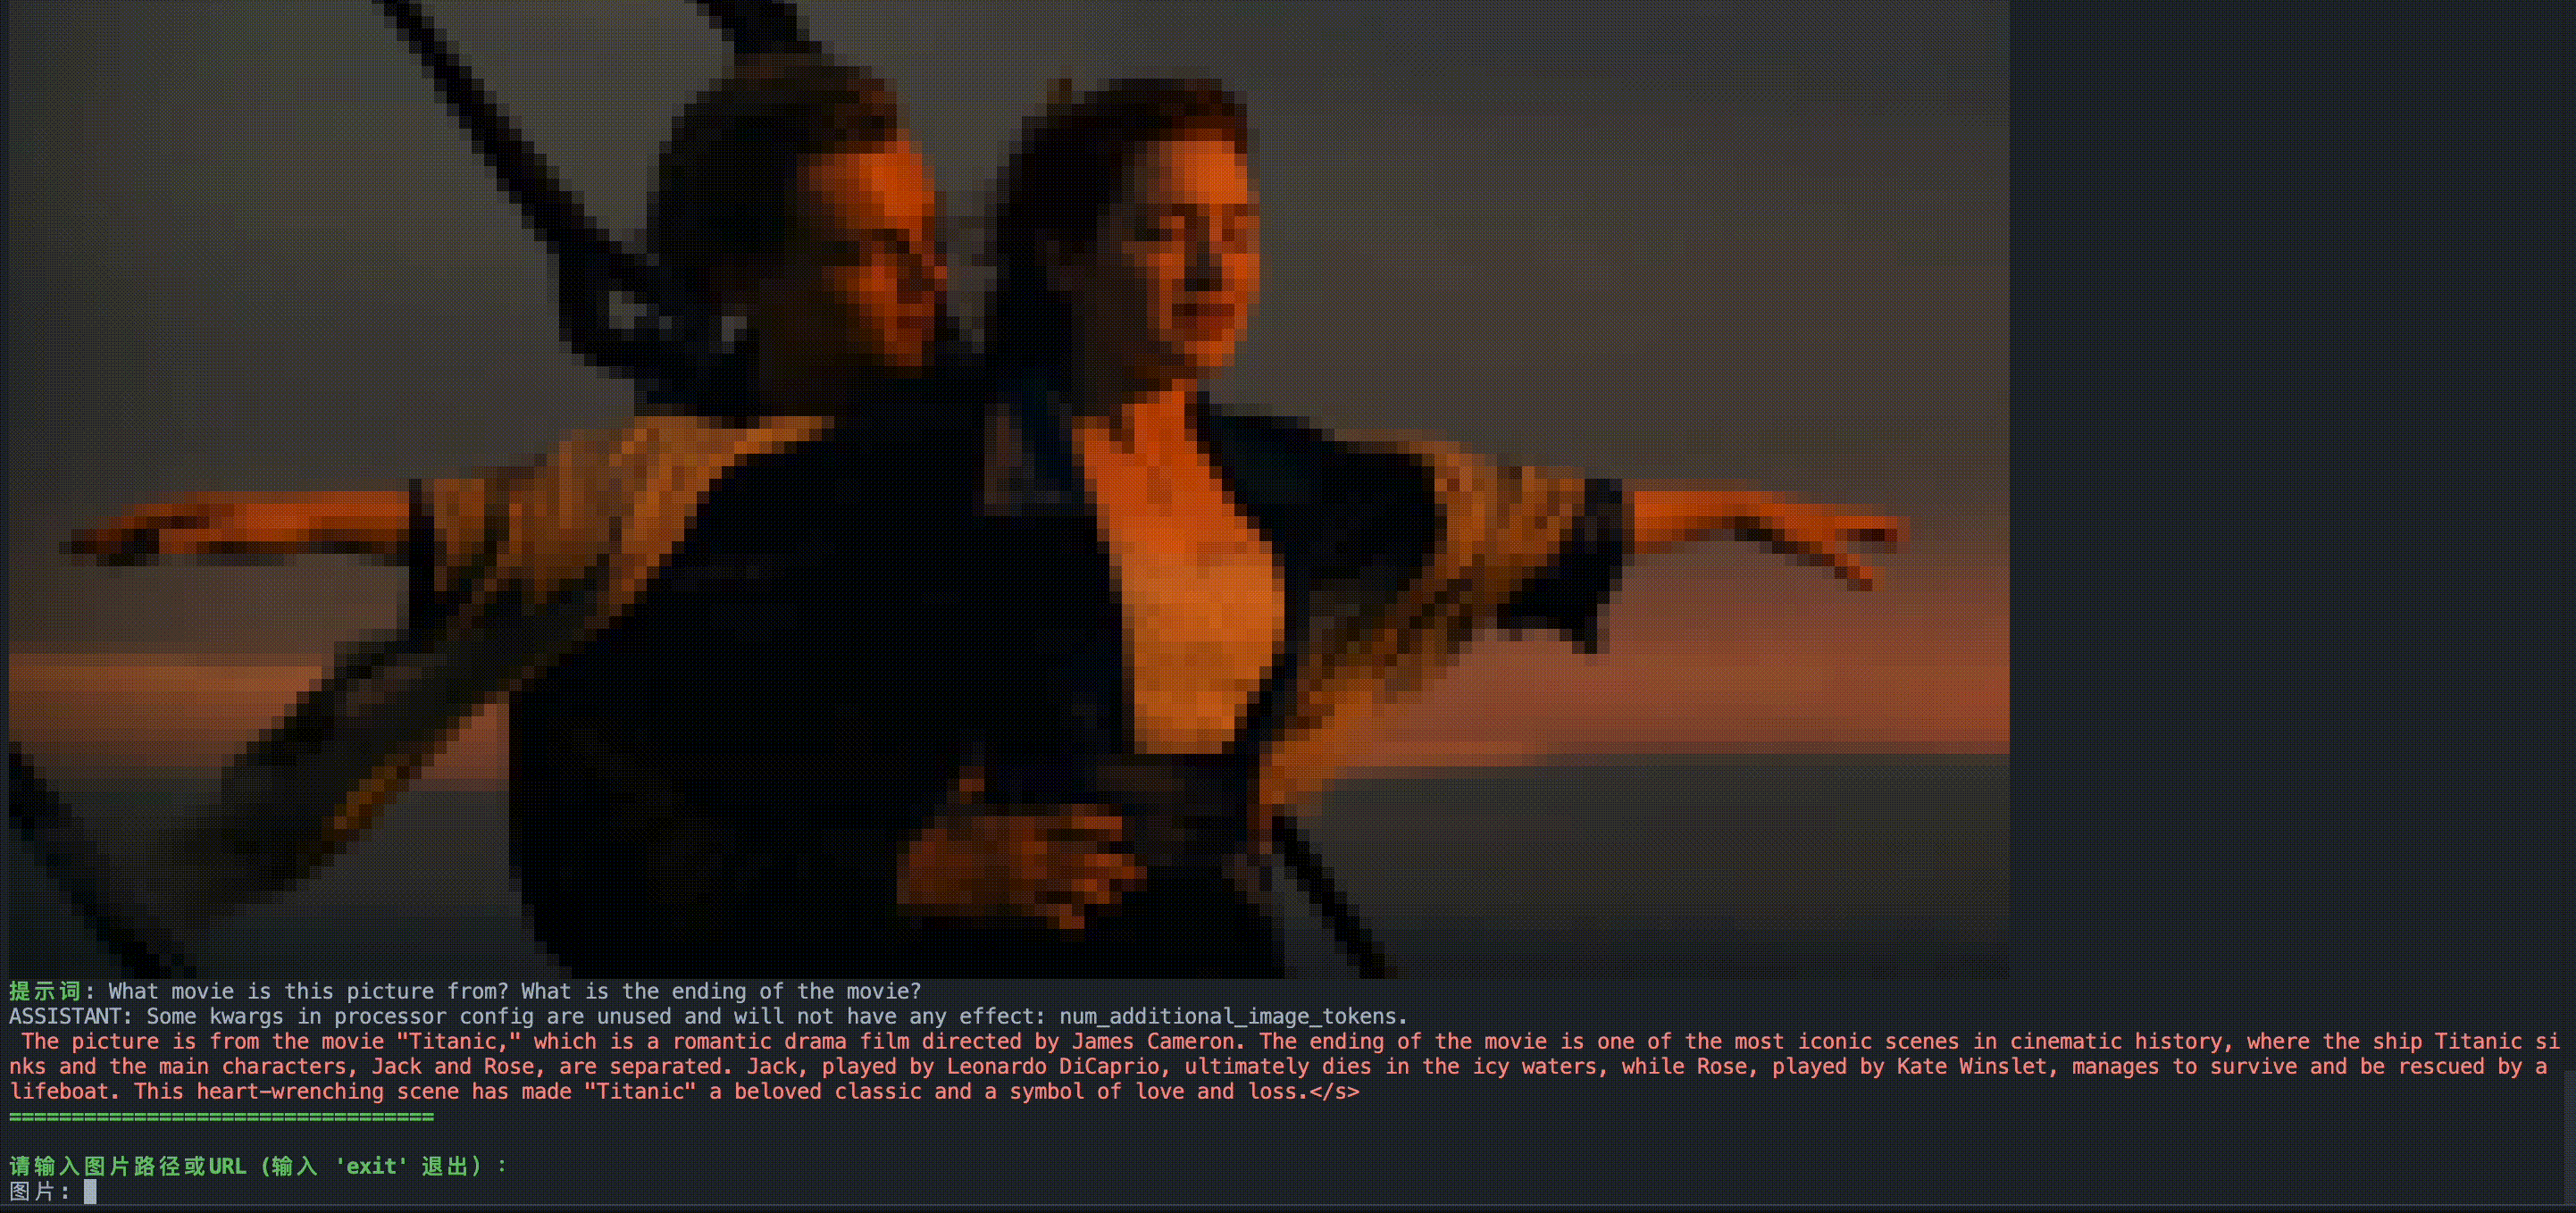
感兴趣的同学可以扫码联系课程购买,这个课程是我和《自制深度学习推理框架》作者一起合力打造的,内容也会持续更新优化。
一,数学和编程基础专栏
二,神经网络基础部件
1,神经网络基础部件:
2,深度学习基础:
三,经典卷积神经网络模型
1,卷积神经网络的经典 backbone:
2,轻量级网络详解:
四,深度学习炼丹
五,深度学习模型压缩
六,模型推理部署
1,模型推理部署:
2,ncnn 框架源码解析:
3,异构计算
- 移动端异构计算:
neon编程 - GPU 端异构计算:
cuda编程,比如gemm算法解析与优化
七,进阶课程
1,推荐几个比较好的深度学习模型压缩与加速的仓库和课程资料:
- 神经网络基本原理教程
- AI-System: 深度学习系统,主要从底层方向讲解深度学习系统等原理、加速方法、矩阵成乘加计算等。
- pytorch-deep-learning:很好的 pytorch 深度学习教程。
2,一些笔记好的博客链接:
- The Illustrated Transformer: 国内比较好的博客大都参考这篇文章。
- C++ 并发编程(从C++11到C++17): 不错的 C++ 并发编程教程。
- What are Diffusion Models?
- annotated_deep_learning_paper_implementations
3,最后,持续高质量创作不易,有 5 秒空闲时间的,可以扫码关注我的公众号-嵌入式视觉,记录 CV 算法工程师成长之路,分享技术总结、读书笔记和个人感悟。
公众号不会写标题党文章,也不输出给大家带来的焦虑的内容!
4,Star History Chart: