不再同步更新旧仓库 tencentmusic/cube-studio
CubeStudio
CubeStudio 是一款国产化、云原生的一站式开源人工智能平台,同时覆盖传统机器学习、深度学习与大模型全链路(MLOps / MaaS / 算力调度 / 训推平台),开源协议 MIT,开源免费商用,开源版本已有数千家企业私有化部署。平台提供多租户与算力纳管调度、算力租赁与 Token 中转站、拖拉拽 Pipeline 任务流编排、多机多卡分布式训练、超参搜索、推理服务、vGPU 虚拟化、云边端协同与边缘计算、图文音多模态自动化标注、大模型 SFT 微调 / 奖励模型 / 强化学习训练、vLLM / Ollama / MindIE 大模型多机推理、私有知识库 / LLMOps / 智能体、AI 模型市场,以及从数据到上线的全流程模型部署。原生适配昇腾、寒武纪、海光、摩尔线程、沐曦等国产异构算力与 x86 / ARM CPU 架构,支持 IB / RoCE / RDMA 高速网络及信创私有化、内网离线部署。
帮助文档
https://github.com/data-infra/cube-studio/wiki
开源共建
学习、部署、体验、开源建设、商业合作 欢迎来撩。或添加微信luanpeng1234,备注<开源建设>
整体架构
功能清单
| 模块分组 | 功能 | 功能描述 |
|---|---|---|
| 用户权限 | SSO单点登录 | 账号密码注册自动登录支持对接公司账号体系AUTH_OID/AUTH_LDAP/AUTH_REMOTE_USER等登录注册方式,支持消息推送 |
| 增加登录验证,强密码,远程用户,登录频率限制,密码密文传输显示等 | ||
| 用户权限 | 项目组管理 | AI平台需要通过项目划分,支持配置相应项目组用户的权限,任务/服务的挂载,资源组,集群,服务代理,项目组内角色控制,支持用户和项目组删除,支持为项目组指定命名空间,项目组支持绑定多个资源组,支持设置组内用户可用资源组 |
| 用户权限 | 用户管理 | |
| 角色管理/权限管理 | 管理平台用户的基本信息,组织架构,支持账号密码,rbac权限体系 | |
| 增加修改和删除,清理等操作的历史记录,支持菜单权限控制 | ||
| 支持只读者public角色,支持控制角色可访问接口,以及接口访问类型 | ||
| 支持多租户(多个用户公司) | ||
| 算力调度 | 数据大屏 | 支持全局,项目组,个人级别的任务pod的分布情况 |
| 算力调度 | 多资源组/多集群 | 支持划分多资源组,支持docker运行时,支持多k8s集群,支持ipvs网络模式,支持containerd容器运行态,支持边缘集群模式 |
| 算力调度 | gpu调度能力 | 提供多种规格的资源支持不同的使用场景,cpu/gpu等 支持T4/V100/A100等多种卡型 |
| 支持gpu禁用模型,共享模式,独占模式,vgpu模式,支持虚拟化占用显存设定,英伟达支持指定卡序号,支持gpu调度binpack调度策略,支持ib/roce的rdma协议 | ||
| 算力调度 | 支持多种算力 | 平台底层外部组件支持arm架构,前后端镜像支持arm架构,任务模板支持arm架构,notebook镜像支持arm架构,超参搜索支持arm架构,aihub应用70%支持arm架构 |
| 支持调度海光dcu,华为npu算力,壁仞,沐曦、寒武纪、摩尔线程,百度昆仑芯 | ||
| 算力调度 | 算力市场 | 支持算力市场机器空闲状态查看,支持按需占用,和包月包日模式租赁 |
| 算力调度 | 租赁实例 | 支持租赁启动pod实例管理,开关机释放等,支持查看当前租赁信息和使用费用ssh登录信息等 |
| 支持包月账单的管理 | ||
| 算力调度 | 计量计费功能 | 1、支持平台资源限制的分配和查看 |
| 项目组资源限制,用户资源限制、任务资源限制,项目组下个人的资源限制,包括开发资源,训练资源、推理资源等 | ||
| 额度限制限制在notebook,docker构建,pipeline,超参搜索,内部服务,推理服务中的生效 | ||
| 限制支持单任务,并行任务总和和历史任务总和等方法 | ||
| 2、提供统一的开发、训练、推理服务资源监控,从用户、项目、任务角度分析模型资源分配及使用情况 | ||
| 3、支持自定义计费模式,通过计量结果自定义获取计费值 | ||
| 4、按需占用日结账单,产生用户每日账单费用和明细 | ||
| 算力调度 | 机器资源管理 | web界面控制机器调度类型,所属资源组,是否启动rdma,是否启动vgpu,可用任务场景等 |
| 算力调度 | 存储盘管理 | 支持web界面添加存储盘,支持项目组绑定,notebook pipeline 推理服务,直接在pod中挂载外部分布式存储 |
| 支持nfs,cfs,oss,nas,cos,glusterfs,cephfs,s3/minio | ||
| 基础能力 | 网络 | 支持80、非80端口,支持公网/域名,支持反向代理和内网穿透方式访问,支持https |
| 基础能力 | 数据库存储 | 支持外部mysql/postgres/OceanBase/人大金仓/达梦作为元数据库(不含标注模块) |
| 基础能力 | 国际化能力 | mlops支持配置多语言配置,目前支持8国语言翻译 |
| 数据管理 | 数据地图 | 元数据库表管理,指标,维表 |
| 数据管理 | 数据计算 | sqllab交互查询,支持mysql,postgresql,clickhouse,hive,presto,达梦数据库等计算引擎,支持数据分析建模 |
| 数据管理 | 数据集管理 | 允许用户随时上传样本集(图片、音频、文本等),对表格数据支持数据集一键探索功能 |
| 数据标注 | 数据标注 | 支持图/文/音/多模态各类型标注能力 |
| 支持分布式存储打通mlops平台 | ||
| 支持项目组权限控制,支持普通用户标注草稿,审核员核定,标注质量打分,导入导出批量删除设置等区分角色的权限控制 | ||
| 标注任务分配 | ||
| 目前支持8国语言翻译 | ||
| labelstudio标注数据导入pipeline | ||
| 支持从数据集模块导入和导出到数据集模块 | ||
| 支持pg/人大金仓数据库 | ||
| 支持项目状态管理和webhook | ||
| 数据标注 | 数据标注 | 支持自动化标注:支持目标识别,目标边界识别,目标遮罩识别,图片分类,图片描述,ocr,支持图片转markdown,关键点检测,视频多目标跟踪,多说话人语音分隔,语音识别,结构化数据标注 |
| 支持视觉大模型自动化标注:支持目标识别万物识别,支持目标边界检测万物分隔,支持目标遮罩万物分隔 | ||
| 支持大模型自动化标注:文本分类,文本翻译,命名实体识别,阅读理解,问答,摘要提取,答案排序 | ||
| 在线开发 | 镜像功能 | 镜像仓库/镜像管理/在线构建镜像 |
| 同时提供平台所有镜像,包括模板镜像/服务镜像/notebook镜像/gpu基础环境的构建方法和构建后镜像, | ||
| 支持同一仓库多个秘钥配置,支持在线镜像构建 | ||
| 在线开发 | notebook | 支持基于开源的Jupyterlab/vscode汉化版,提供在线的交互式开发调试工具 |
| 提供多种可选环境ide和开发示例,支持资源类型选择 | ||
| 支持大数据版本,机器学习版本,深度学习版本 | ||
| 大数据版本支持用户信息,hdfs客户端,hive客户端和spark客户端 | ||
| 支持ssh remote与notebook对接远程开发,方便快速将本地代码提交到平台的训练环境 | ||
| ssh jumpproxy,单端口开放 | ||
| 支持gpu,cpu,内存,监控,支持git交互 | ||
| 支持自定义notebook镜像,便于封装公司自己的notebook | ||
| 多环境notebook,支持R语言/julia语言/python2.7/python3.6/python3.7/python3.8/python3.9/python3.10环境和cube-studio专有环境 | ||
| 在线ide支持claude code对接内网或国内模型 | ||
| 支持tensorboard任务可视化 | ||
| notebook支持环境镜像保存 | ||
| jupyter支持密码保护 | ||
| notebook支持整卡占用,虚拟卡占用,gpu共享占用 | ||
| notebook支持指定调度机器 | ||
| 支持华为npu算力的在线jupyter开发 | ||
| 支持海光dcu算力的在线jupyter开发 | ||
| 支持沐曦算力的在线jupyter开发 | ||
| 支持notebook启动自动初始化 | ||
| 支持notebook自动清理,续期 | ||
| 模型训练 | 拖拉拽任务流编排调试 | 提供拖拽式交互开发环境,支持开发者以拖拽的方式完成业务逻辑的PIPLINE |
| 支持单任务调试,训练支持多种资源规格(CPU、GPU等),支持卡型的选择,超时重试等,任务支持独占和共享占用gpu | ||
| 分布式任务模板支持单任务调试用户镜像而非模板镜像 | ||
| 支持rdma资源占用 | ||
| 支持gpu不同厂商,不同卡型的占用 | ||
| 分布式任务模板支持gpu型号透传,rdma资源透传,拉取秘钥透传 | ||
| pipeline调试,支持定时调度,补录,并发限制,超时,实例依赖等,任务管理,workflow实例管理,资源监控,支持任务输入输出,任务流全局常量,文本/图片/csv/json/表格/echart结果可视化,支持workflow暂停和恢复 | ||
| 支持单任务和pipeline运行中任务监听端口提供运行中服务监听能力 | ||
| 定时调度支持最大保留实例数 | ||
| pipeline支持任务流优先级 | ||
| 模型训练 | 主流功能算子 | 基础算子:自定义镜像,逻辑节点,python |
| 数据同步:数据集导入(支持huggingface/魔塔数据集),datax,datax-import,模型导入(支持huggingface/魔塔模型),datax-import支持mysql,postgresql,clickhouse | ||
| 模型训练 | 主流功能算子 | 特征处理: |
| -数据合并,包含union、join操作 | ||
| -去除重复样本 | ||
| -数据变换,包括boxcox转换、二值化、数据类型转换、dct变换、根据函数转换、ma移动平均、多项式展开 | ||
| -非数值型变量处理,包括hash、根据统计量转换、one-hot | ||
| -异常值检测 | ||
| -获取变量的统计量 | ||
| -去除值过于单一的变量 | ||
| -删除缺失率过高的值 | ||
| -删除缺失率过高的值 | ||
| -填充缺失值 | ||
| -数据离散化,等宽、等频、聚类离散化 | ||
| -标准化、正则化、归一化,有最大绝对值归一化、最大最小归一化、z_score标准化 | ||
| -索引处理,包含增加索引、索引转列、列索引重命名 | ||
| -排序 | ||
| -执行sql | ||
| -hadamard乘积 | ||
| -特征组合,用于衍生特征 | ||
| -降维,包括pca降维和卡方降维 | ||
| -特征重要性,通过随机森林、逻辑回归、xgboost等模型计算特征重要性,可计算特征的iv值、互信息值、方差等 | ||
| -特征向量间的相关性计算 | ||
| -数据拆分,包括列内拆分、列间拆分、行间拆分、svd奇异值分解 | ||
| -采样,包括随机采样、分层采样、过采样、欠采样 | ||
| 模型训练 | 主流功能算子 | 数据处理工具:volcanojob/ray分布式数据处理,hadoop模板支持hadfs,hive命令,spark命令 |
| 文本数据处理: | ||
| paddleocr-vl pdf/doc/图片等提取为markdown,markdown提取问答对,问答扩展,清理异常数据,过滤数据,替换隐私数据,文本数据统计 | ||
| 图像数据处理: | ||
| 图片质量评估、图片去噪声,图片缩放,图片标准化,图片裁剪,图片均衡化,图片的空间转换,图片变换(旋转,平移,缩放,翻转 | ||
| 视频处理:分布式媒体下载,视频提取图片,视频提取图片 | ||
| 模型训练 | 主流功能算子 | 传统机器学习:sklearn单机,ray-sklearn分布式,xgb单机训练推理 |
| 传统机器学习算法:ar/arima时间序列算法/random-forest/random-forest-regression/lr/lightgbm/knn/kmeans/gbdt/decision-tree//pca/lda/catboost/xgb,超参搜索 | ||
| 模型训练 | 主流功能算子 | 分布式深度学习框架:tf/pytorch |
| 模型训练 | 主流功能算子 | 模型处理:模型评估,模型格式转换 |
| 模型服务化:模型注册,模型离线处理,模型部署 | ||
| 模型训练 | 算子自定义 | 支持算子自定义,通过web界面操作将自定义算法代码镜像,注册为可被他人复用的pipeline算子,自定义任务模板额外支持int型,float型,list型,bool型,json型,子类型支持workdir类型,image类型,select-input,select2,project类型,支持参数tip提醒 |
| 模型训练 | 链路共享 | 面向非AI背景的用户提供自动学习服务,用户选择某一个场景之后,上传训练数据即可自动开始训练和模型部署,支持示例pipeline任务流导入导出 |
| 模型训练 | 自定义镜像 | 面向高级 AI 开发者,提供自定义训练作业(执行环境 + 代码)功能 |
| 模型训练 | 自动调参 | 基于单机/分布式自动超参搜索 |
| 模型训练 | TensorBoard作业 | 实时/离线观察模型训练过程中的参数和指标变化情况 |
| 模型管理 | ||
| 推理服务 | 内部服务 | 支持开发或运维工具快捷部署,提供mysql-web,postgresql web,mobgo web, redis web,neo4j,rstudio等开源工具,支持ollama,xinference大模型推理 |
| 模型管理 | ||
| 推理服务 | 模型管理 | 模型管理用于对模型多版本管理,支持模型发布为推理服务,支持模型指标可视化 |
| 模型管理 | ||
| 推理服务 | 推理服务 | 支持ml/tf/pytorch/tentortrt/onnx常规模型的多版本的0代码发布 |
| 支持gpu卡型选择,支持vgpu,独占,共享占用,支持cpu/mem/gpu等弹性伸缩,支持服务优先级,支持随机分流和header分流,限流,流量复制,sidecar配置,支持泛域名配置,支持配置文件挂载,启动目录/命令/环境变量/端口/指标/健康检查等 | ||
| 支持调试环境/生产环境 | ||
| 支持域名/ip代理多种形式 | ||
| 支持服务负载指标监控 | ||
| 支持多版本服务滚动升级和回滚 | ||
| 支持远程模型路径 | ||
| 提供ml/tf/pytorch/tentortrt/onnx常规模型推理服务镜像 | ||
| 支持用户自定义模型推理镜像 | ||
| 支持定时伸缩容 | ||
| 支持配置服务的jwt认证功能 | ||
| 支持推理服务在线测试 | ||
| 监控 | 整体资源 | 所有集群,所有计算机器的使用情况,包括机器的所属集群,所属资源组,机器ip,cpu/gpu类型和卡型,当前cpu/内存/gpu的使用率 |
| 所有集群,所有计算pod的使用情况,包括pod所属集群,所属资源组,所属命名空间,调度ip,pod名称,启动用户,cpu,gpu,内存的申请使用率 | ||
| 整体资源页面,支持管理员批量删除 | ||
| 监控 | 监控体系 | 所有机器的gpu资源的使用情况, |
| 所有机器的内存/cpu/网络io/磁盘io的负载情况, | ||
| 所有pod的内存/cpu/gpu/网络io负载情况 | ||
| 所有推理服务的内存/cpu/gpu/qps/吞吐/vgpu负载情况 | ||
| 支持ib流量监控 | ||
| 支持首页消息提醒,支持企业微信,钉钉,飞书群聊消息推送 | ||
| 消息报警记录,统一webhook接口 | ||
| npu监控 | ||
| AIHUB | 应用sdk | 提供CubeStudio sdk,提供模型开发规范和使用规范 |
| AIHUB | 应用sdk | 提供web端模型应用体验,支持api推理 |
| AIHUB | 应用sdk | 提供开发多个python cuda版本的基础镜像 |
| AIHUB | 预训练模型 | 提供视觉,听觉,nlp,多模态等400+预训练模型,提供预训练模型的模型加载和推理能力,可直接一键部署服务,并提供api |
| AIHUB | 模型市场 | aihub应用对接CubeStudio平台进行卡片式展示 |
| AIHUB | 模型一键开发 | 提供一键转notebook开发,提供符合当前模型所需环境的jupyter |
| AIHUB | 模型一键微调 | 支持一键转pipeline微调链路,包括示例数据集下载,微调,模型注册,模型部署,支持微调后模型部署 |
| AIHUB | 模型一键部署web | 提供模型一键部署提供手机端和pc端web界面和api,和demo示例弹窗演示,支持部署成推理服务 |
| AIHUB | 模型自动化标注 | 支持部署对接labelstudio自动化标注 |
| AIHUB | pipeline对接aihub | aihub注册算子,可以将代码目录注册成aihub市场应用 |
| aihub调用算子,可以调用aihub的应用 做数据处理 | ||
| 大模型 | 大模型分布式多机多卡 | 分布式多机多卡训练和加速框架:mpi/colossalai/deepspeed/horovod/megatron/mindformer/mxnet/paddlejob/mindspore分布式训练 |
| 大模型 | 支持大模型推理aihub形式 | (需购买aihub):支持openjourney/gpt3/yuan/sd-v2/sd-v1.5/Stable Cascade/Stable Diffusion XL/部署 |
| 大模型 | 支持大模型推理 | 支持vllm大模型推理,支持推理加速+流式openai接口 |
| 支持分布式多机多卡vllm大模型推理 | ||
| deepseek,qwen2,chatglm4等模型推理示例 | ||
| 支持llm大模型服务对话测试 | ||
| 支持mindie昇腾大模型推理服务 支持 910b和310p算力 | ||
| 支持mindie分布式推理 | ||
| 支持昇腾/海光/沐曦/寒武纪/摩尔线程/昆仑芯适配的大模型推理 | ||
| 支持大模型网关,支持统一入口,秘钥设定,qps/tps限速,黑白名单,token限额,有效期设定,多类型秘钥认证,重试,提示词模板,参数值映射,参数值固化, | ||
| 流量监控:qps、失败率/tps/输入token量/输出token量/e2e/ttft/tpos指标监控 | ||
| 大模型 | 支持大模型微调 | 支持deepseek/chatglm4/qwen2/llama3 lora微调, mindformers微调模型,支持llama-factory 大模型sft/奖励模型/强化学习,支持npu适配的llama-factory,支持dcu适配llama-factory,支持沐曦适配llama-factory |
| 大模型 | 支持大模型量化评估剪枝 | 支持大模型量化功能,支持opencompass大模型评估,支持大模型剪枝 |
| 大模型 | 智能对话 | 提供支持多场景对话,支持责任人权限,提示词模板构建,推理接口配置,llm问答,tips等设置 |
| 大模型 | 智能对话 | 支持清空,修改问题,删除问答对,答案重试,反馈,上传图片多模态问答,切换模型,修改系统提示词,用户提示词模板,修改对话超参数、多窗口对话等,支持问答复制,代码答案下载 |
| 支持展示检索知识库记录 | ||
| 支持安全问答检测 | ||
| 大模型 | 智能对话 | 支持aihub应用接口模式 |
技术背景
传统算法落地流程:从申请机器,配置环境,拉取数据,处理数据,算法训练,调试,模型测试,服务化上线全流程,算法工程师在上面的每个环节都浪费了很多时间,而不是把精力主要集中在算法模型的构建上。
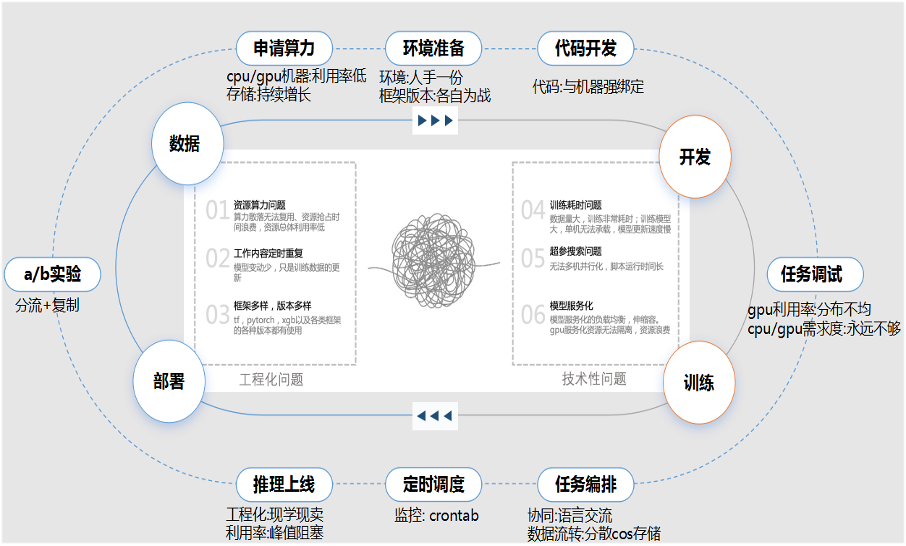
如上图所示,工程师在数据、开发、训练、部署各环节被迫处理大量非算法本质的问题:
- 外环(重复性工程环节):申请算力(CPU/GPU 机器利用率低、存储持续增长)、环境准备(环境人手一份、框架版本各自为战)、代码开发(代码与机器强绑定)、任务调试(GPU 利用率分布不均、CPU/GPU 需求永远不够)、定时调度(监控靠 crontab)、任务编排(协同靠语言交流、数据流转靠分散 COS 存储)、推理上线(工程化现学现卖、利用率峰值阻塞)、A/B 实验(流量分流 + 复制)。
- 工程化问题:① 资源算力问题——算力资源无法复用、资源抢占时资源浪费、资源整体利用率低;② 工作内容定时重复——模型变动少、只是周期数据更新;③ 框架多样、版本多样——TF、PyTorch、XGB 等各类框架及版本混杂。
- 技术性问题:④ 训练耗时问题——数据量大、训练非常耗时,训练模型大,单机无法承载,模型更新速度慢;⑤ 超参搜索问题——无法多机并行化,脚本运行时间长;⑥ 模型服务化——模型服务化的负载均衡与伸缩、GPU 服务资源无法隔离、资源浪费。
cubestudio 一站式的机器学习平台,正是从平台架构上系统性地解决上述工程化与技术性问题,做了一系列更贴近用户实用化的考虑。
行业现状
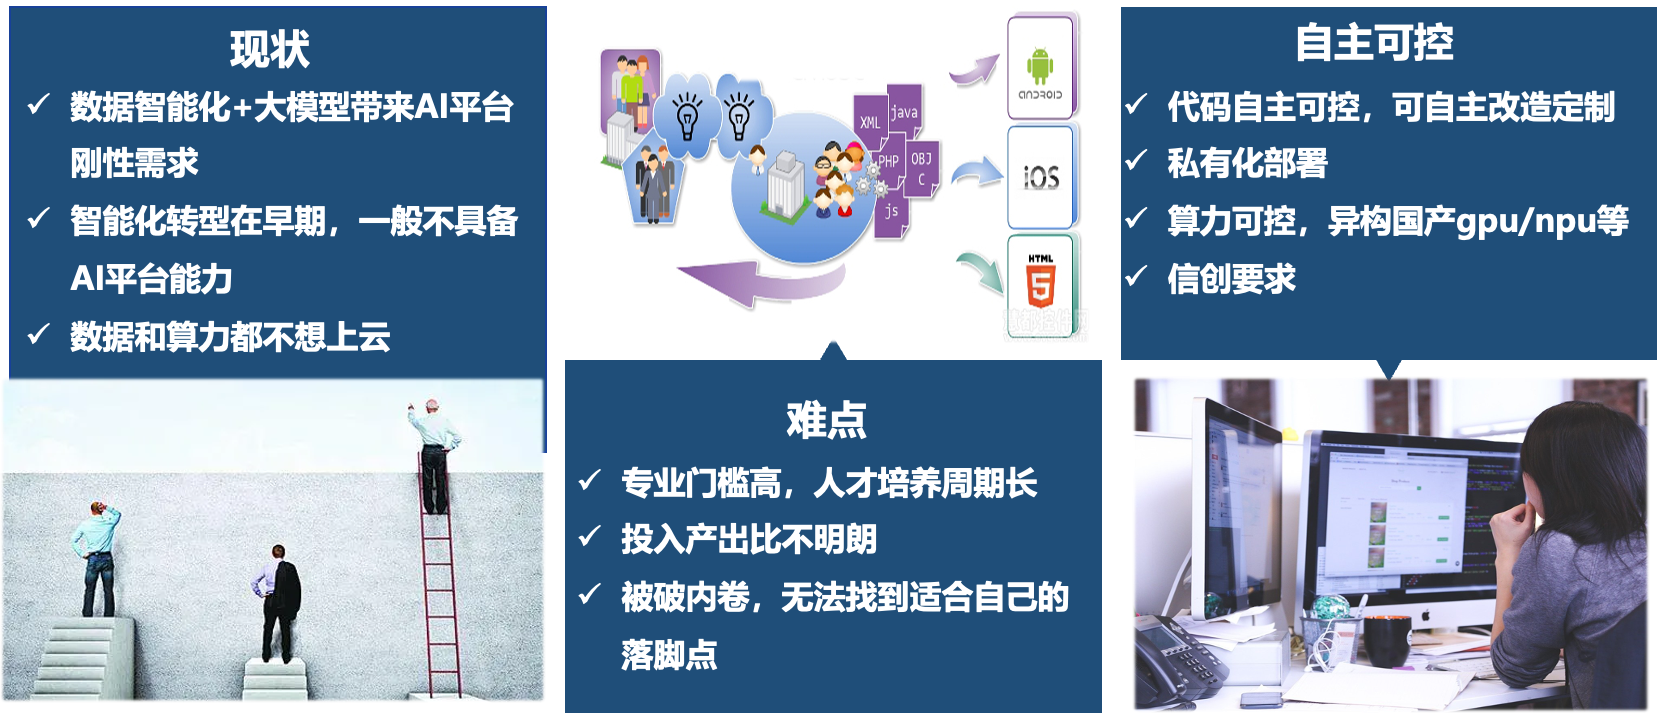
现状:
- 数据智能化 + 大模型带来 AI 平台刚性需求,AI 已成为数字经济时代的核心生产力。
- 智能化转型仍处早期,一般解决方案不具备 AI 平台能力。
- 出于数据安全与算力成本考虑,数据和算力都不想上云。
难点:
- 专业门槛高、多学科交叉,人才稀缺、人才培养周期长。
- 投入产出比不明朗,资金投入大而回报不清晰。
- 应用被"内卷"式重复建设裹挟,难以找到适合自己的落脚点。
自主可控:
- 代码自主可控,可自主改造定制,满足 To B 交付的定制需求。
- 支持私有化部署,平台与算法私有化交付。
- 算力可控,支持异构国产 GPU/NPU 等,满足信创要求,不受国外政策影响。
产品定位
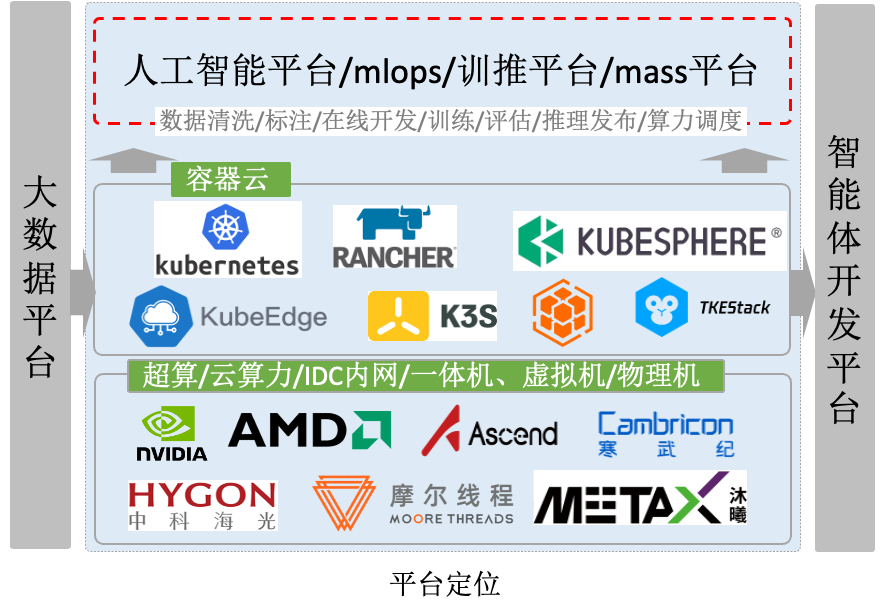
平台定位:如上图所示,cubestudio 位于"大数据平台"与"智能体开发平台"之间,作为一站式 AI / MLOps / 训推 / MaaS 平台承上启下,向上承接大数据平台的数据资产,向下输出到智能体开发平台,贯通数据清洗、标注、在线开发、训练、评估、推理发布、算力调度全链路。
- 容器云底座:支持 Kubernetes、Rancher、KubeSphere、KubeEdge、K3S、TKEStack 等多种容器云环境。
- 异构算力:可运行于超算 / 云算力 / IDC 内网 / 一体机、虚拟机、物理机之上,纳管 NVIDIA、AMD、昇腾(Ascend)、寒武纪(Cambricon)、海光(HYGON)、摩尔线程、沐曦(METAX)等国产及主流异构算力。
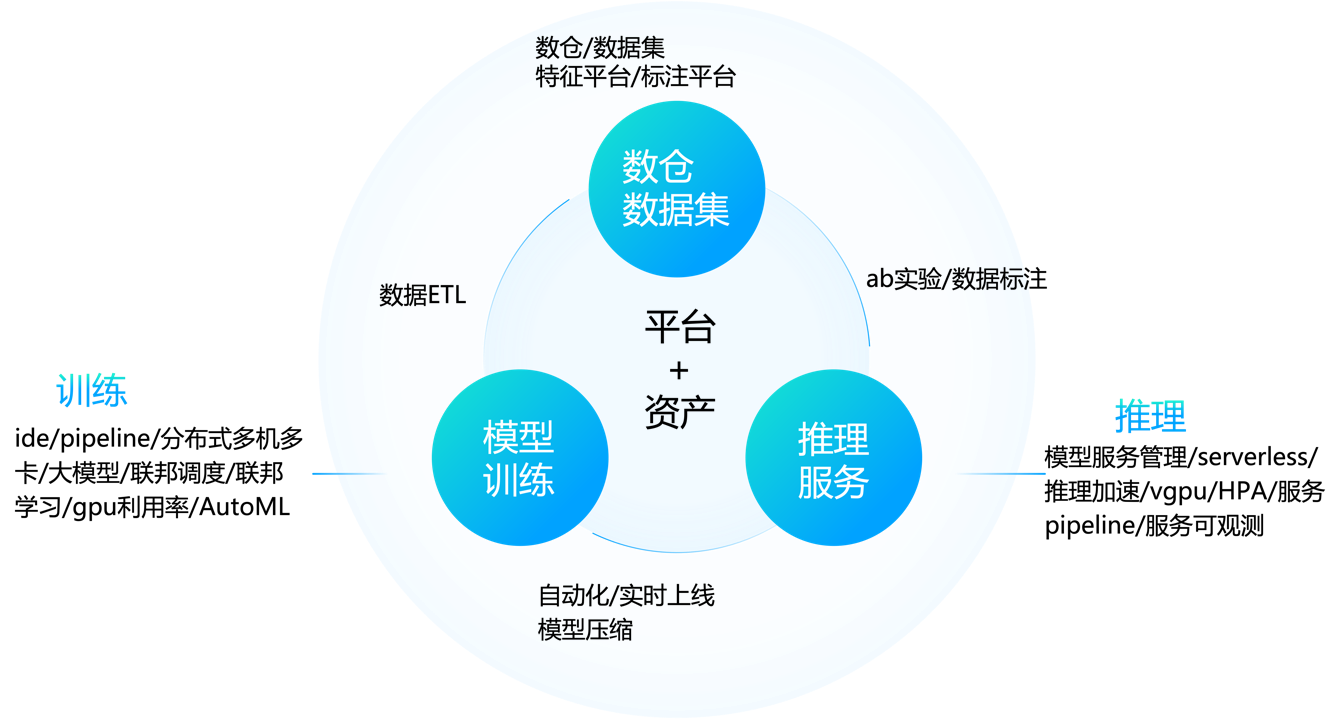
cube-studio 是开源的云原生一站式机器学习 / 深度学习 / 大模型 AI 平台,核心能力包括:
- SSO 登录,多租户 / 多项目组,大数据平台对接
- 标注平台自动化标注、数据集管理
- Notebook 在线开发,拖拉拽任务流 Pipeline 编排
- 多机多卡分布式算法训练、超参搜索,大模型 SFT / 奖励模型 / 强化学习训练
- 推理服务 VGPU、大模型服务网关、弹性伸缩、负载均衡、资源负载监控
- AI 应用商店、智能体应用、私有知识库
- 私有化部署,多集群调度、边缘计算、支持异构国产 CPU/GPU/NPU 芯片,支持 RDMA
产品技术架构
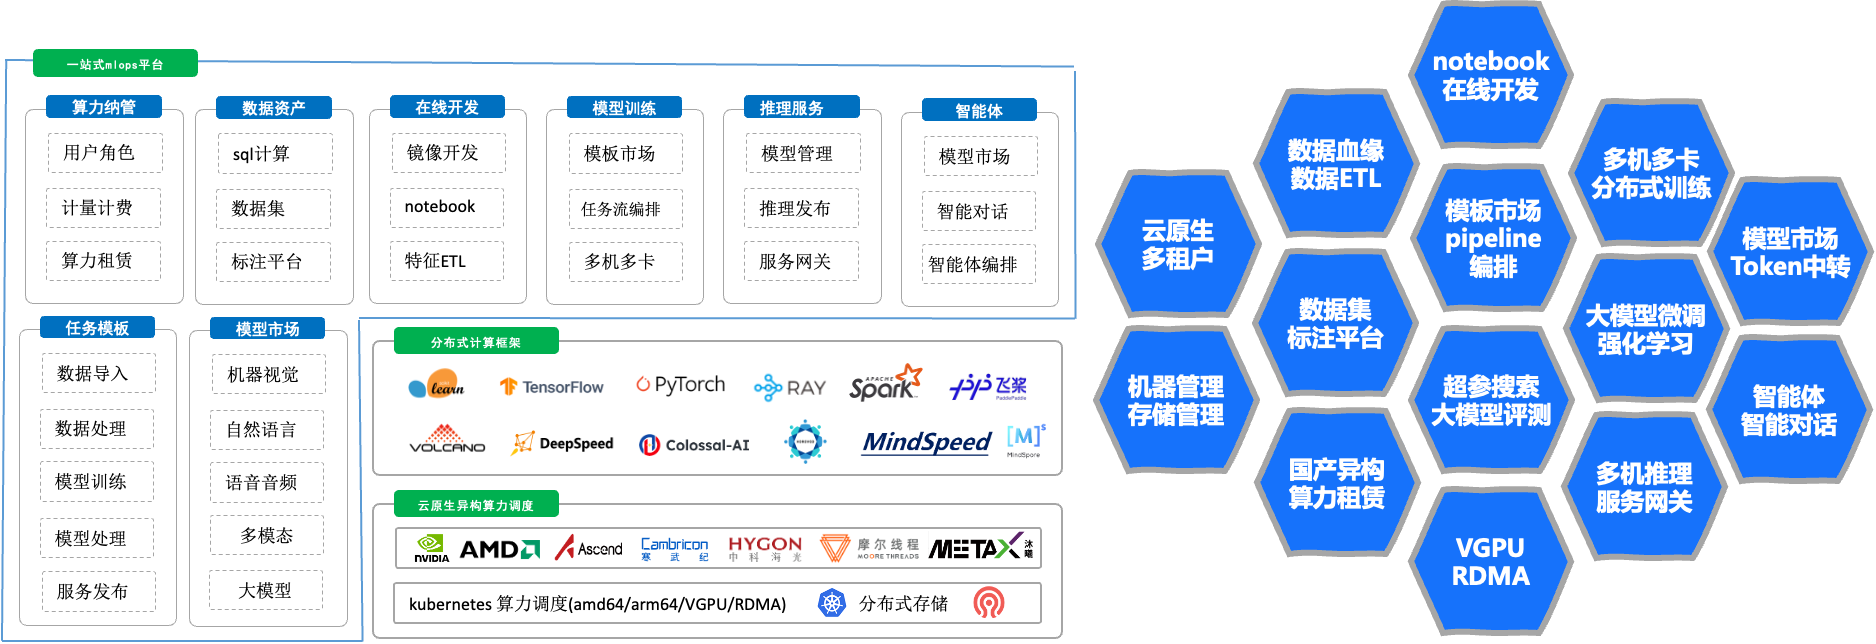
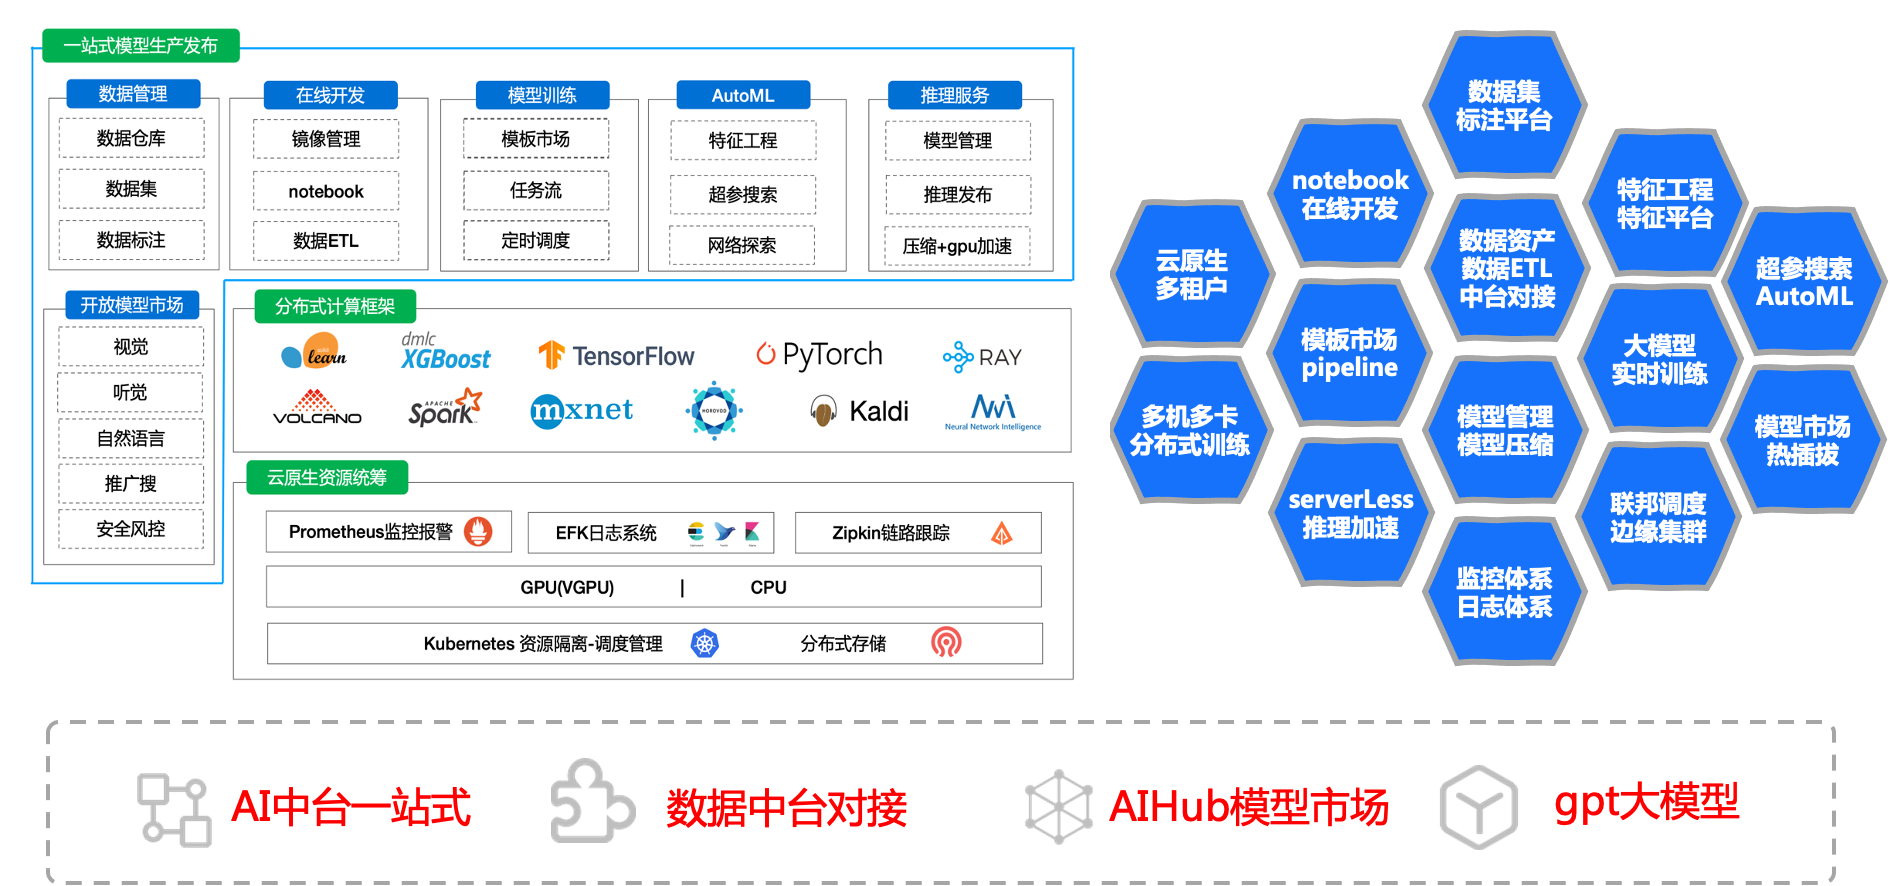
一站式 MLOps 平台,自底向上分层(对应上图左侧):
- 底座:Kubernetes 算力调度(amd64 / arm64 / VGPU / RDMA)+ 分布式存储。
- 云原生异构算力调度:纳管 NVIDIA、AMD、昇腾、寒武纪、海光、摩尔线程、沐曦等异构算力。
- 分布式计算框架:内置 scikit-learn、TensorFlow、PyTorch、Ray、Spark、飞桨、Volcano、DeepSpeed、Colossal-AI、Horovod、MindSpeed、MindSpore 等。
- 算力纳管:用户角色、计量计费、算力租赁。
- 数据资产:SQL 计算、数据集、标注平台。
- 在线开发:镜像开发、Notebook、特征 ETL。
- 模型训练:模板市场、任务流编排、多机多卡。
- 推理服务:模型管理、推理发布、服务网关。
- 智能体:模型市场、智能对话。
- 任务模板:数据导入、数据处理、模型训练、模型处理、服务发布。
- 模型市场(AIHub)覆盖领域:机器视觉、自然语言、语音音频、多模态、大模型。
右侧六边形为平台核心能力集:云原生多租户、机器管理 / 存储管理、数据集 / 标注平台、数据血缘 / 数据 ETL、模板市场 / Pipeline 编排、超参搜索 / 大模型评测、notebook 在线开发、多机多卡分布式训练、大模型微调 / 强化学习、多机推理 / 服务网关、模型市场 / Token 中转、智能体 / 智能对话、国产异构算力租赁、VGPU / RDMA 等。
业务流程架构
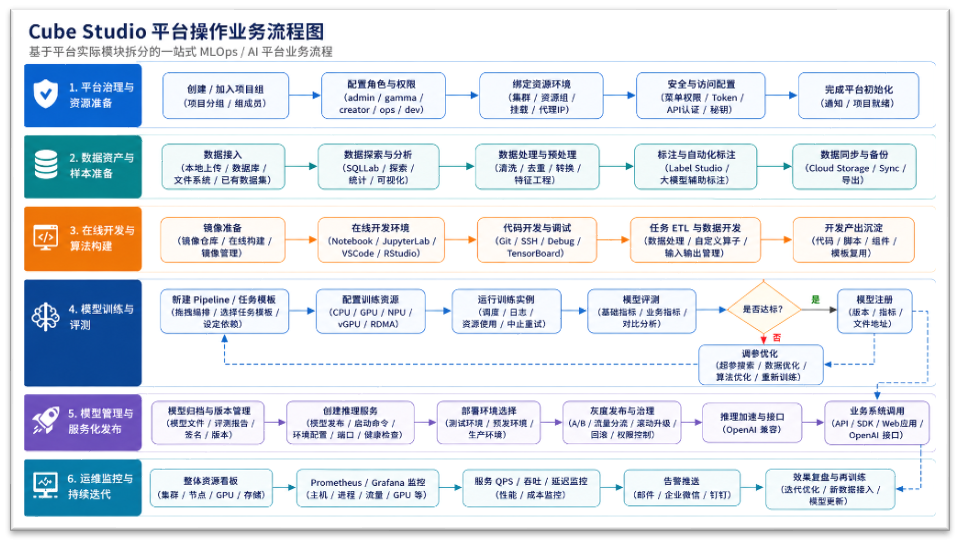
基于平台实际模块拆分的一站式 MLOps / AI 平台业务流程,自左向右、自上而下分为六大阶段闭环:
- 平台部署与资源准备:创建 / 加入项目组(项目分组、组成员)→ 配置角色与权限(admin / gamma / creator / ops / dev)→ 绑定资源环境(集群 / 资源组、挂载 / 代理 IP)→ 安全与访问配置(菜单权限、Token、API 认证、秘钥)→ 完成平台初始化(通知、项目就绪)。
- 数据资产与样本准备:数据接入(本地上传 / 数据库 / 文件系统 / 已有数据集)→ 数据探索与分析(SQLLab 探索、统计、可视化)→ 数据处理与预处理(清洗、去重、转换、特征工程)→ 标注与自动化标注(Label Studio、大模型辅助标注)→ 数据同步与备份(Cloud Storage / Sync / 导出)。
- 在线开发与算法构建:镜像准备(镜像仓库 / 在线构建 / 镜像管理)→ 在线开发环境(Notebook / JupyterLab / VSCode / RStudio)→ 代码开发与调试(Git / SSH / Debug / TensorBoard)→ 任务 ETL 与数据开发(数据处理、自定义算子、输入输出管理)→ 开发沉淀(代码 / 脚本 / 组件 / 模板复用)。
- 模型训练与评测:新建 Pipeline / 任务模板(拖拽编排、设定依赖)→ 配置训练资源(CPU / GPU / NPU / vGPU / RDMA)→ 运行训练实例(调度、日志、资源使用、中止重试)→ 模型评测(基础指标 / 业务指标对比分析)→ 是否达标? 达标则进入模型注册(版本、指标、文件地址);未达标则进入调参优化(超参搜索 / 数据优化 / 算法优化 / 重新训练),回到配置训练资源形成迭代闭环。
- 模型管理与服务化发布:模型归档与版本管理(模型定义 / 评测报告 / 签名 / 版本)→ 创建推理服务(模型发布命令、环境配置、端口、健康检查)→ 部署环境选择(测试环境 / 预发环境 / 生产环境)→ 灰度发布与治理(A/B、流量分流、滚动升级、回滚、权限控制)→ 推理加速与接口(OpenAI 兼容)→ 业务系统调用(API / SDK / Web 应用 / OpenAI 接口)。
- 运维监控与持续迭代:整体资源看板(集群 / 节点 / GPU / 存储)→ Prometheus / Grafana 监控(主机、进程、流量、GPU 等)→ 服务 QPS / 吞吐 / 延迟监控(性能、成本监控)→ 告警推送(邮件、企业微信、钉钉)→ 效果复盘与再训练(迭代优化、新数据接入、模型更新),闭环回到数据与训练阶段。
功能模块
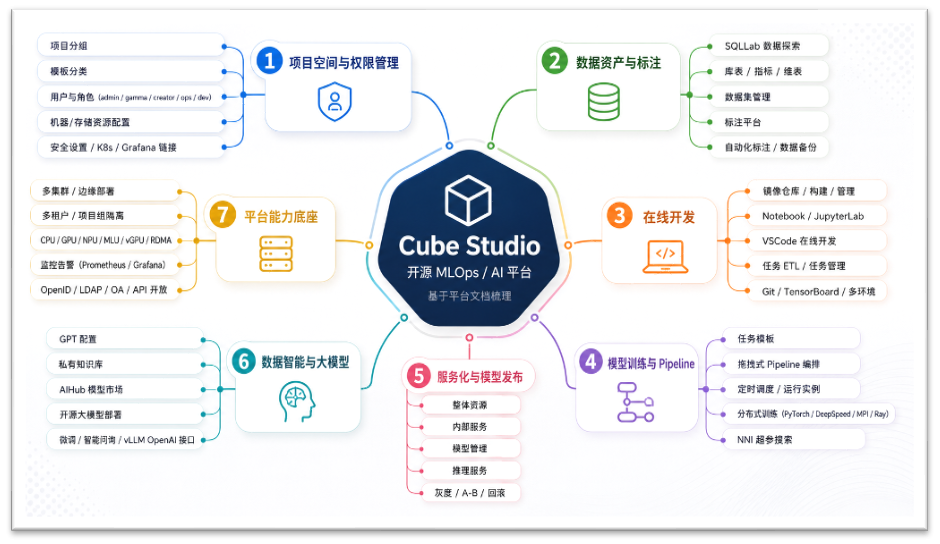
以 cube-studio 开源 MLOps / AI 平台为核心,功能模块覆盖从底座算力到大模型应用的全链路。按用户实际使用路径,可归纳为九大能力域,依次为:用户与权限 → 算力纳管 → 在线开发 → 数据管理与标注 → 模型训练 → 推理服务 → 监控 → AIHub 模型市场 → 大模型,另有贯穿全栈的国产化支持能力。
- 项目空间与权限管理:项目分组、模板分类、用户与角色(admin / gamma / creator / ops / dev)、机器 / 存储资源配置、安全设置(K8s / Grafana 链接)。
- 数据资产与标注:SQLLab 数据探索、库表 / 指标 / 维表管理、数据集管理、标注平台、自动化标注与数据备份。
- 在线开发:镜像仓库 / 构建 / 管理、Notebook / JupyterLab、VSCode 在线开发、任务 ETL / 任务管理、Git / TensorBoard / 多环境。
- 模型训练与 Pipeline:任务模板、拖拽式 Pipeline 编排、定时调度 / 运行实例、分布式训练(PyTorch / DeepSpeed / MPI / Ray)、NNI 超参搜索。
- 服务化与模型发布:整体资源、内部服务、模型管理、推理服务、灰度 / A-B / 回滚。
- 数据智能与大模型:GPT 配置、私有知识库、AIHub 模型市场、开源大模型部署、微调 / 智能问答 / vLLM OpenAI 接口。
- 平台能力底座:多集群 / 边缘部署、多用户 / 项目组隔离、CPU / GPU / NPU / MLU / vGPU / RDMA、监控告警(Prometheus / Grafana)、OpenID / LDAP / OA / API 开放。
一、用户与权限
统一账号接入与多租户隔离,是平台安全登录与资源分权的入口。
- SSO 单点登录:对接公司账号体系(AUTH_OID / AUTH_LDAP / AUTH_REMOTE_USER 等)完成登录注册;统一的管理员与用户消息推送;提供登录验证、强密码、远程用户、登录频率限制、密码密文传输等安全增强。
- 项目组管理:按项目组划分资源与权限,配置组内用户权限、任务 / 服务挂载、资源组、集群与服务代理;支持用户与项目组删除、为项目组指定命名空间、绑定多个资源组、设置组内可用资源组。
- 用户 / 角色 / 权限:管理用户信息、组织架构、账号密码与 RBAC 权限体系;含操作历史记录、菜单权限控制、只读 public 角色、接口访问与类型控制,以及多租户(多公司隔离)。
二、算力调度
以 Kubernetes 为底座,云原生统筹 CPU/GPU/NPU 异构算力,实现多集群、多资源组的隔离调度与计量。
- 算力调度:云原生统筹 CPU/GPU 等算力,支持 docker / containerd 运行时;支持划分多资源组、多 K8s 集群、多地部署;支持英伟达 / 海光 / 华为 / 寒武纪 / 摩尔 / 沐曦 / 壁仞等异构算力,及私有化 / 边缘集群 / Serverless 集群模式;支持鲲鹏 ARM64、RDMA(IB/RoCE)、vGPU 虚拟化显存与整卡 / 共享 / 独占多种占用模式。
- 资源限额与数据大屏:平台 / 项目组 / 用户 / 任务 / 组内个人多级资源限制,覆盖 notebook、镜像构建、pipeline、超参搜索、内部服务与推理服务;数据大屏可视化全局 / 项目组 / 个人级别的任务 Pod 分布。
- 机器与存储管理:Web 界面控制机器调度类型、资源组归属、RDMA/vGPU 开关与可用场景;添加存储盘并绑定项目组,notebook / pipeline / 推理服务直接挂载外部分布式存储,支持 NFS、CFS、OSS、NAS、COS、GlusterFS、CephFS、S3/MinIO。
- 算力市场与计量:机器空闲查看、按需 / 按时租赁、自定义镜像启动实例、企业租赁;共享存储盘创建扩容与账单;租赁 Pod 开关机 / 释放 / SSH 登录 / 镜像保存;按用户 / 项目 / 任务维度的按量计量、日结账单,支持微信 / 支付宝 / 对公支付。
多集群管控
单个 k8s 集群的部署拓扑图:
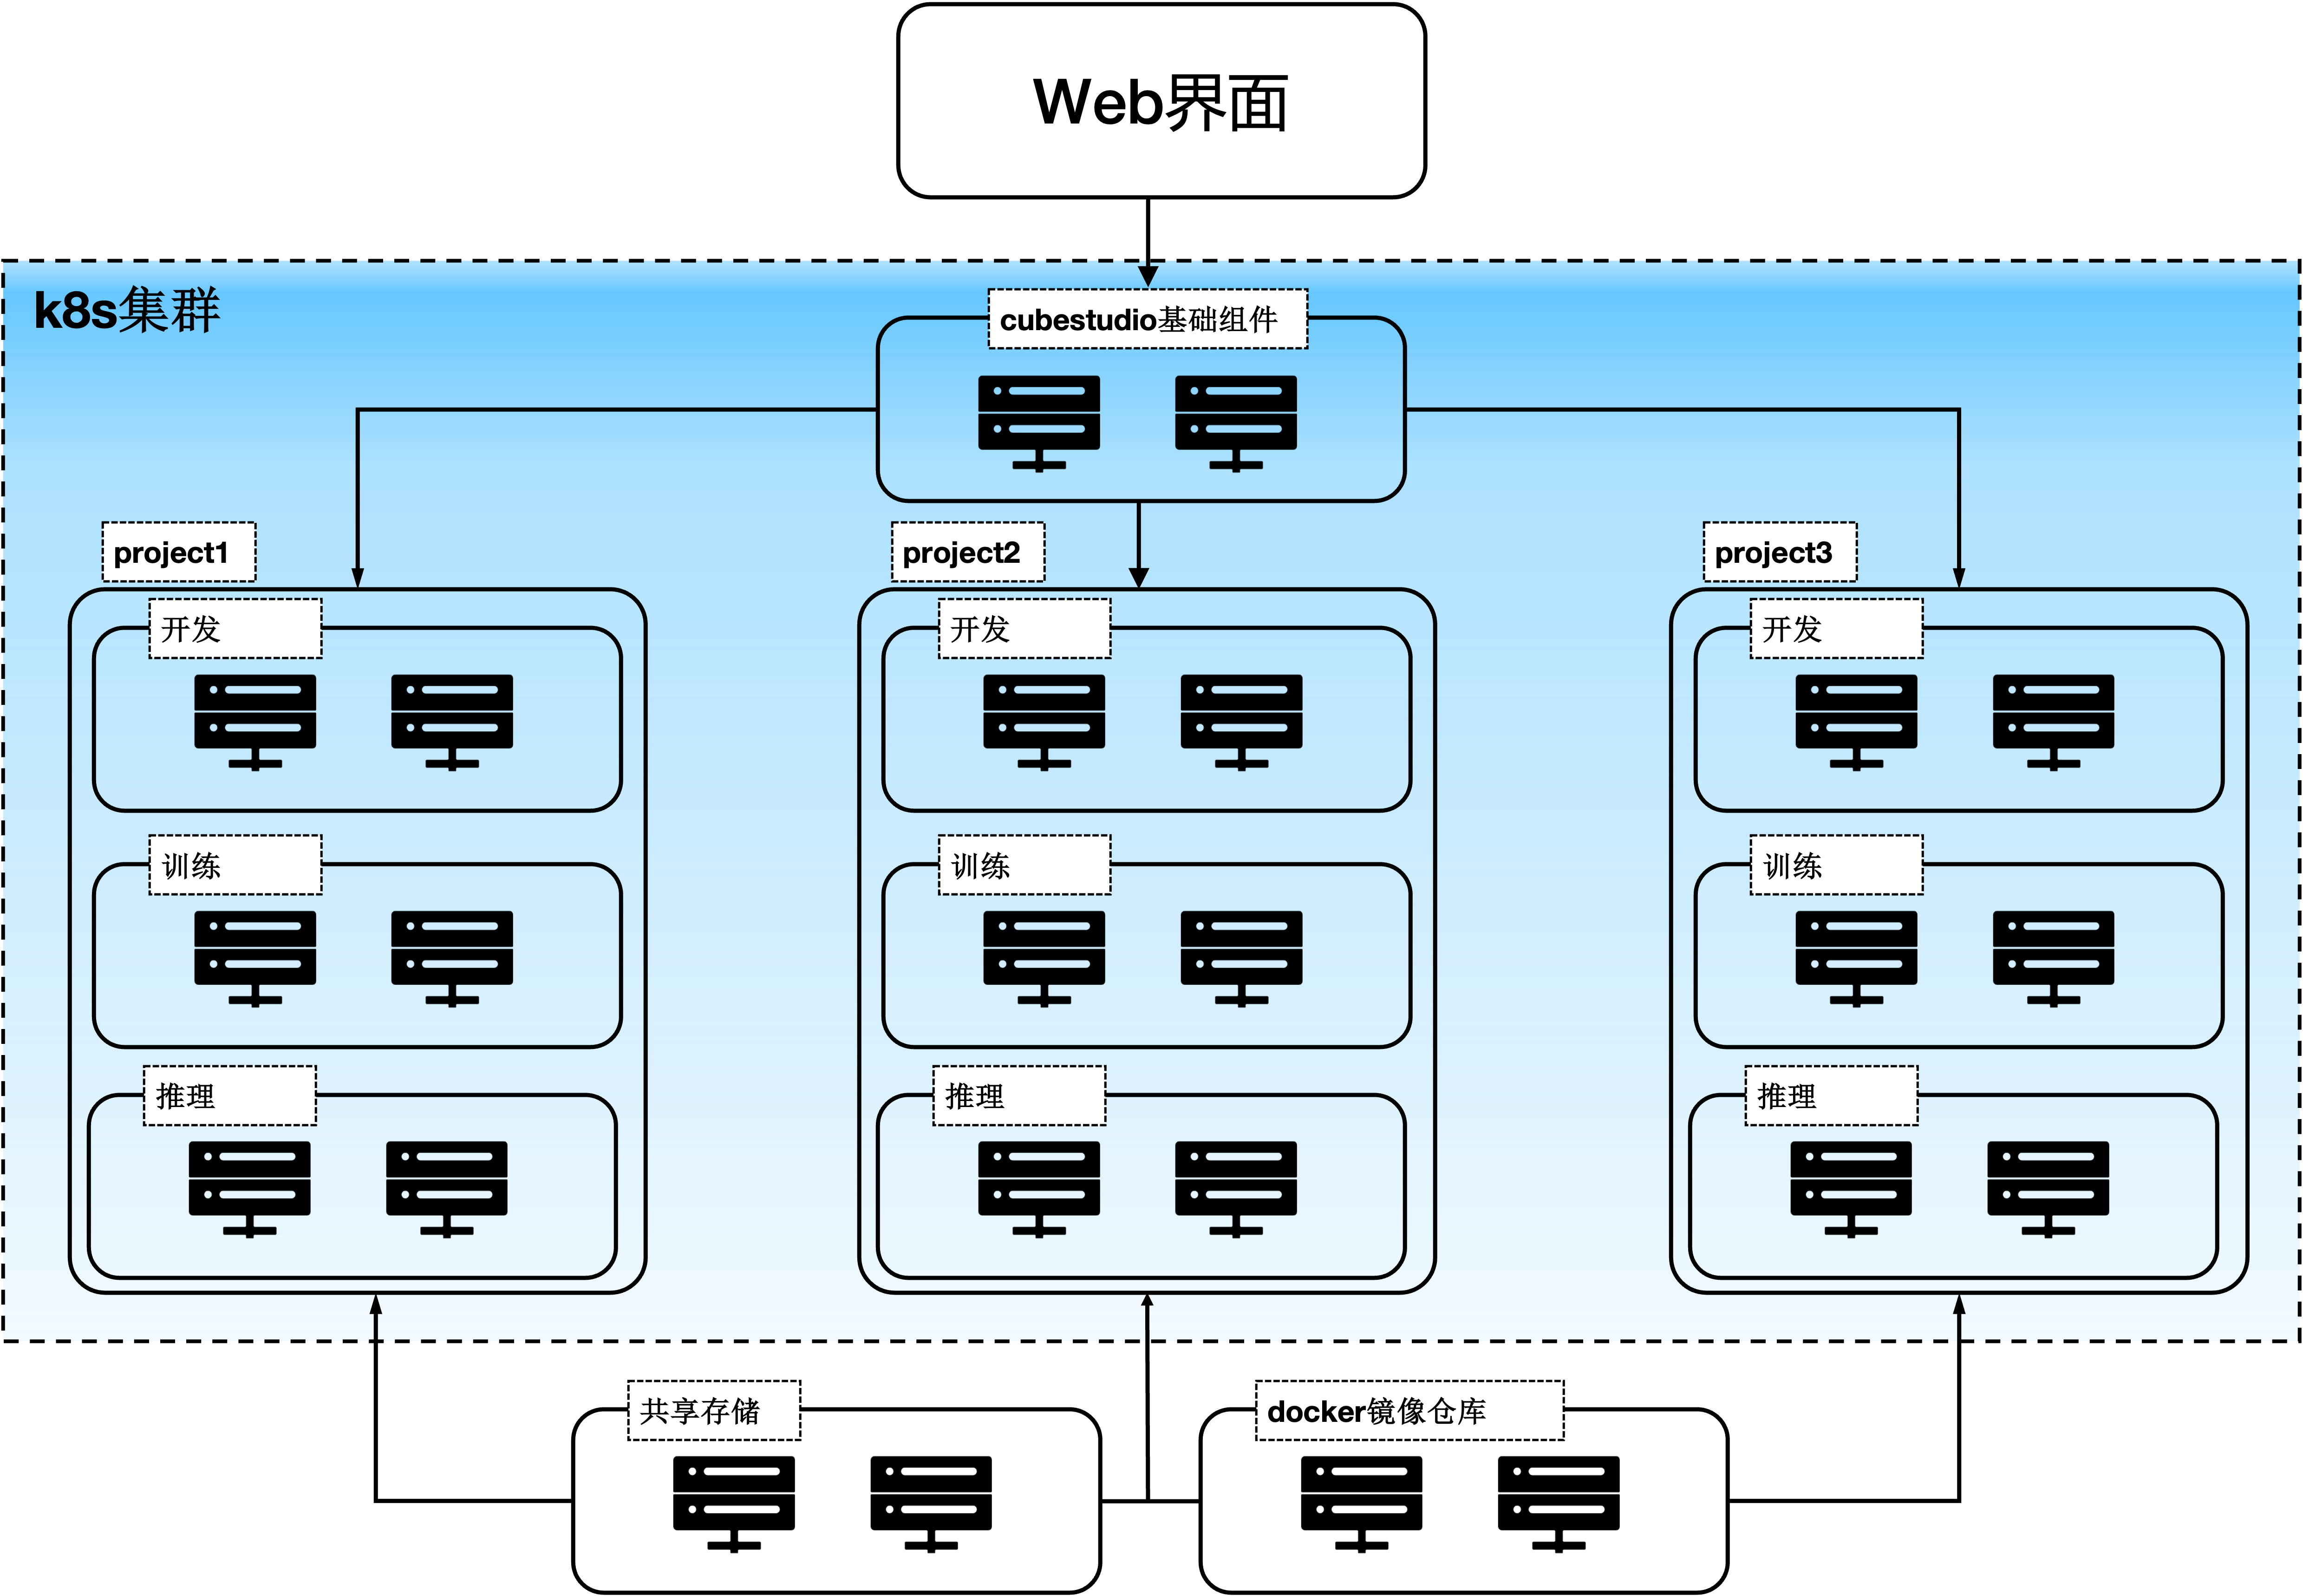
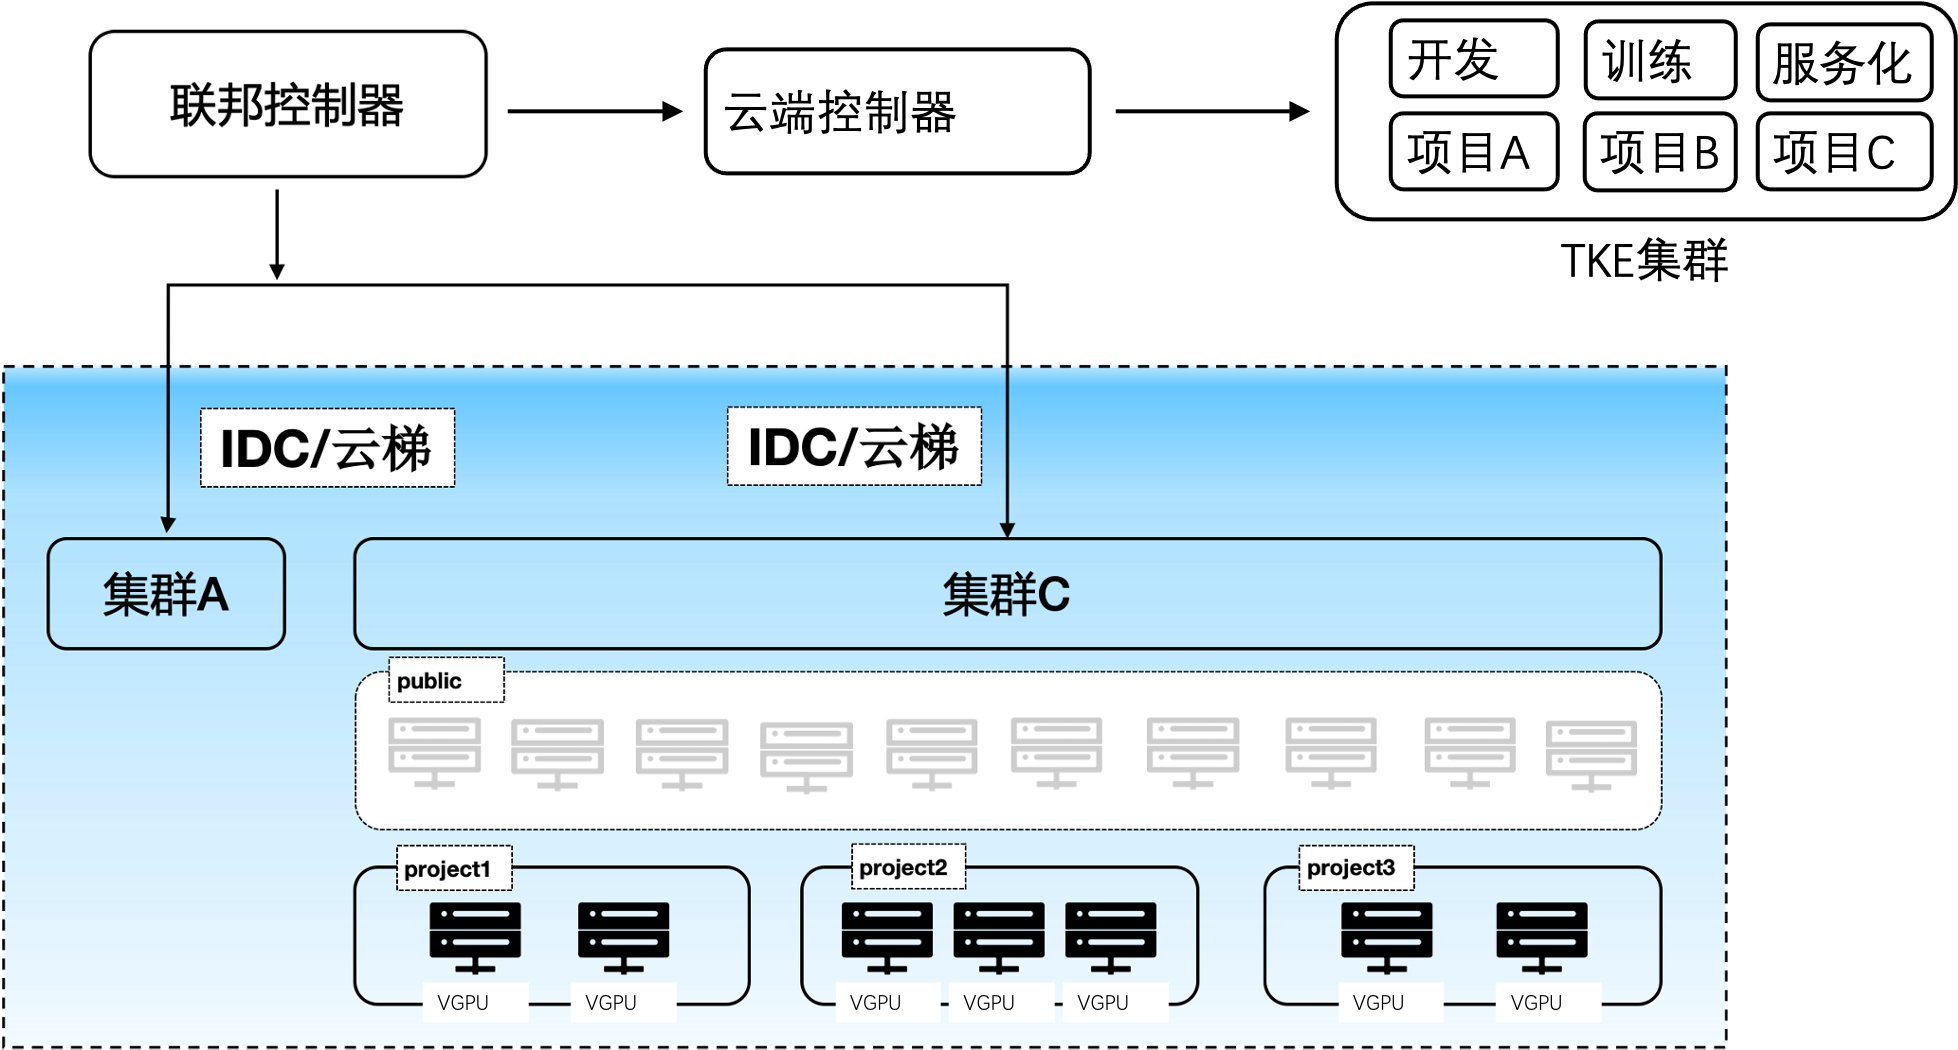
cubestudio 支持多集群调度,可同时管控多个训练或推理集群。单集群内既能隔离一个项目组的在线开发、训练、推理,也能隔离同一 k8s 集群下多个项目组的算力;不同项目组算力间具备动态均衡能力,可在公共算力池与私有化算力池间共享,做到成本最低化。
分布式存储
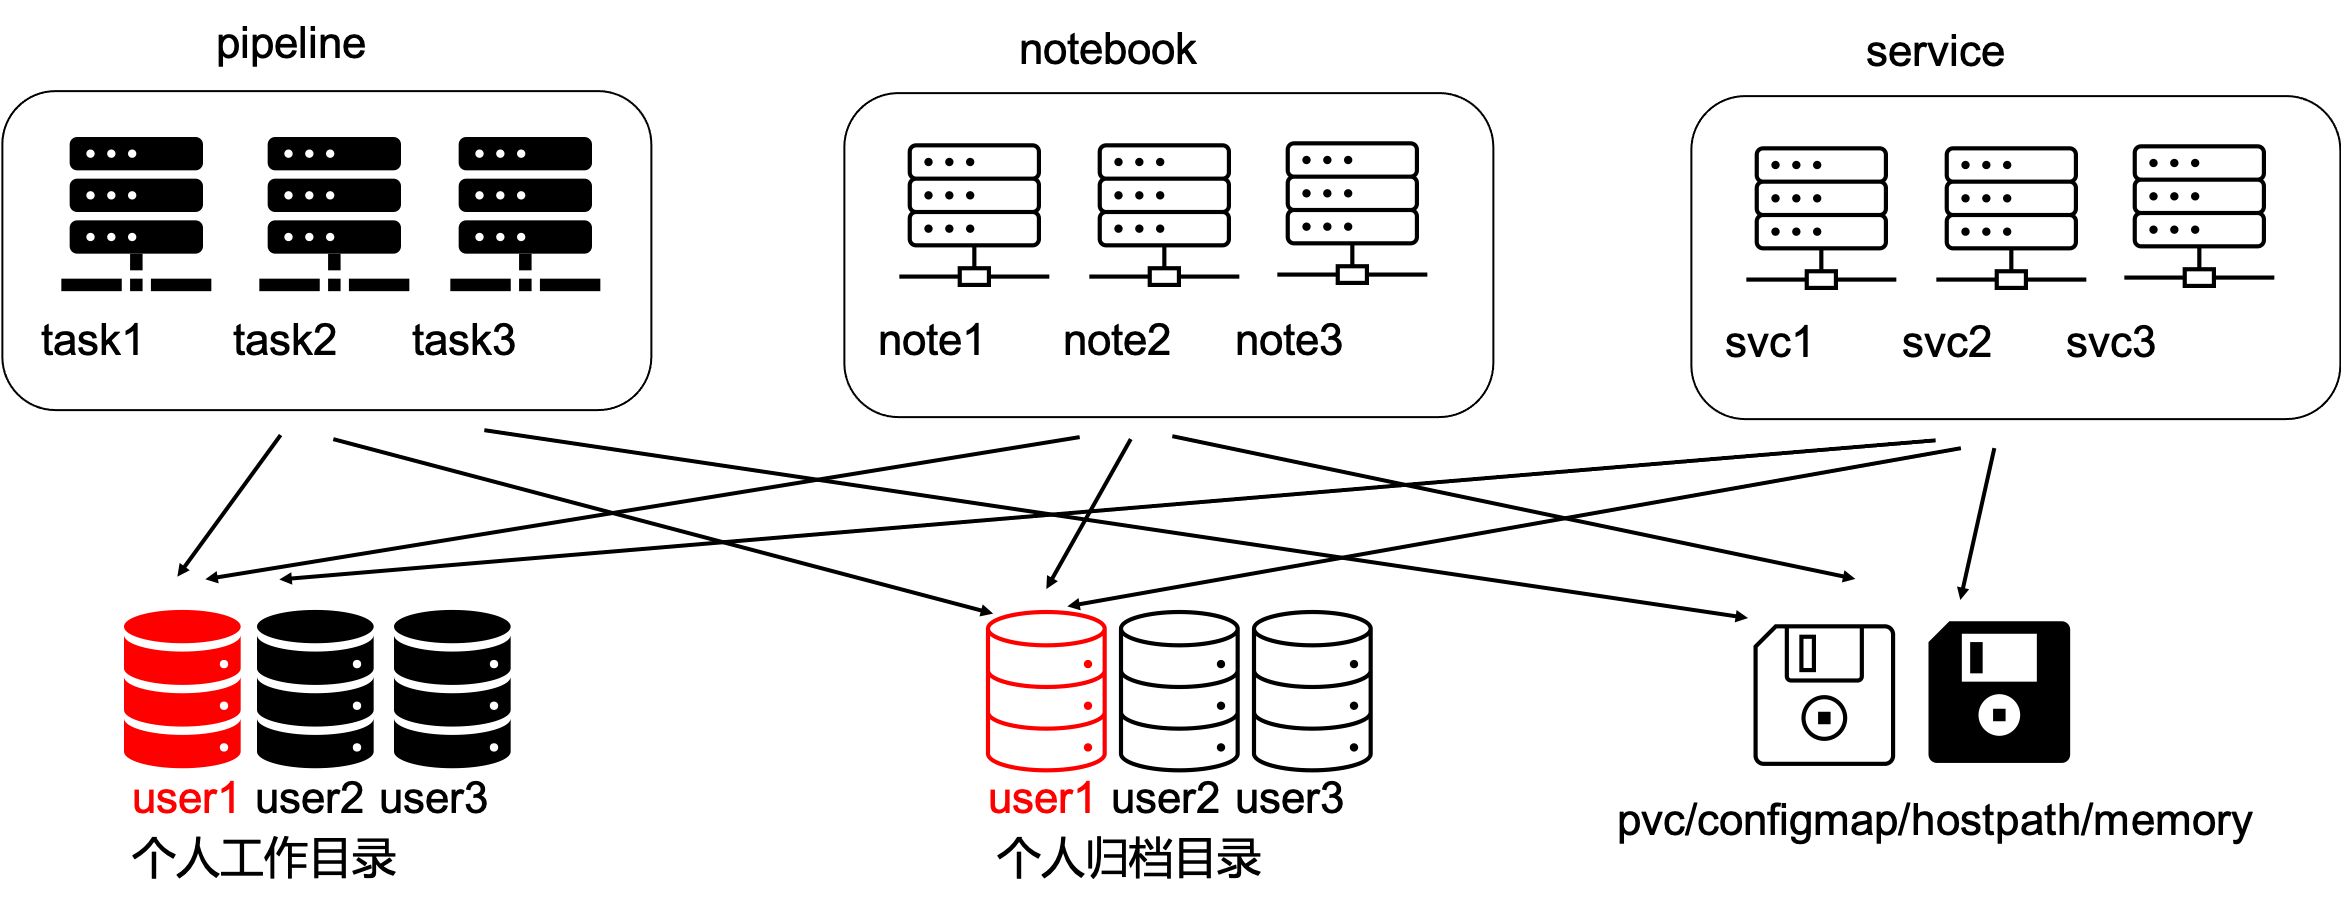
cubestudio 自动为用户挂载个人目录,同一用户在平台任意位置启动的容器,其个人子目录均为 /mnt/$username;可将 pvc/hostpath/memory/configmap 挂载为容器目录,并在项目组中配置默认挂载,实现组内共享同一目录等功能。
三、在线开发
浏览器即开发,多种在线 IDE 与镜像能力,无需本地安装。
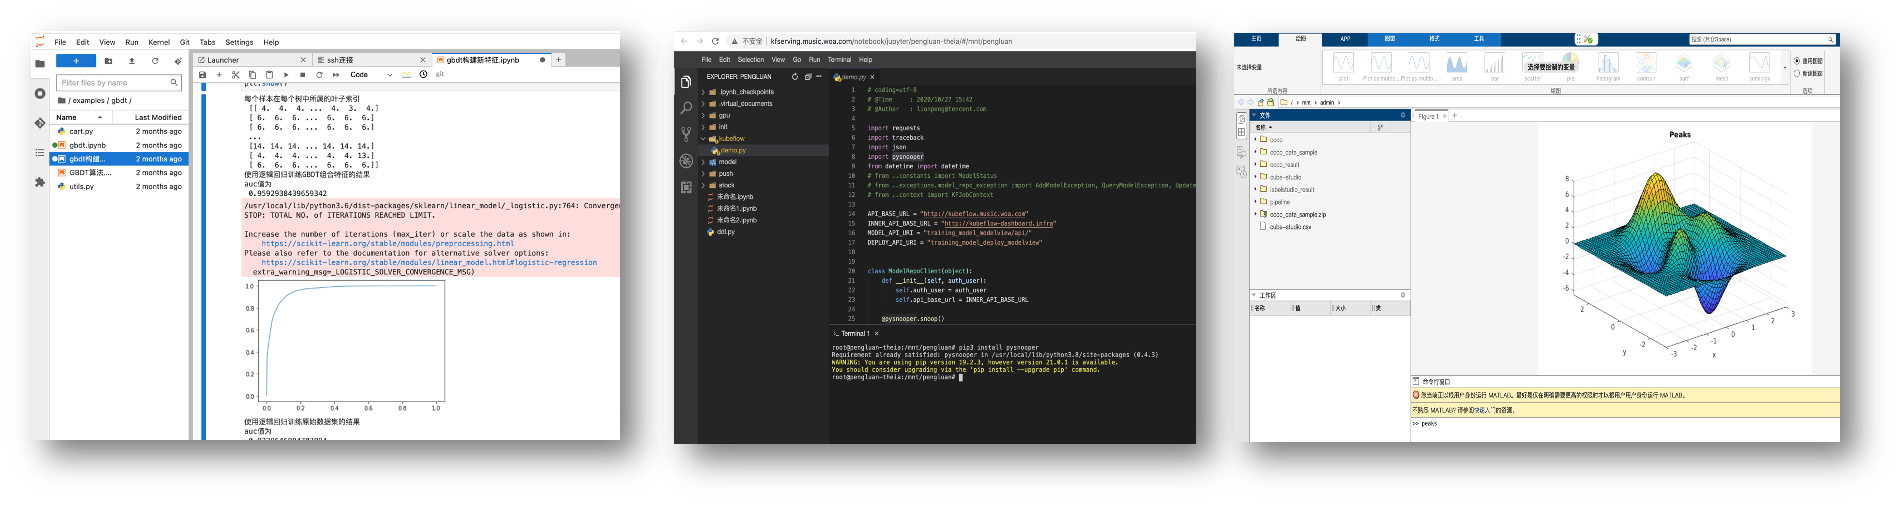
- 在线 IDE:基于 JupyterLab / VSCode 的在线交互开发,支持 Matlab、RStudio 等多种 IDE 类型,定期清理续期、环境保存;Jupyter 内置 cube-studio SDK,含 Julia、R、Python、PySpark 多内核版本。
- 多语言与插件:支持 C++、Java、Conda 等多种语言,及 TensorBoard / Git / GPU 监控等插件;SSH remote 与 Notebook 互通,可本地开发;提供汉化 IDE、大数据版内置 HDFS/Hive/Spark 客户端、SSH jumpproxy 单端口、多 Python 版本、在线对接 Claude Code、整卡 / 虚拟卡 / 共享 GPU 及华为 NPU / 海光 DCU / 沐曦在线开发。
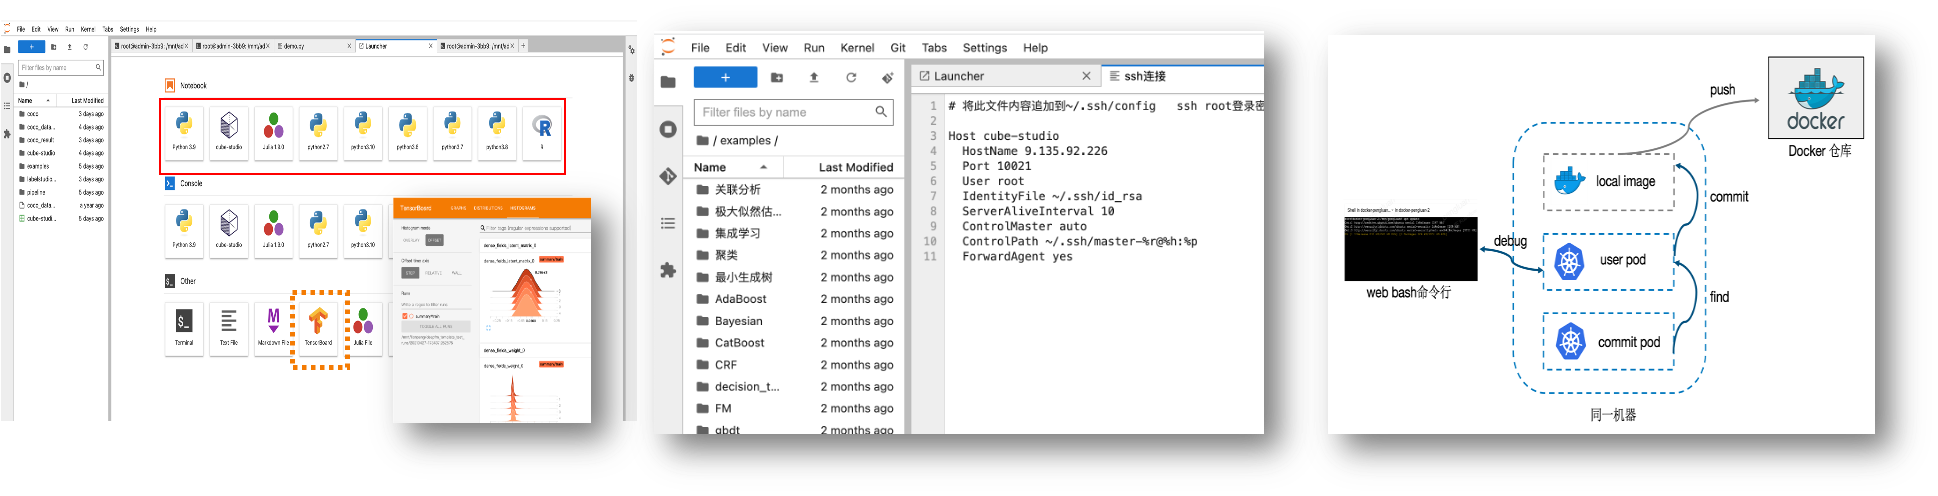
- 镜像功能:镜像仓库 / 管理 / 在线构建,通过 Web Shell 在浏览器中完成构建;提供 notebook、inference、gpu、python 等各版本基础镜像;支持同一仓库多秘钥配置与在线镜像构建。
四、数据管理与标注
打通数据接入、探索、标注与数据中台,为算法提供高质量样本。
- 数据地图与计算:元数据库表、指标、维表管理;SQLLab 交互查询,支持 MySQL、PostgreSQL、ClickHouse、Hive、Presto、达梦等计算引擎与数据分析建模。
- 数据集管理:随时上传图片 / 音频 / 文本等样本集,支持表格数据一键探索与详情预览。
可视化数据标注
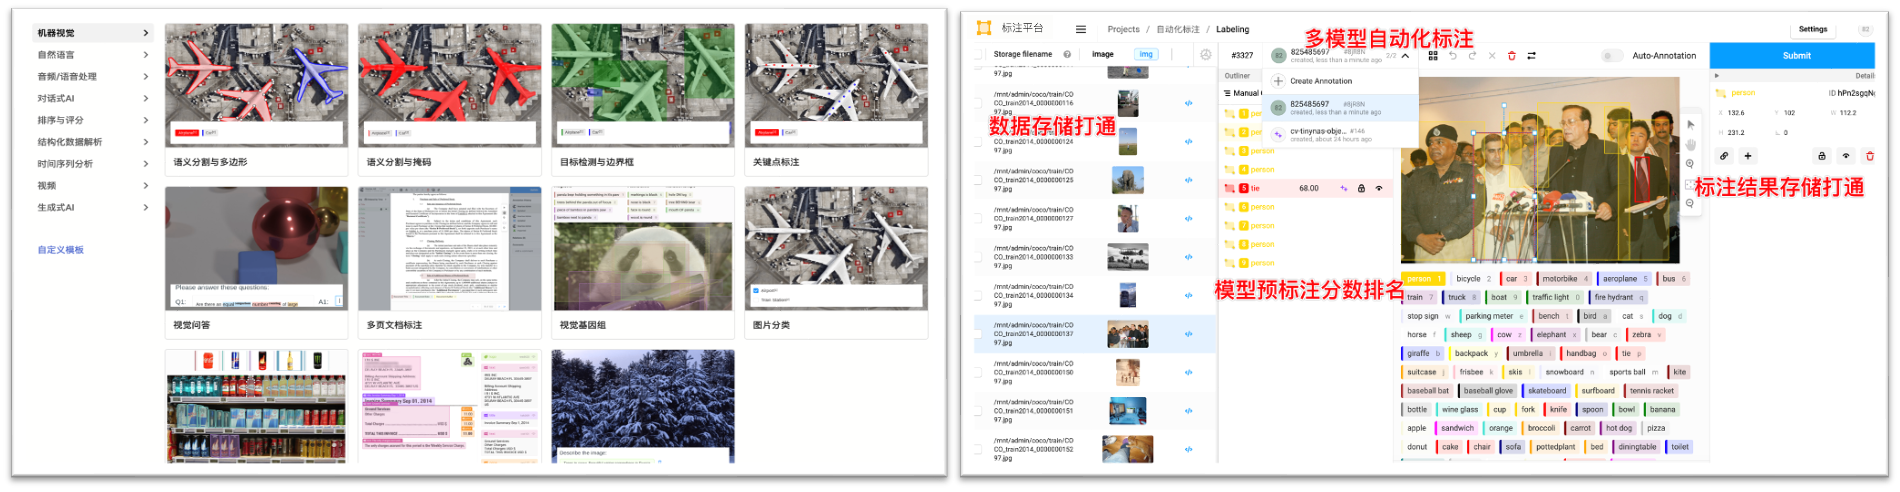
- 支持图 / 文 / 音 / 多模态 / 大模型多种类型标注,含用户管理、任务分发、项目组权限控制(草稿 / 审核 / 质量打分 / 批量导入导出);打通分布式存储与 MLOps 平台,与数据集模块互通。
- 自动化标注对接 AIHub 模型市场:目标识别、目标边界识别、目标遮罩识别、图片分类、图片描述、OCR、关键点检测、视频多目标跟踪、多说话人语音分隔、语音识别。
- 大模型自动化标注:文本分类、文本翻译、命名实体识别、阅读理解、问答、摘要提取、答案排序等。
数据中台对接
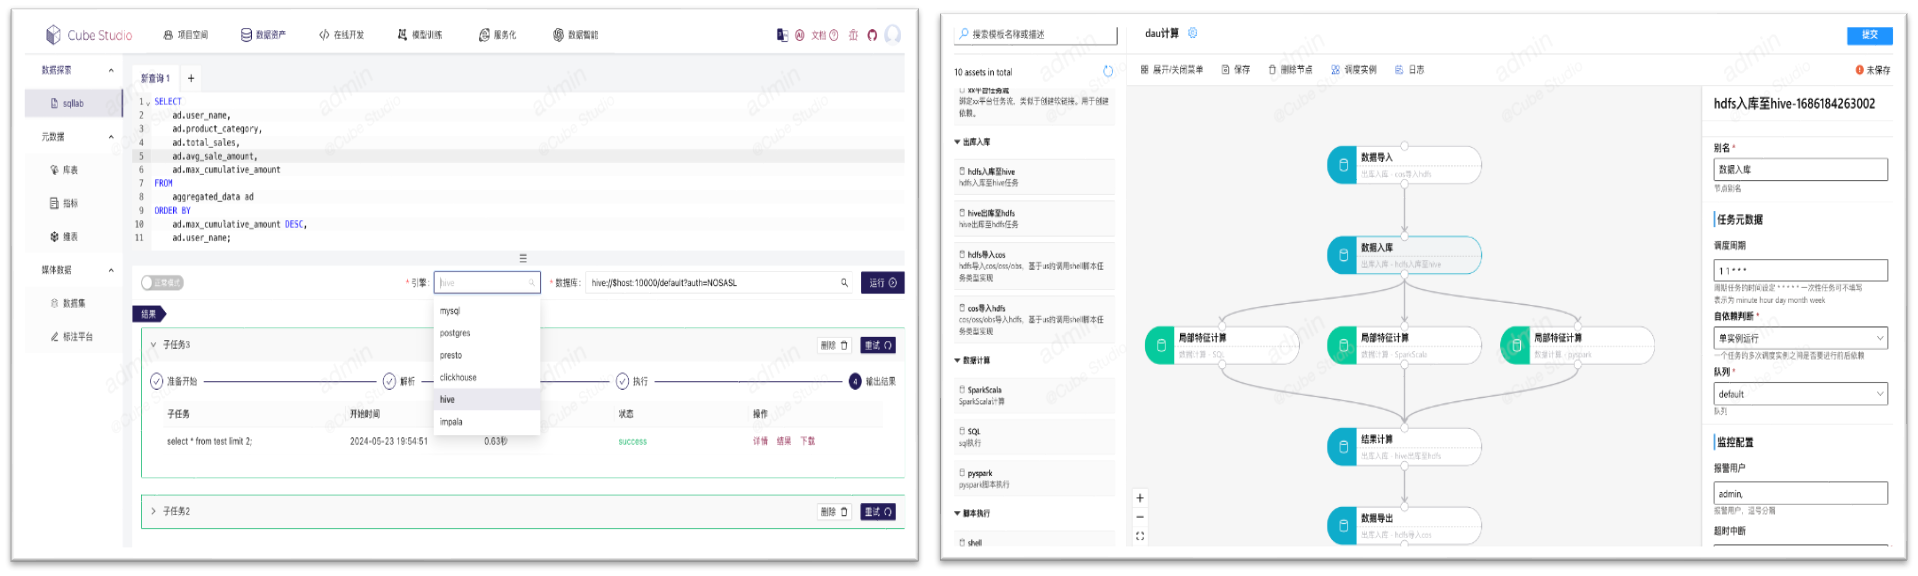
为加速 AI 算法平台的使用,cube-studio 支持对接公司原有数据中台,包括数据计算引擎 SQLLab、元数据管理、维表管理、数据 ETL、数据集管理,提供数据资产开发工具与数据 ETL 可视化链路。
五、模型训练
拖拉拽编排 ML 全流程,标准化算子 + 分布式训练 + 超参搜索,覆盖机器学习 / 深度学习 / 大模型。
拖拉拽建模流程
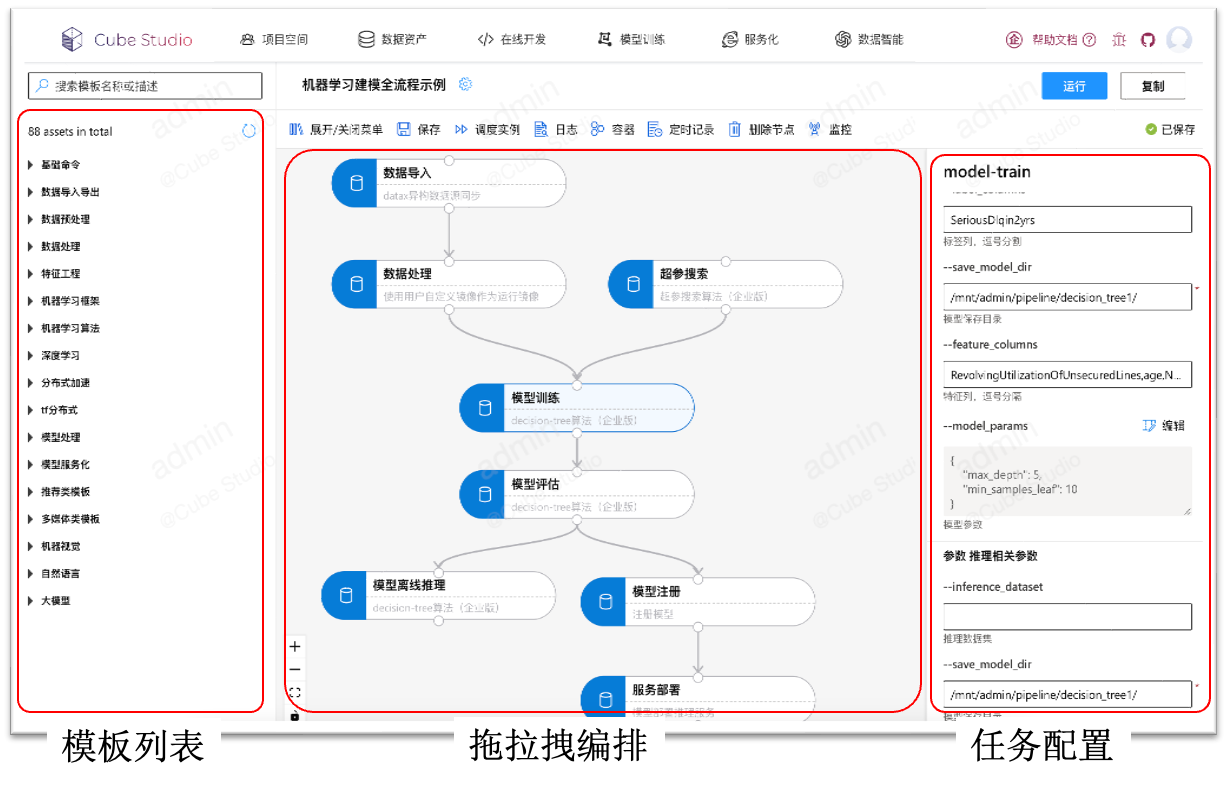
- ML 全流程:数据导入、数据预处理、超参搜索、模型训练、模型评估、模型注册、服务上线,覆盖机器学习 / 深度学习 / 大模型全流程。
- 灵活开放:便捷的拖拉拽方式编排算法 DAG,支持单任务与 Pipeline 整体等多种调试运行方式。
- 丰富多样的计算任务模板,支持自定义模板。
- 分布式计算:便捷的多机多卡分布式训练,通过标准化方式提供分布式计算与训练能力,提升大规模计算落地效率。
另支持多卡型 / RDMA / 多厂商 GPU 占用、独占共享占用、分布式模板调试用户镜像;任务输入输出与全局常量;文本 / 图片 / CSV/JSON / 表格 / echart 结果可视化;workflow 暂停恢复、运行中端口服务监听、定时调度最大保留实例数、任务流优先级。
多层次多类型算子
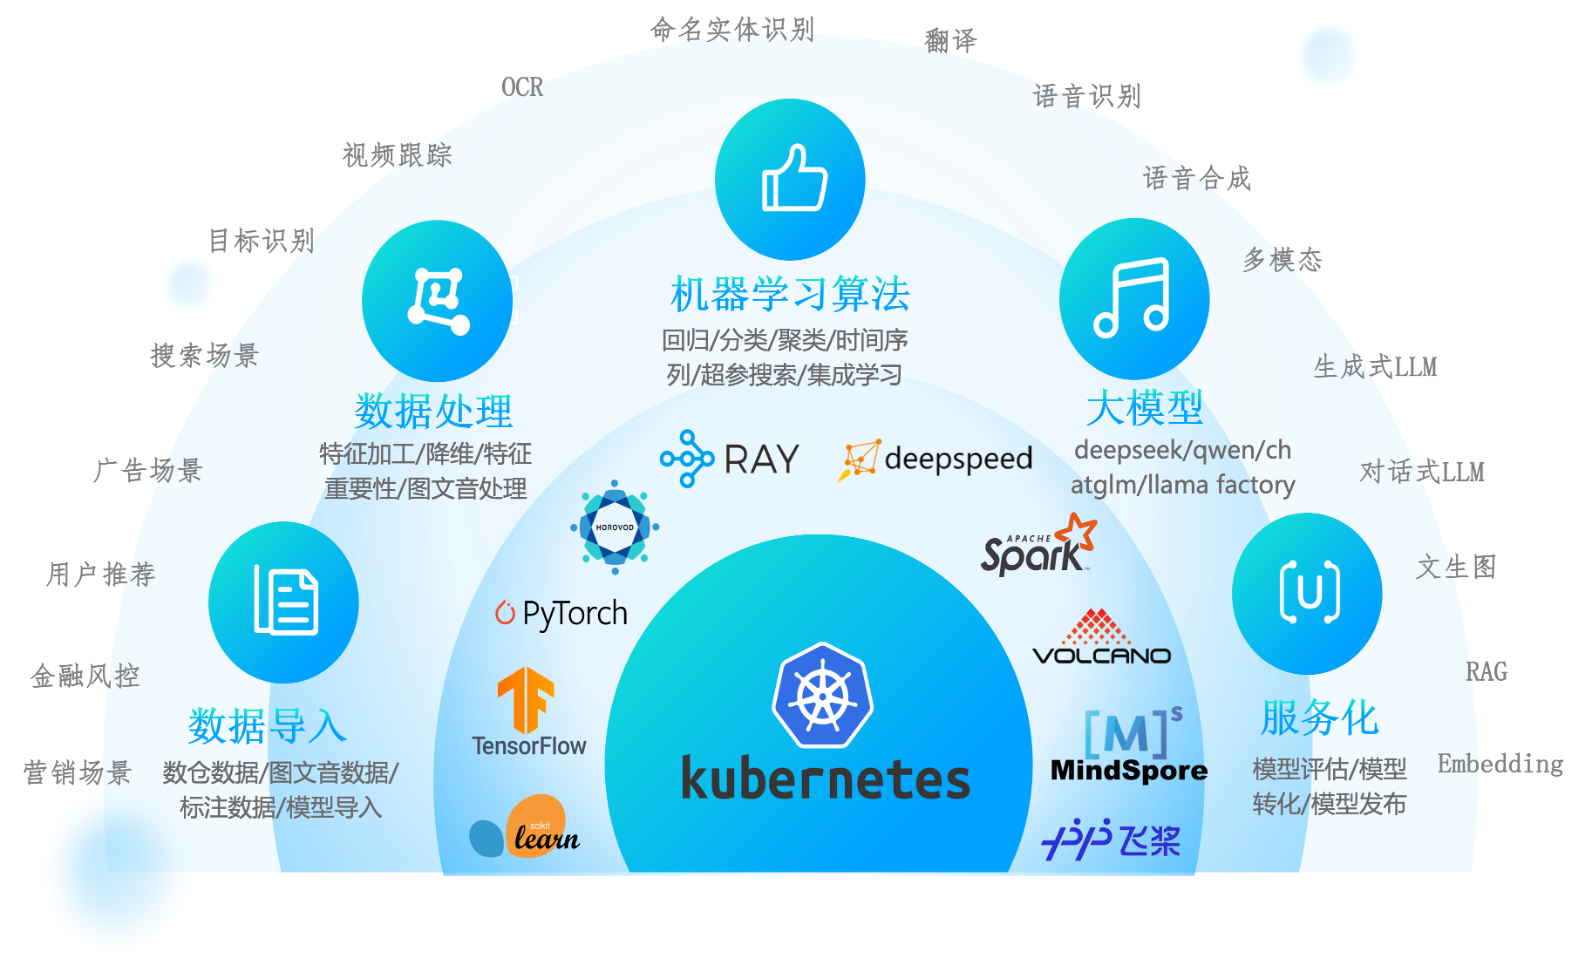
平台以 Kubernetes 为算力底座,向上纳管多种主流计算与训练框架,对外沉淀为标准化算子库,形成"底座 — 框架 — 算子 — 场景"分层能力:
- 框架底座:统一编排 PyTorch、TensorFlow、scikit-learn、Horovod、Ray、DeepSpeed、Spark、Volcano、MindSpore、飞桨(PaddlePaddle)等训练与分布式加速框架。
- 算子分层:由基础功能、特征处理、数据处理、传统机器学习、分布式深度学习、预置模型、模型服务化直至大模型训练/微调/量化评估等构成标准化算子库,如下表:
| 算子分层 | 能力说明 |
|---|---|
| 主流功能算子 🟢 | 基础算子(自定义镜像、逻辑节点、python);数据同步(数据集导入、模型导入)。支持 HuggingFace/魔搭数据集与模型导入,datax / datax-import(MySQL/PostgreSQL/ClickHouse)。 |
| 特征处理算子 🔵 (pipeline 算子) | 数据合并/去重/变换(boxcox、二值化、DCT、多项式展开等)、非数值变量处理、异常值检测、统计量、缺失值处理与填充、离散化、标准化/归一化、索引处理、排序、执行 SQL、特征组合、PCA/卡方降维、特征重要性(随机森林/逻辑回归/XGBoost,IV/互信息/方差)、相关性计算、数据拆分、多种采样。 |
| 数据处理工具 🟢 | volcanojob / ray 分布式数据处理、媒体分布式下载与视频提取图片。Hadoop(HDFS/Hive/Spark);文本处理(paddleocr-vl 提取 Markdown、问答对提取扩展、清理/过滤/隐私替换/统计);图像处理(质量评估、去噪、缩放、标准化、裁剪、均衡化、空间与几何变换)。 |
| 传统机器学习 ⭐🟢 | sklearn 单机、ray-sklearn 分布式、XGB 单机训练推理;AR/ARIMA、随机森林(含回归)、LR、LightGBM、KNN、KMeans、GBDT、决策树、PCA、LDA、CatBoost、XGB 及超参搜索。 |
| 分布式深度学习 🟢 | TF / PyTorch 分布式多机多卡训练框架。 |
| CV/NLP/语音预置模型 ⭐🟢 | OCR 文字检测识别(paddleocr)、实例分割(swinb)、图像分类(vit)、文本分类(structbert)、语音合成 TTS(paddlespeech)。 |
| 模型处理与服务化 🟢 | 模型注册、离线处理、部署。模型评估、模型格式转换。 |
| 分布式多机多卡训练 | MPI / Colossal-AI / DeepSpeed / Horovod / Megatron / MindFormer / MXNet / PaddleJob / MindSpore 分布式训练加速框架。 |
| 大模型微调 | DeepSeek/ChatGLM/Qwen/LLaMA LoRA 微调、MindFormers 微调;LLaMA-Factory 大模型 SFT/奖励模型/强化学习;NPU/DCU/沐曦适配的 LLaMA-Factory。 |
| 量化 / 评估 / 剪枝 | 大模型量化;OpenCompass 大模型评估;大模型剪枝。 |
- 场景覆盖:营销场景、金融风控、用户推荐、广告场景、搜索场景、目标识别、视频跟踪、OCR、命名实体识别、翻译、语音识别、语音合成、多模态、生成式 LLM、对话式 LLM、文生图、RAG、Embedding 等,支持自定义算子扩展。
模板自定义
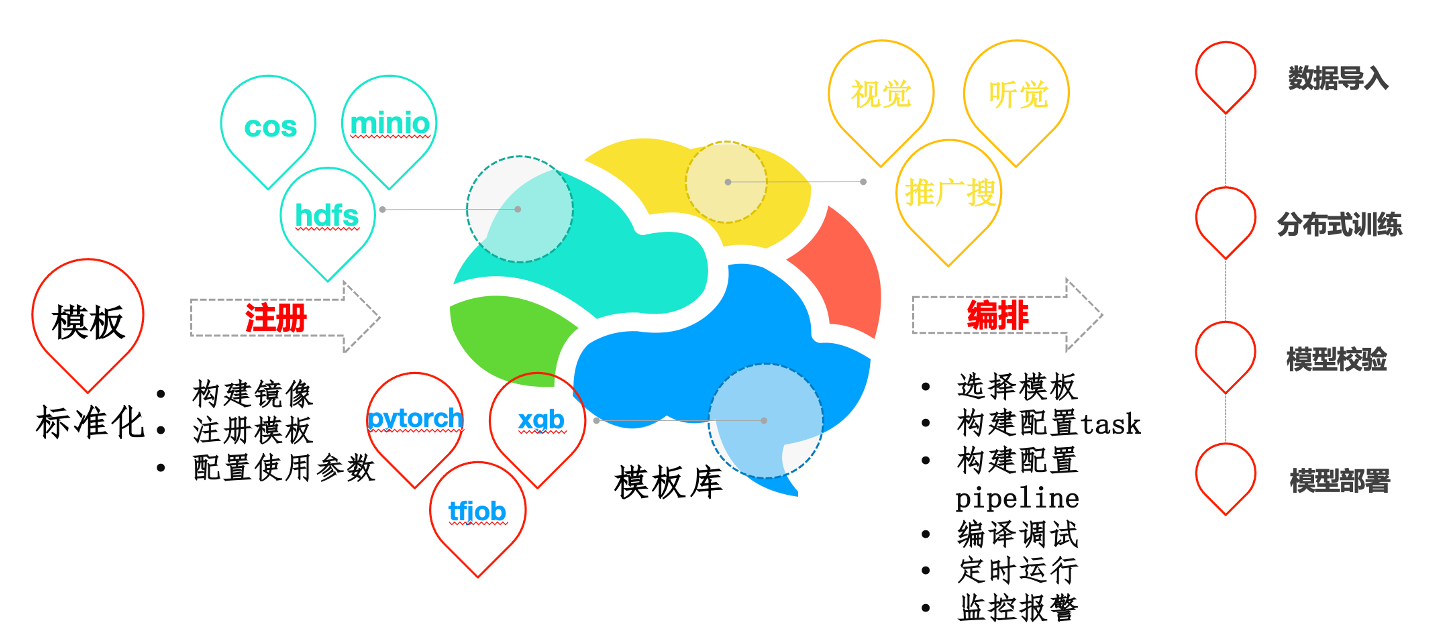
如上图所示,模板机制贯穿"标准化 — 注册 — 模板库 — 编排"全流程:
- 模板标准化 → 注册:将算法能力标准化后完成"构建镜像、注册模板、配置使用参数",沉淀为可复用组件;模板支持 int/float/list/bool/json 型,子类型支持 workdir/image/select-input/project 型与参数 tip 提醒。
- 模板库:统一纳管存储(COS / MinIO / HDFS)、框架(PyTorch / XGB / TFJob 等)与领域能力(视觉 / 听觉 / 推广搜),形成能力资产库。
- 编排:通过"选择模板 → 构建配置 task → 构建配置 pipeline → 编译调试 → 定时运行 → 监控报警"快速搭建应用,落地到数据导入、分布式训练、模型校验、模型部署等环节。
其核心价值:相比非模板开发建立应用成本更低、无需从零开发平台;模板标准化后迁移迭代只需迁移配置模板;算法与工程分离,避免重复开发。
流水线调试
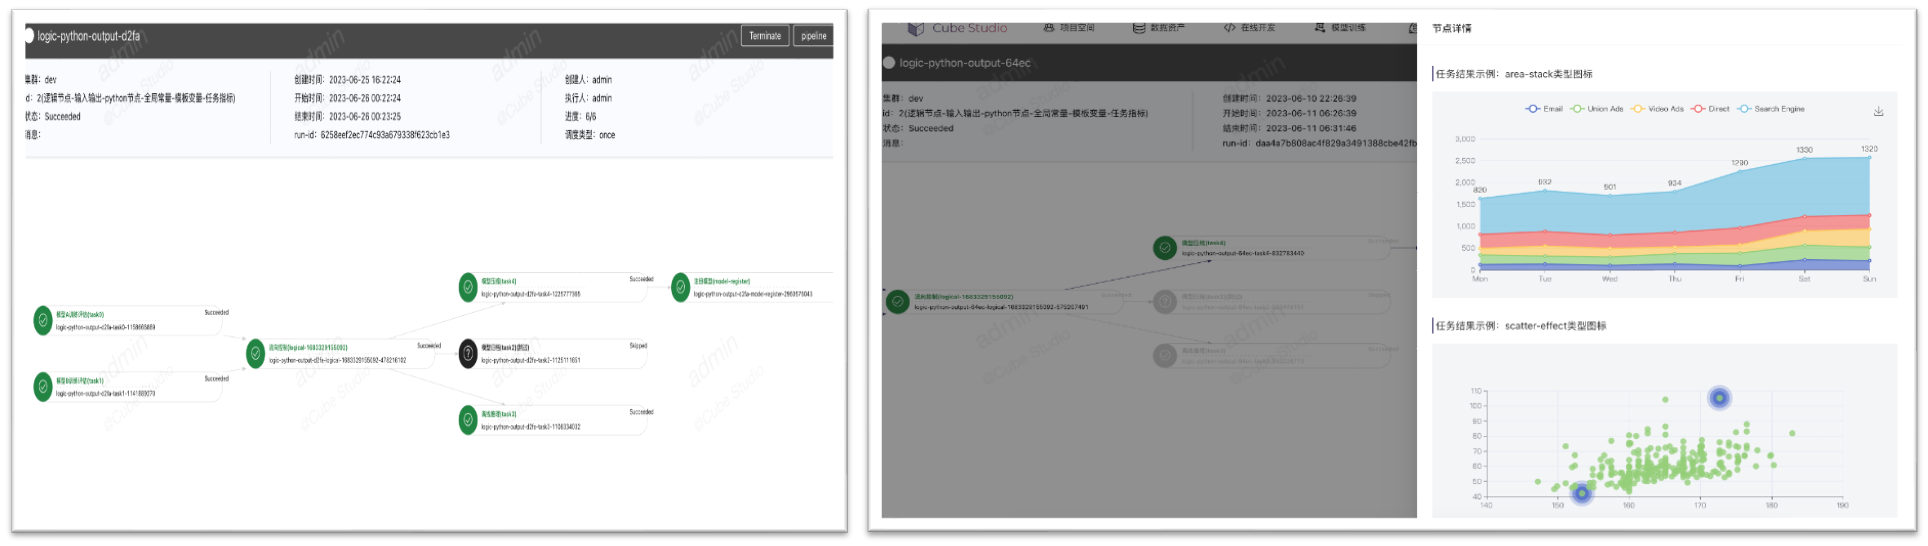
- Pipeline 调试支持定时执行、补录、并发限制、超时、实例依赖等。
- Pipeline 运行支持任务间变量输入输出、全局变量、流向控制、模板变量、数据时间等。
- Pipeline 运行支持任务结果可视化:图片、CSV/JSON、ECharts 源码可视化。
分布式训练
- 支持 TF / PyTorch 分布式多机多卡训练框架,通过标准化方式提供大规模计算与训练能力。
超参搜索
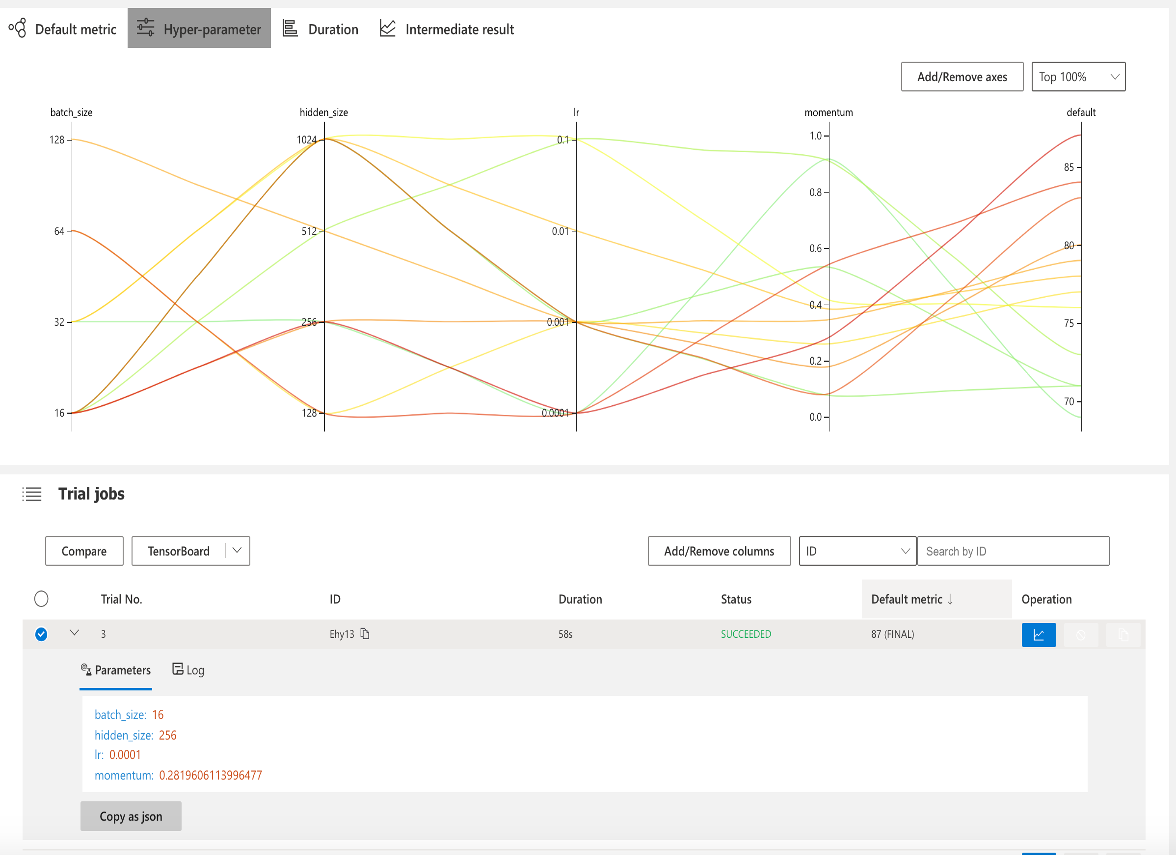
- 界面化呈现训练各组数据,通过图形界面直观展示,支持单机 / 分布式自动超参搜索。
- 减少调参过程的枯燥感,让调参更生动,无需丰富经验即可实现更精准的参数控制调节。
# 上报当前迭代目标值
nni.report_intermediate_result(test_acc)
# 上报最终目标值
nni.report_final_result(test_acc)

# 接收超参数为输入参数
parser.add_argument('--batch_size', type=int)
六、推理服务
零代码将模型发布为在线推理服务,支持多集群、异构 GPU、弹性伸缩与灰度治理。
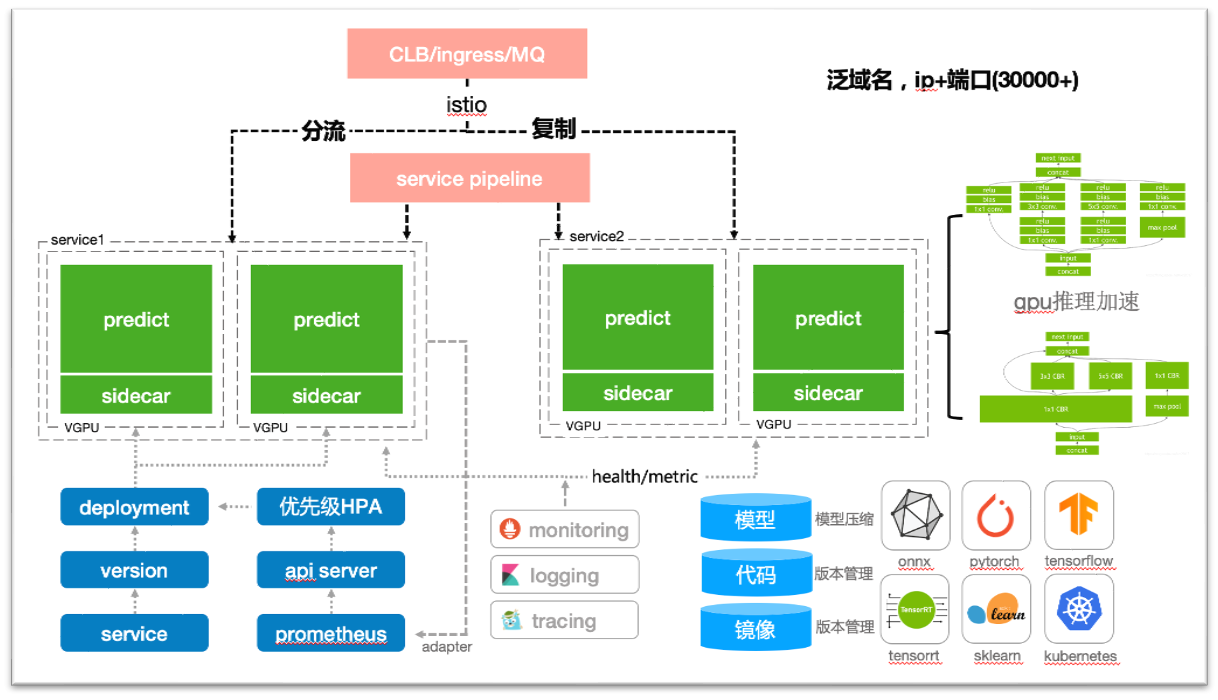
- 模型管理:模型多版本管理、指标可视化,支持在 Pipeline 中注册并一键发布为推理服务,含灰度发布、版本回退。
- 推理服务:支持 ML/TF/PyTorch/TensorRT/ONNX/Triton/LLM 模型零代码发布;GPU 卡型选择、CPU/Mem 弹性伸缩、泛域名、配置挂载、启动命令 / 环境变量 / 端口 / 健康检查;调试与生产环境、资源与流量监控;支持 vGPU / 独占 / 共享、GPU 弹性伸缩、服务优先级、随机 / header 分流、限流、流量复制、sidecar、多版本滚动升级与回滚、JWT 认证、定时伸缩容与在线测试;支持 vLLM / MindIE 大模型分布式推理。
- 内部服务:快捷部署 mysql-web、redis-web、neo4j、rstudio 等开发运维工具,及 ollama、xinference 大模型推理。
七、监控
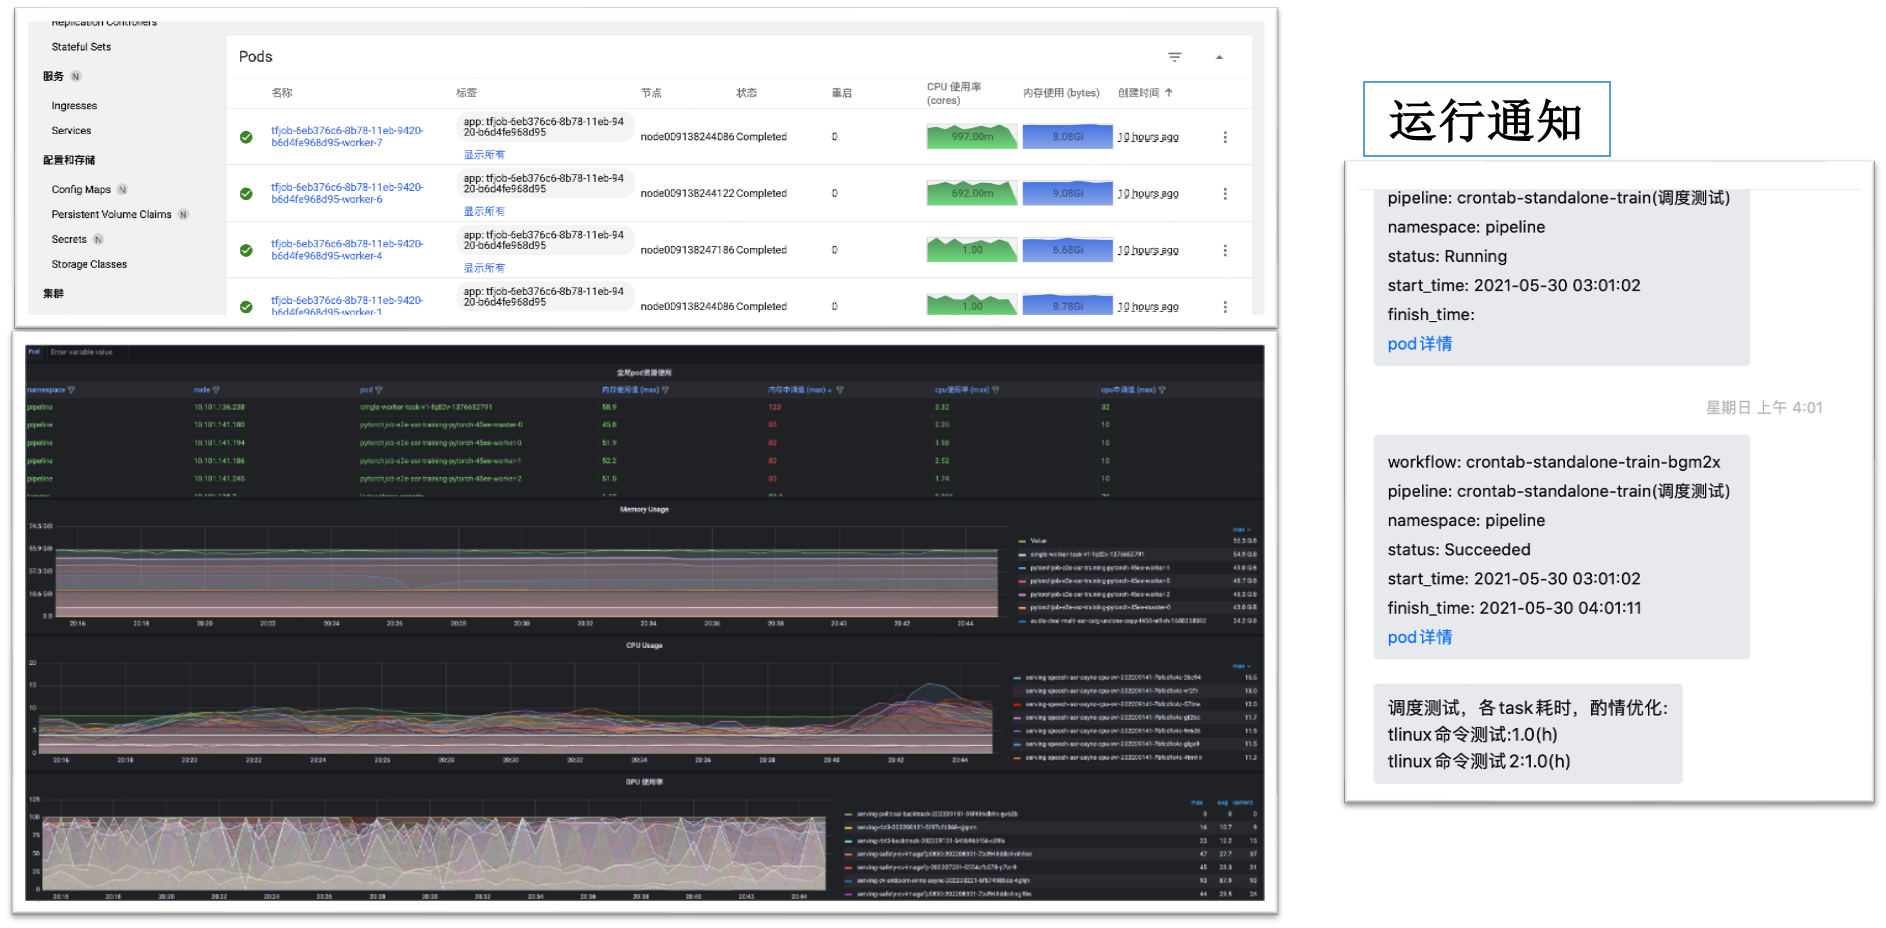
平台提供从底层资源到任务运行的全链路监控与主动报警能力:
- 资源监控(K8s Dashboard):可视化查看 Pod、Ingress、Service、ConfigMap、PVC、Secret、StorageClass、集群等资源;实时展示每个 Pod 的名称、标签、所在节点、运行状态、重启次数、CPU 使用率(cores)、内存使用(bytes)与创建时间。
- 资源大盘(Prometheus / Grafana):按 namespace / node / pod 维度聚合全局资源使用,提供 Memory / CPU / GPU 使用率时序曲线与申请值 / 使用峰值统计;覆盖机器 GPU / 内存 / CPU / 网络 IO / 磁盘 IO 负载、Pod 与推理服务的 QPS / 吞吐 / vGPU 负载、IB 流量与 NPU 监控,便于容量评估与资源优化。
- 运行通知与报警:Pipeline / Workflow 任务在 Running、Succeeded、Failed 等状态变更时主动推送通知,消息含名称、namespace、状态、起止时间及 Pod 详情跳转链接;支持各 task 耗时统计与调度优化建议,报警可推送至邮件、企业微信、钉钉、飞书,并提供统一 webhook 接口。
八、AIHub 模型市场
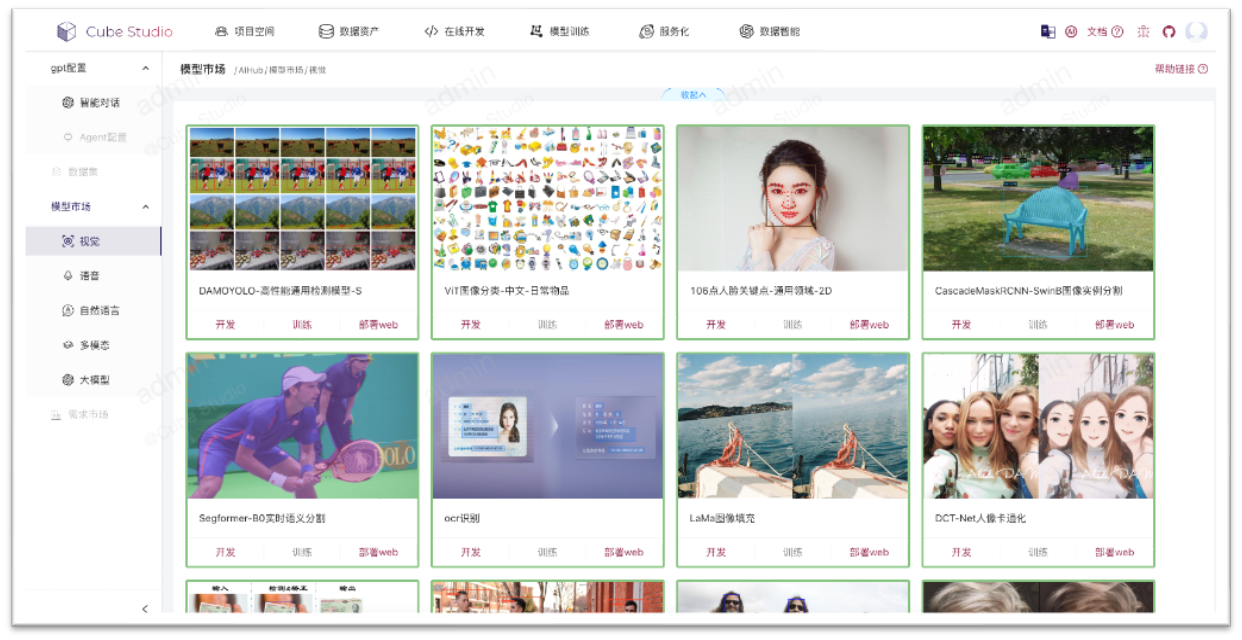
面向模型复用与快速落地的模型市场,一键部署 / 开发 / 微调:
- 定义标准模型应用开发框架,对接 MLOps 平台实现模型的一键部署 / 开发 / 微调。
- 系统自带机器视觉 / 自然语言 / 语音音频 / 多模态 400+ 通用预训练模型,覆盖绝大多数行业场景,可按需自行扩充。
- 生态兼容:同时支持 Hugging Face、魔搭 ModelScope、飞桨生态及自研模型,实现部署 / 开发 / 微调 / 上线全链路。
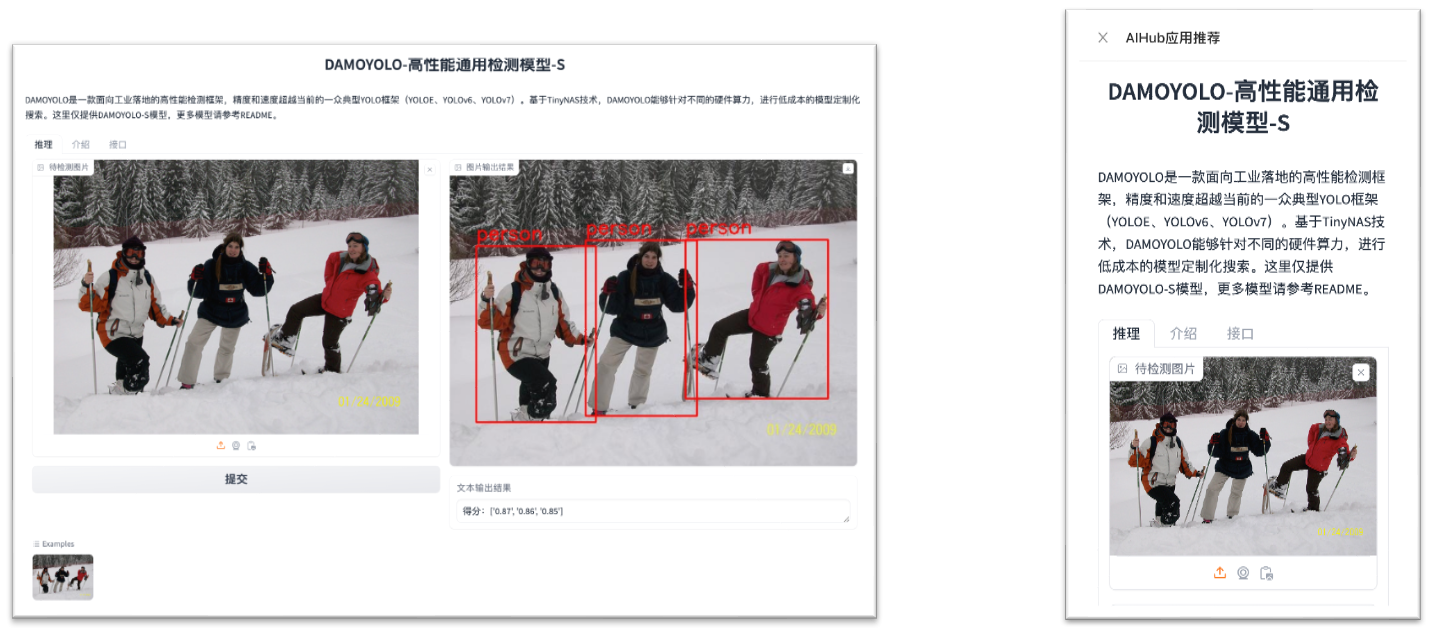
- 一键部署:AIHub 模型一键部署为 Web 端应用,手机端 / PC 端皆可,实时查看模型应用效果(含 PC 版、手机 / 微信版),并可对外提供 API 或部署为推理服务。
- 一键开发:点击"模型开发"即可进入 Notebook 进行代码二次开发。
- 一键微调:点击"训练"转 Pipeline 微调链路(示例数据下载 → 微调 → 模型注册 → 部署),加入自有数据即可贴合自身场景。
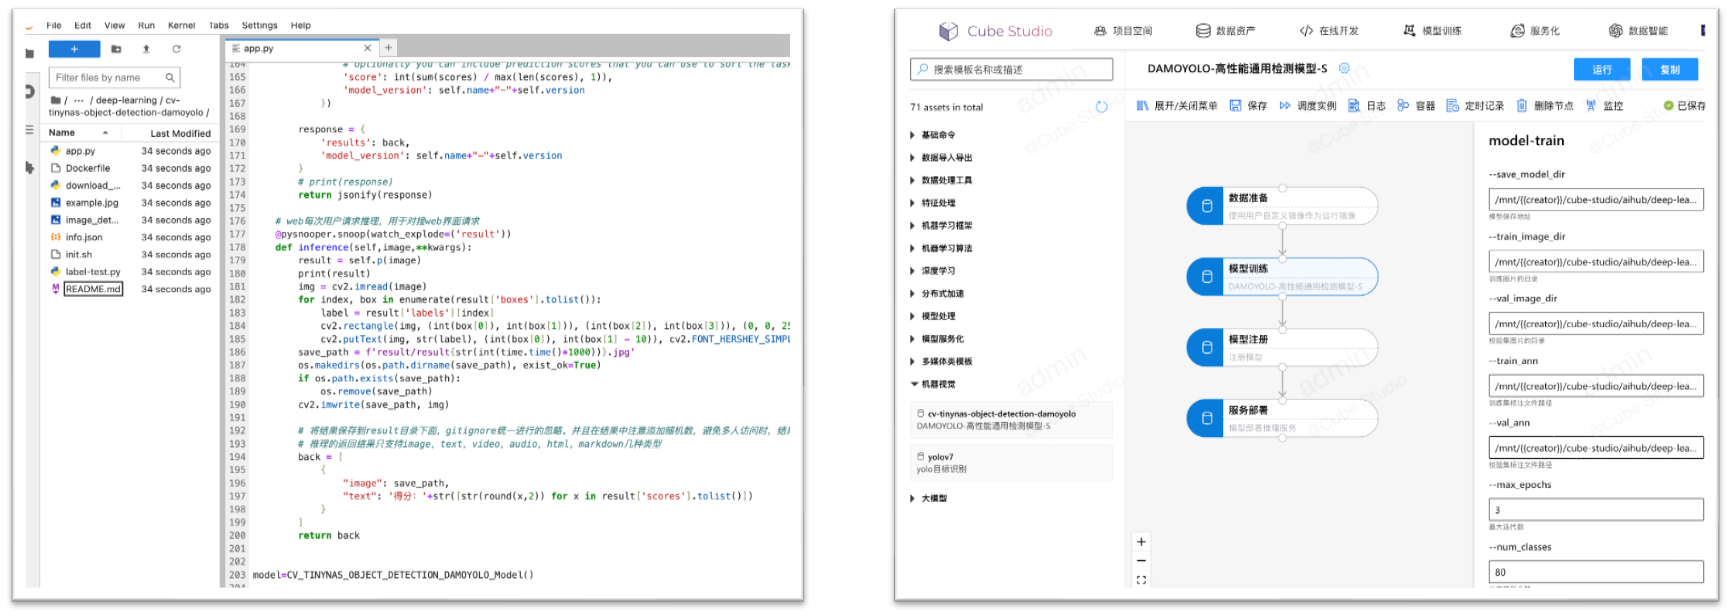
- 标注与编排对接:部署对接 LabelStudio 做自动化标注;代码目录可注册为 AIHub 应用,Pipeline 亦可调用 AIHub 应用做数据处理。
九、大模型
面向大模型训练、微调、推理、评估与智能对话的完整能力。
自动化标注
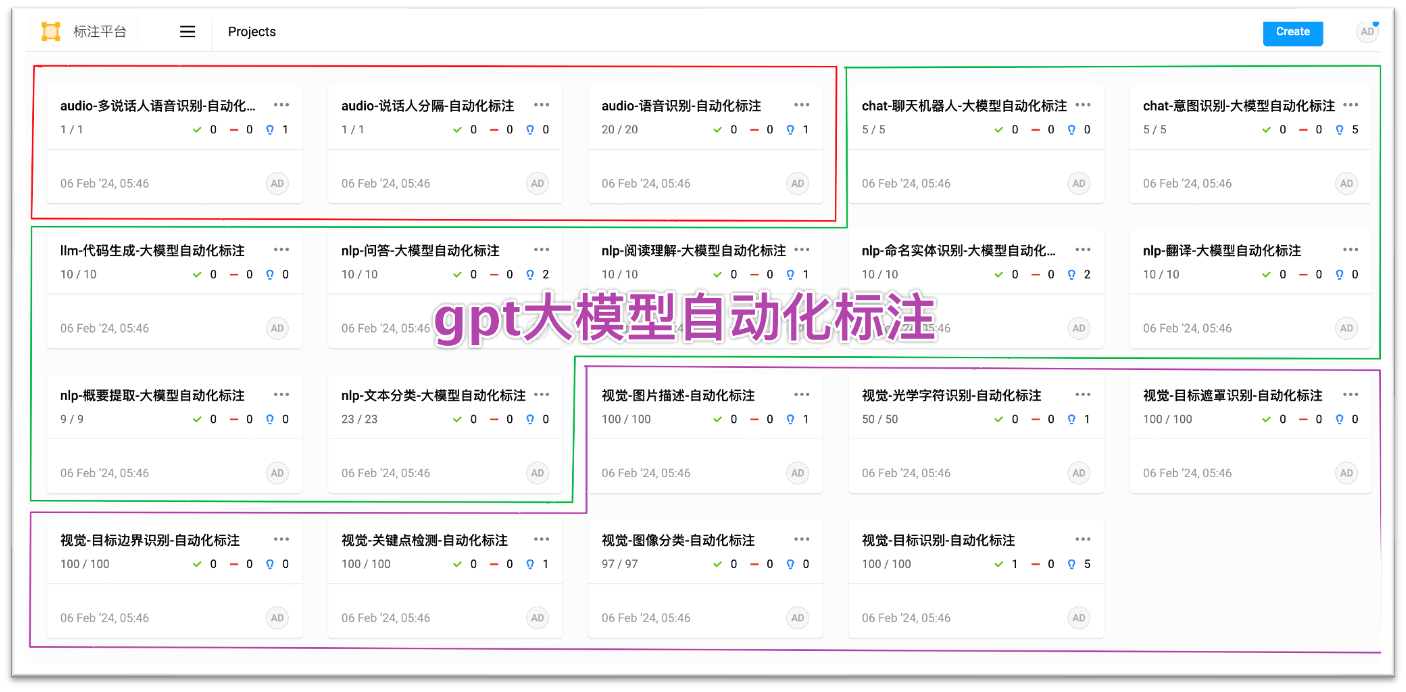
- 借助大模型进行常规 NLP 任务的自动化标注(问答、阅读理解、命名实体识别、翻译、概要提取、文本分类等)。
- 支持问答数据、阅读理解问答、问答排序等大模型 / 奖励模型语料数据标注。
- 同时覆盖 audio 语音(语音识别、说话人分隔)、chat 会话(意图识别)、视觉(图片描述、OCR)等多模态自动化标注。
大模型微调(分布式框架)
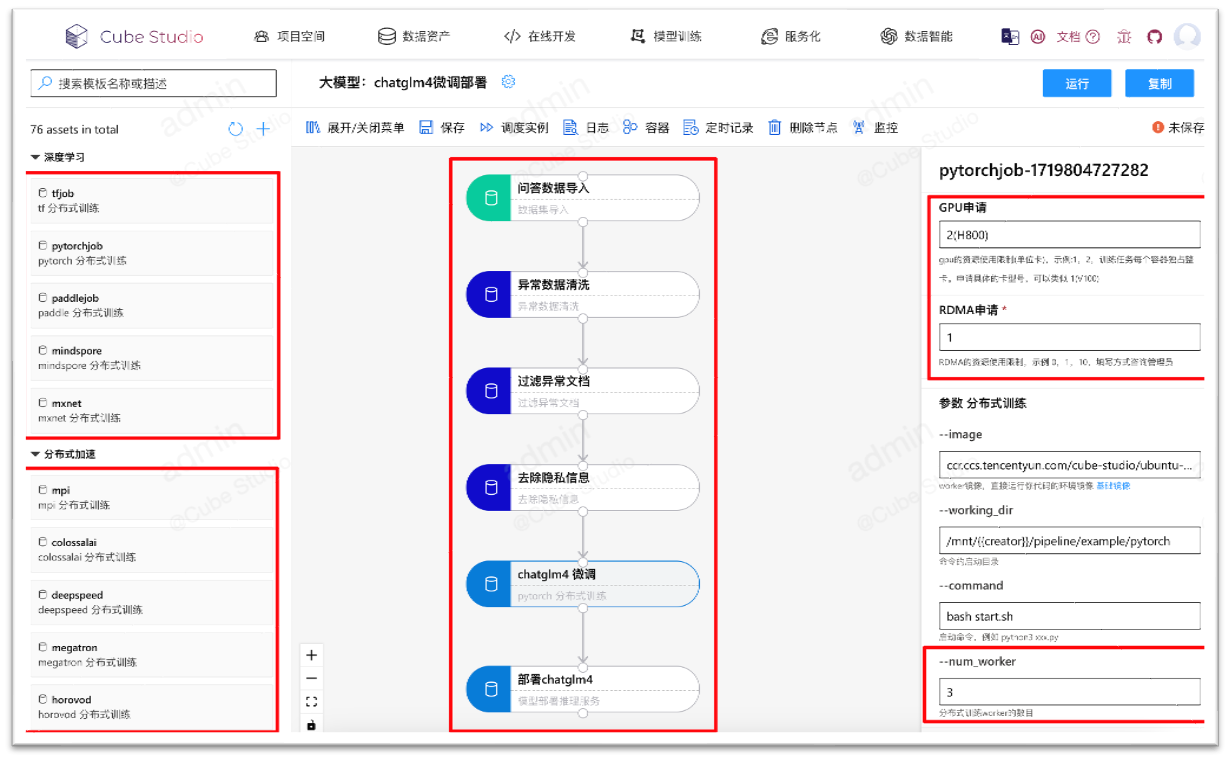
- 支持 TFJob / PyTorch / PaddleJob / MindSpore / MXNet 等分布式训练框架。
- 支持 DeepSpeed / Megatron / ColossalAI / Horovod / MPI 等分布式加速框架。
大模型微调(模型与硬件)
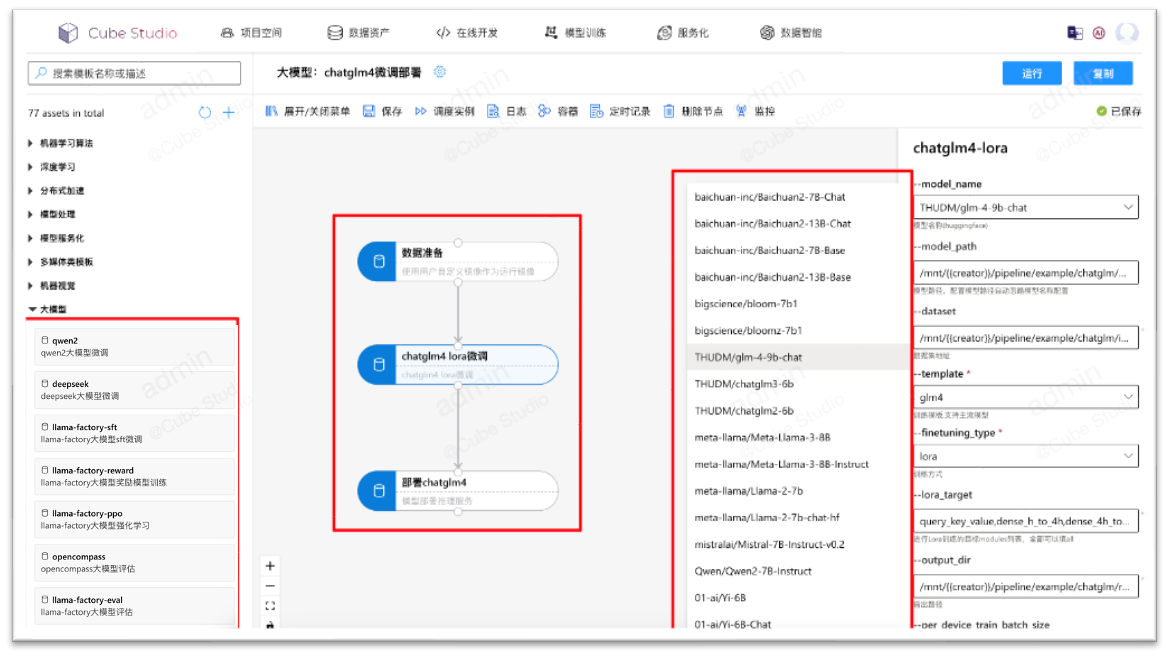
- 支持 DeepSeek / ChatGLM / Qwen 等 full/LoRA 微调,支持 LLaMA-Factory 100+ LLMs。
- 支持大模型量化,大模型 SFT / 奖励模型 / 强化学习训练、大模型评估(OpenCompass)、大模型剪枝。
- 支持 RDMA,支持 IB/RoCE 底层,支持国产 GPU 卡,不同 GPU 厂商 / 卡型选择。
推理部署
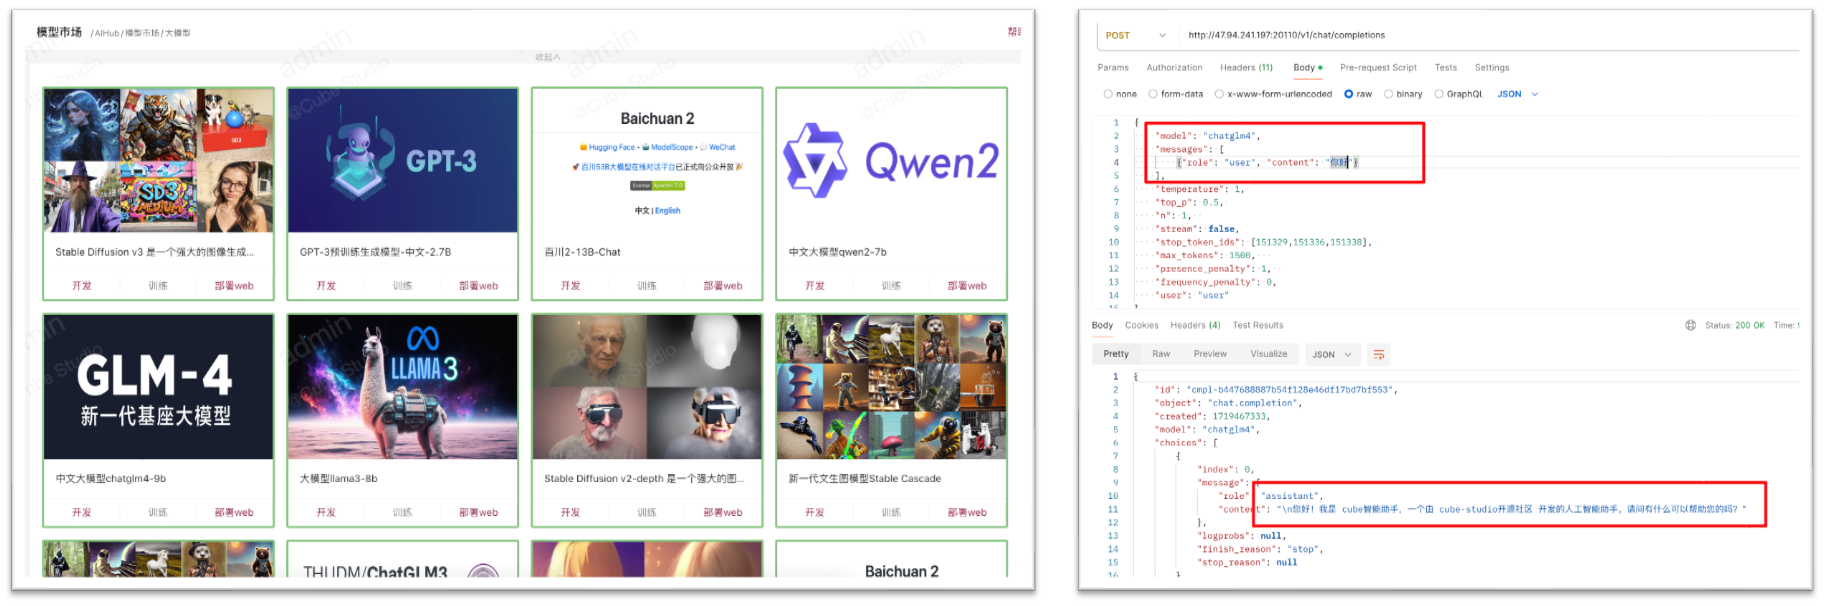
- 以 AIHub 形式部署开源文生图大模型,支持 vLLM / Ollama / MindIE / Xinference 等多种部署形式。
- 支持 vLLM / MindIE 单机多卡 / 多机多卡推理加速,形成 OpenAI 流式接口。
- 支持大模型网关:秘钥匹配、限速、黑白名单、Token 限额、统计监控、有效期设定等,并提供 QPS / 失败率 / TPS / 输入输出 token / TTFT 等流量监控。
私有知识库
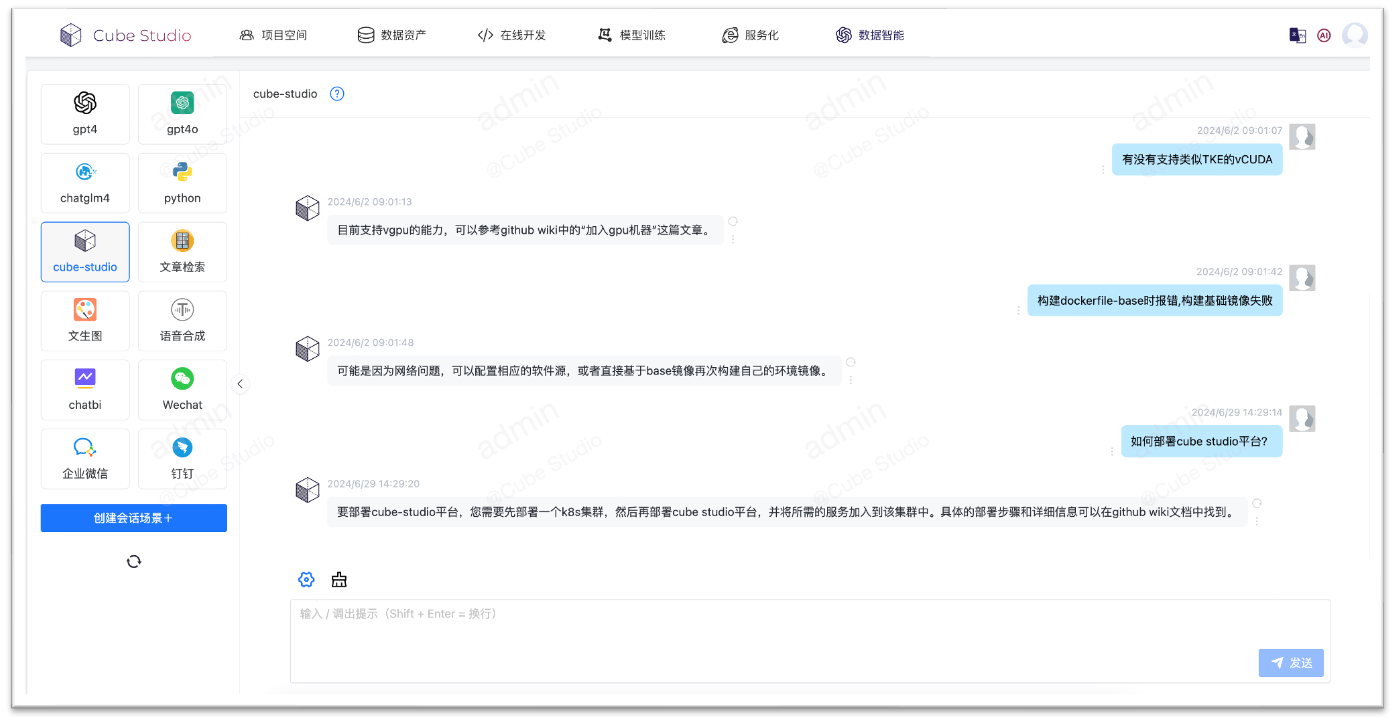
- 支持对接外部 LLM 服务厂商接口,支持对接内部预训练模型或微调模型 LLM 服务接口。
- 可为某个聊天场景配置私有知识库文件,支持主题分割、语义 embedding、意图识别、概要提取、多路召回、排序等多种功能融合。
AIGC 与智能对话
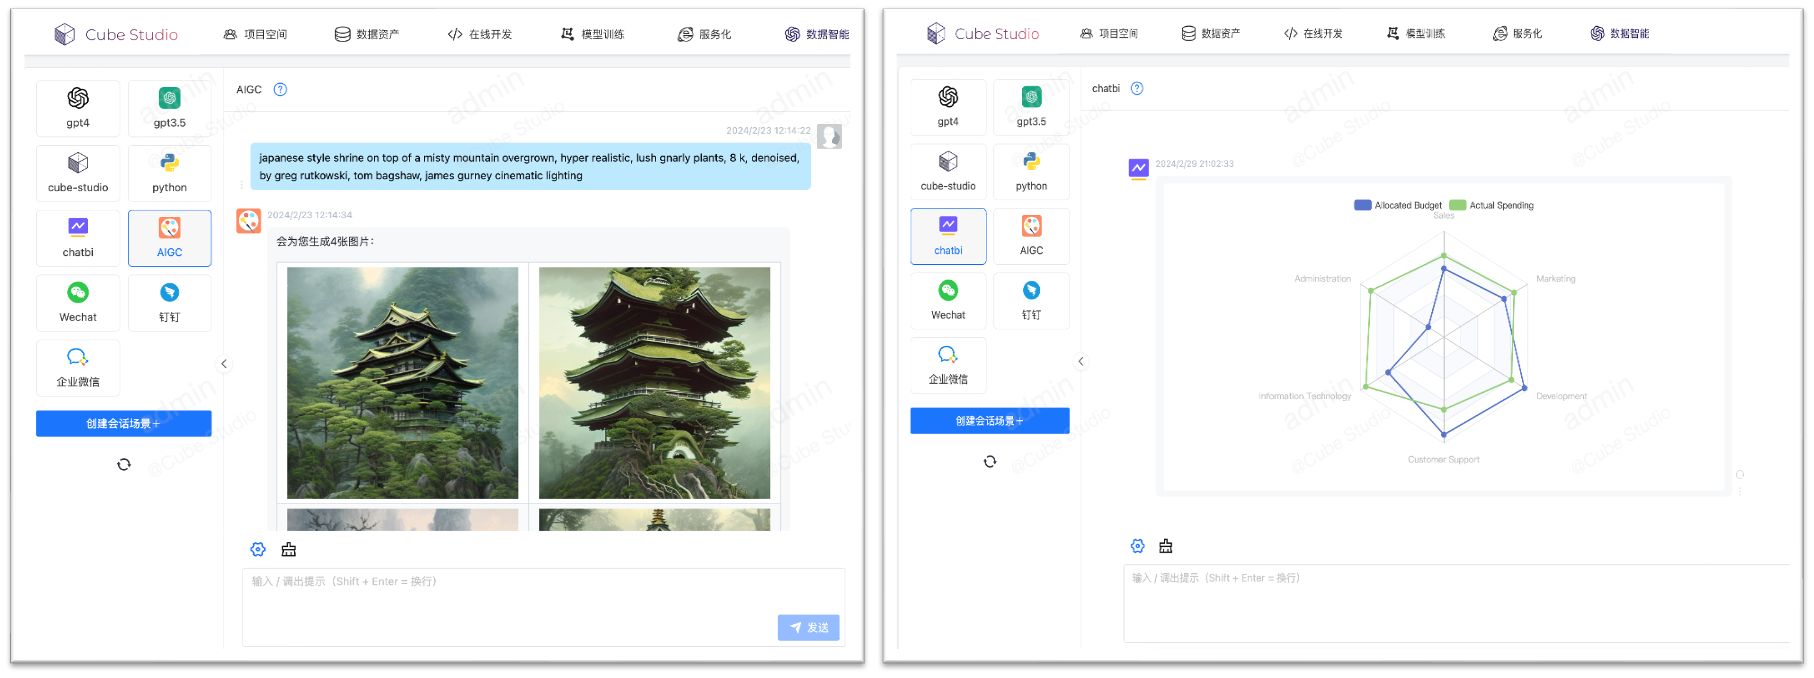
- AIGC:将智能会话与 AIHub 相结合,例如文生图模型与聊天会话结合,输入提示词即可一键生成图片。
- 机器人:智能会话可与微信公众号 / 企业微信 / 钉钉机器人打通,并可在机器人中使用知识库。
- 智能对话:支持多场景对话、提示词模板、多模态(图片)问答、切换模型、对话超参数、多窗口对话、检索知识库记录展示与安全问答检测。
国产化支持
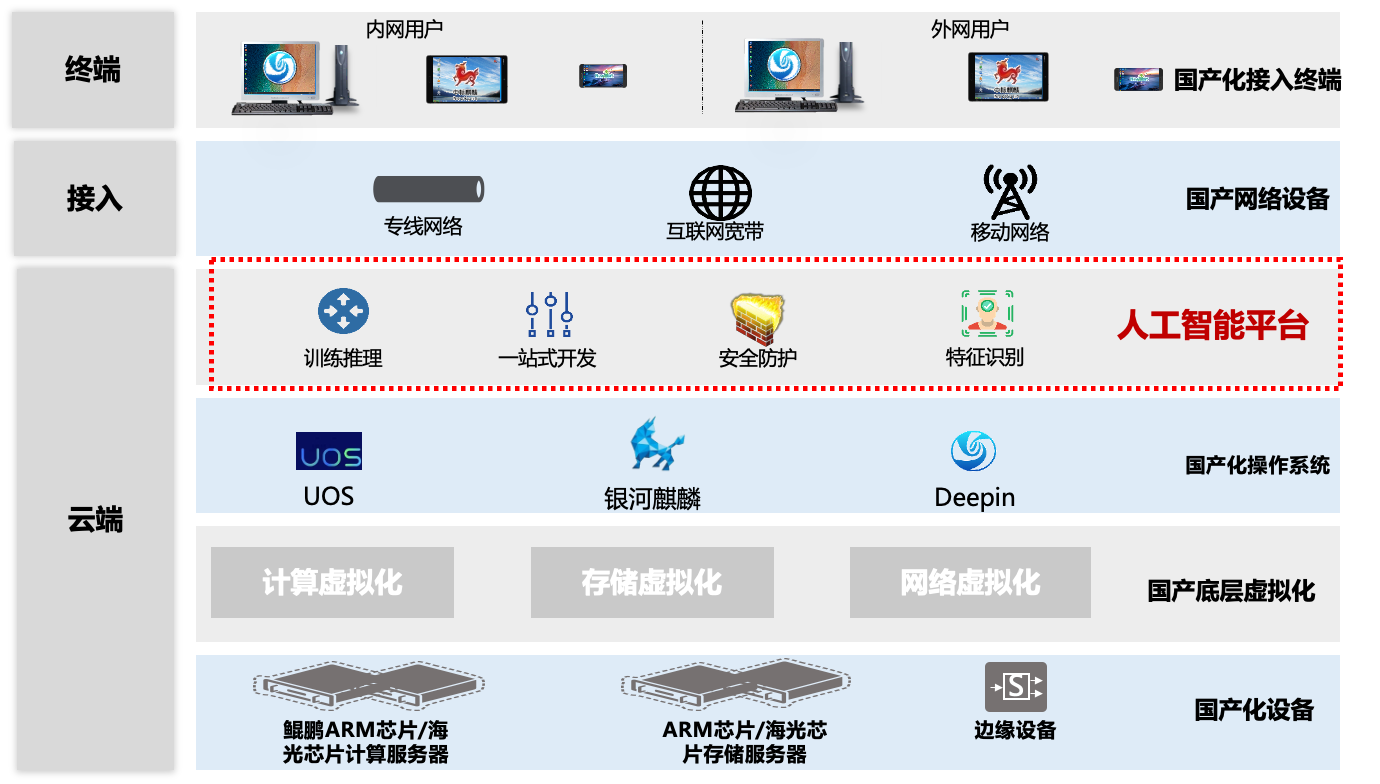
平台原生支持国产化平台部署,以满足客户对国产化产品的安全可信要求。
国产 AI 算力,一站调度
平台原生支持主流国产 AI 芯片,屏蔽底层异构差异,让训练、微调、推理无缝跑在国产算力上:
- 华为昇腾 NPU(310 / 310P / 910B,支持虚拟化切分)
- 海光 DCU(支持整卡、共享与虚拟化多种占用模式)
- 寒武纪 MLU、沐曦、摩尔线程、百度昆仑芯、壁仞
配套提供国产算力的整卡 / 共享 / 虚拟卡灵活调度、NPU 专属监控看板、RDMA 高速互联,以及昇腾 MindIE 推理、NPU/DCU/沐曦适配的 LLaMA-Factory 大模型微调等开箱即用能力。
国产数据库,无缝对接
- 平台元数据库:支持达梦 DM8、人大金仓 KingBase、OceanBase 等国产数据库,替代 MySQL 作为平台底座。
- SQLLab 数据查询:内置对达梦、GaussDB 高斯等国产数据库的交互式查询与在线分析建模,与 MySQL、PostgreSQL、ClickHouse、Hive 等统一体验。
国产 CPU 与 ARM 架构
全栈适配鲲鹏等 ARM64 国产 CPU:平台底层组件、前后端、任务模板、Notebook 开发环境、超参搜索均提供 ARM 版本镜像,AI 应用商店约 70% 应用支持 ARM,真正做到国产芯片上"拿来即用"。
国产操作系统与私有化部署
采用容器化 + Kubernetes 交付,应用与操作系统解耦,可运行于国产 ARM 服务器与信创软硬件环境,支持全离线私有化部署,满足党政、金融、能源等行业的自主可控与安全合规要求。