

Documentation | Torch4keras | Examples | build_MiniLLM_from_scratch | bert4vector
目录
1. 下载安装
安装稳定版
pip install bert4torch
安装最新版
pip install git+https://github.com/Tongjilibo/bert4torch
- 注意事项:pip包的发布慢于git上的开发版本,git clone注意引用路径,注意权重是否需要转换
- 测试用例:
git clone https://github.com/Tongjilibo/bert4torch,修改example中的预训练模型文件路径和数据路径即可启动脚本 - 自行训练:针对自己的数据,修改相应的数据处理代码块
- 开发环境:原使用
torch==1.10版本进行开发,现已切换到torch2.0开发,如其他版本遇到不适配,欢迎反馈
2. 功能
-
LLM模型: 加载chatglm、llama、 baichuan、ziya、bloom等开源大模型权重进行推理和微调,命令行一行部署大模型
-
核心功能:加载bert、roberta、albert、xlnet、nezha、bart、RoFormer、RoFormer_V2、ELECTRA、GPT、GPT2、T5、GAU-alpha、ERNIE等预训练权重继续进行finetune、并支持在bert基础上灵活定义自己模型
-
丰富示例:包含llm、pretrain、sentence_classfication、sentence_embedding、sequence_labeling、relation_extraction、seq2seq、serving等多种解决方案
-
实验验证:已在公开数据集实验验证,使用如下examples数据集和实验指标
-
易用trick:集成了常见的trick,即插即用
-
其他特性:加载transformers库模型一起使用;调用方式简洁高效;有训练进度条动态展示;配合torchinfo打印参数量;默认Logger和Tensorboard简便记录训练过程;自定义fit过程,满足高阶需求
-
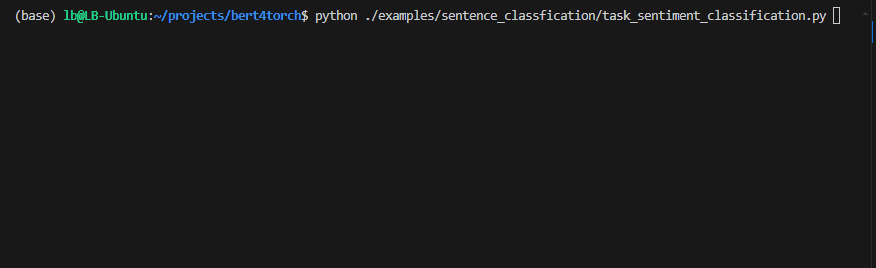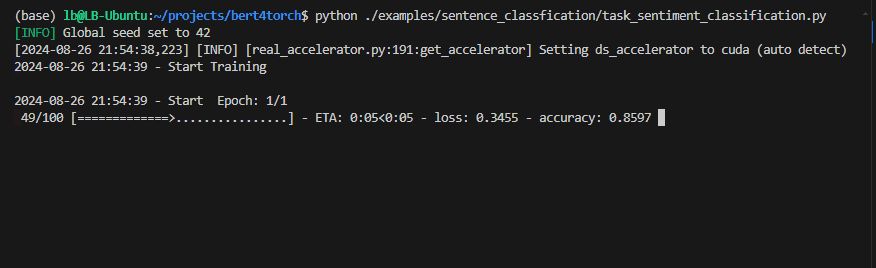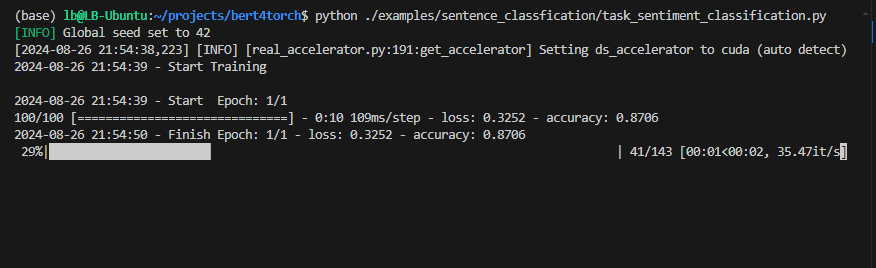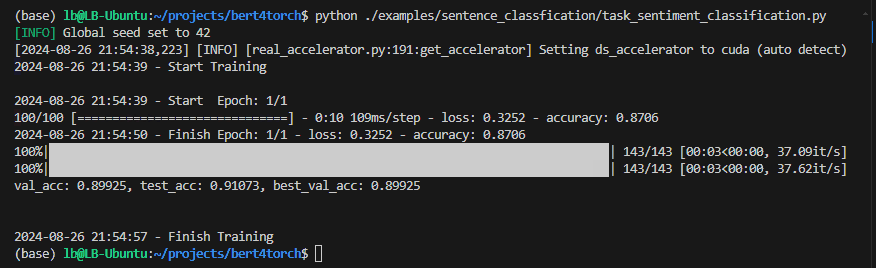
训练过程:
| 功能 | bert4torch | transformers | 备注 |
|---|---|---|---|
| 训练进度条 | ✅ | ✅ | 进度条打印loss和定义的metrics |
| 分布式训练dp/ddp | ✅ | ✅ | torch自带dp/ddp |
| 各类callbacks | ✅ | ✅ | 日志/tensorboard/earlystop/wandb等 |
| 大模型推理,stream/batch输出 | ✅ | ✅ | 各个模型是通用的,无需单独维护脚本 |
| 大模型微调 | ✅ | ✅ | lora依赖peft库,pv2自带 |
| 丰富tricks | ✅ | ❌ | 对抗训练等tricks即插即用 |
| 代码简洁易懂,自定义空间大 | ✅ | ❌ | 代码复用度高, keras代码训练风格 |
| 仓库的维护能力/影响力/使用量/兼容性 | ❌ | ✅ | 目前仓库个人维护 |
| 一键部署大模型 |
3. 快速上手
3.1 上手教程
3.2 命令行快速部署大模型服务
- 本地 / 联网加载
# 联网下载全部文件 bert4torch serve Qwen/Qwen2-0.5B-Instruct # 加载本地大模型,且bert4torch_config.json已经下载并放于同名目录下 bert4torch serve /data/pretrain_ckpt/Qwen/Qwen2-0.5B-Instruct - 命令行 / gradio网页 / openai_api
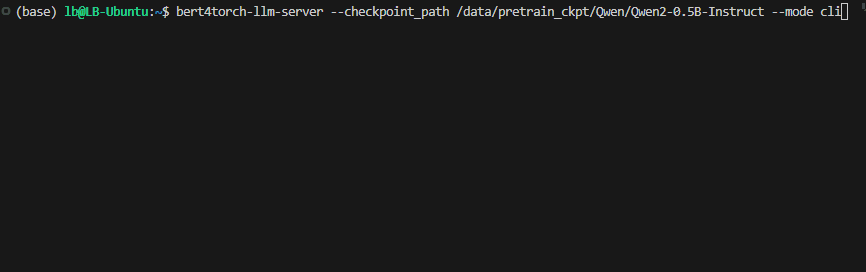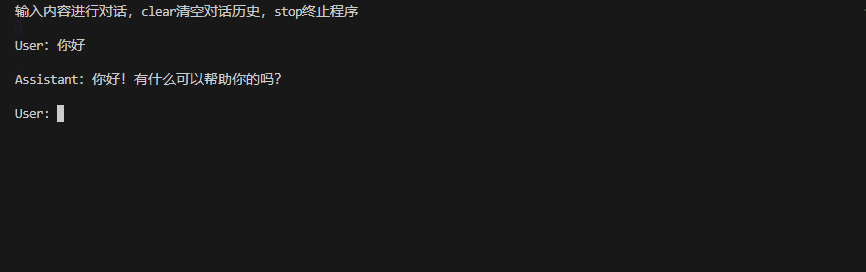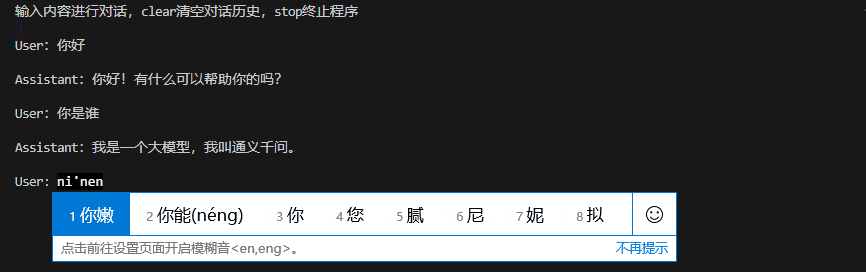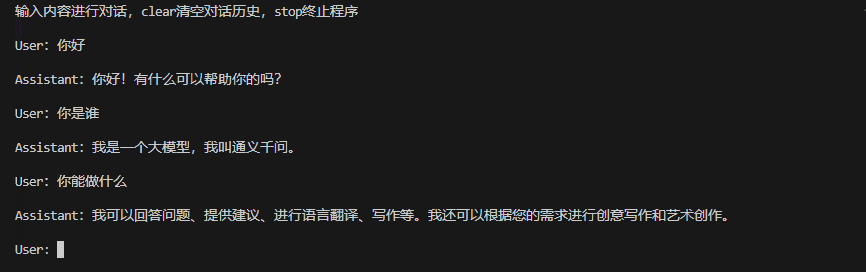
# 命令行 bert4torch serve /data/pretrain_ckpt/Qwen/Qwen2-0.5B-Instruct --mode cli # gradio网页 bert4torch serve /data/pretrain_ckpt/Qwen/Qwen2-0.5B-Instruct --mode gradio # openai_api bert4torch serve /data/pretrain_ckpt/Qwen/Qwen2-0.5B-Instruct --mode openai - 命令行聊天示例
4. 版本和更新历史
4.1 版本历史
| 更新日期 | bert4torch | torch4keras | 版本说明 |
|---|---|---|---|
| 20260513 | 0.6.2 | 0.3.4 | 增加qwen3_vl、deepseek ocr、glm_ocr; 去除对transformers依赖,增加AutoTokenizer, AutoProcessor |
| 20260114 | 0.6.1 | 0.3.3 | 增加paddleocr-vl,优化代码结构,去除硬代码模型配置项 |
| 20250925 | 0.6.0 | 0.3.2 | 增加 Qwen3-moe, 支持 gptq、awq等主流量化方式,其他代码优化 |
| 20250721 | 0.5.9.post2 | 0.3.1 | 增加 Ernie4_5, 修复hub下载bug, 拆分出 openai_client |
4.2 更新历史
5. 预训练权重
5.1 权重加载
from bert4torch.models import build_transformer_model

# 1. 仅指定pretrained_model_name_or_path:
# 1.1 model_name: hf上预训练权重名称, 会自动下载hf权重以及bert4torch_config.json文件
model = build_transformer_model('google-bert/bert-base-chinese')

# 1.2 本地文件夹路径: 自动寻找路径下的*.bin/*.safetensors权重文件 + bert4torch_config.json文件,需提前下载到本地
model = build_transformer_model('/data/pretrained_models/google-bert/bert-base-chinese')

# 2. 同时指定config_path和checkpoint_path,和1效果一样
config_path = './model/bert4torch_config.json'
checkpoint_path = './model/pytorch_model.bin'
model = build_transformer_model(config_path=config_path, checkpoint_path=checkpoint_path)

# 3. 仅指定config_path: 从头初始化模型结构, 不加载预训练模型
model = build_transformer_model(config_path='./model/bert4torch_config.json')
5.2 权重链接
| 模型分类 | 模型名称 | 权重来源 | checkpoint_path | config_path |
|---|---|---|---|---|
| bert | bert-base-chinese | google-bert | google-bert/bert-base-chinese 🤗 |
🤗 |
| chinese_L-12_H-768_A-12 | 谷歌 | tf权重 | ||
Tongjilibo/bert-chinese_L-12_H-768_A-12 🤗 |
||||
| chinese-bert-wwm-ext | HFL | hfl/chinese-bert-wwm-ext 🤗 |
🤗 | |
| bert-base-multilingual-cased | google-bert | google-bert/bert-base-multilingual-cased 🤗 |
🤗 | |
| bert-base-cased | google-bert | google-bert/bert-base-cased 🤗 |
🤗 | |
| bert-base-uncased | google-bert | google-bert/bert-base-uncased 🤗 |
🤗 | |
| MacBERT | HFL | hfl/chinese-macbert-base 🤗 |
||
hfl/chinese-macbert-large 🤗 |
🤗 | |||
| 🤗 | ||||
| WoBERT | 追一科技 | junnyu/wobert_chinese_base 🤗 |
||
junnyu/wobert_chinese_plus_base 🤗 |
🤗 | |||
| 🤗 | ||||
| roberta | chinese-roberta-wwm-ext | HFL | hfl/chinese-roberta-wwm-ext 🤗 |
|
hfl/chinese-roberta-wwm-ext-large 🤗 |
||||
| (large的mlm权重是随机初始化) | 🤗 | |||
| 🤗 | ||||
| roberta-small/tiny | 追一科技 | Tongjilibo/chinese_roberta_L-4_H-312_A-12 🤗 |
||
Tongjilibo/chinese_roberta_L-6_H-384_A-12 🤗 |
||||
| roberta-base | FacebookAI | FacebookAI/roberta-base 🤗 |
🤗 | |
| guwenbert | ethanyt | ethanyt/guwenbert-base 🤗 |
🤗 | |
| albert | albert_zh | |||
| albert_pytorch | brightmart | voidful/albert_chinese_tiny 🤗 |
||
voidful/albert_chinese_small 🤗 |
||||
voidful/albert_chinese_base 🤗 |
||||
voidful/albert_chinese_large 🤗 |
||||
voidful/albert_chinese_xlarge 🤗 |
||||
voidful/albert_chinese_xxlarge 🤗 |
🤗 | |||
| 🤗 | ||||
| 🤗 | ||||
| 🤗 | ||||
| 🤗 | ||||
| 🤗 | ||||
| nezha | NEZHA | |||
| NeZha_Chinese_PyTorch | huawei_noah | sijunhe/nezha-cn-base 🤗 |
||
sijunhe/nezha-cn-large 🤗 |
||||
sijunhe/nezha-base-wwm 🤗 |
||||
sijunhe/nezha-large-wwm 🤗 |
🤗 | |||
| 🤗 | ||||
| 🤗 | ||||
| 🤗 | ||||
| nezha_gpt_dialog | bojone | Tongjilibo/nezha_gpt_dialog 🤗 |
||
| xlnet | Chinese-XLNet | HFL | hfl/chinese-xlnet-base 🤗 |
🤗 |
| tranformer_xl | huggingface | transfo-xl/transfo-xl-wt103 🤗 |
🤗 | |
| deberta | Erlangshen-DeBERTa-v2 | IDEA | IDEA-CCNL/Erlangshen-DeBERTa-v2-97M-Chinese 🤗 |
|
IDEA-CCNL/Erlangshen-DeBERTa-v2-320M-Chinese 🤗 |
||||
IDEA-CCNL/Erlangshen-DeBERTa-v2-710M-Chinese 🤗 |
🤗 | |||
| 🤗 | ||||
| 🤗 | ||||
| electra | Chinese-ELECTRA | HFL | hfl/chinese-electra-base-discriminator 🤗 |
🤗 |
| ernie | ernie | 百度文心 | nghuyong/ernie-1.0-base-zh 🤗 |
|
nghuyong/ernie-3.0-base-zh 🤗 |
🤗 | |||
| 🤗 | ||||
| roformer | roformer | 追一科技 | junnyu/roformer_chinese_base 🤗 |
🤗 |
| roformer_v2 | 追一科技 | junnyu/roformer_v2_chinese_char_base 🤗 |
🤗 | |
| simbert | simbert | 追一科技 | Tongjilibo/simbert-chinese-base 🤗 |
|
Tongjilibo/simbert-chinese-small 🤗 |
||||
Tongjilibo/simbert-chinese-tiny 🤗 |
||||
| simbert_v2/roformer-sim | 追一科技 | junnyu/roformer_chinese_sim_char_base 🤗 |
||
junnyu/roformer_chinese_sim_char_ft_base 🤗 |
||||
junnyu/roformer_chinese_sim_char_small 🤗 |
||||
junnyu/roformer_chinese_sim_char_ft_small 🤗 |
🤗 | |||
| 🤗 | ||||
| 🤗 | ||||
| 🤗 | ||||
| gau | GAU-alpha | 追一科技 | Tongjilibo/chinese_GAU-alpha-char_L-24_H-768 🤗 |
|
| ModernBERT | ModernBERT | answerdotai | answerdotai/ModernBERT-base 🤗 |
|
answerdotai/ModernBERT-large 🤗 |
🤗 | |||
| 🤗 | ||||
| uie | uie | |||
| uie_pytorch | 百度 | Tongjilibo/uie-base 🤗 |
||
| gpt | CDial-GPT | thu-coai | thu-coai/CDial-GPT_LCCC-base 🤗 |
|
thu-coai/CDial-GPT_LCCC-large 🤗 |
🤗 | |||
| 🤗 | ||||
| cmp_lm(26亿) | 清华 | TsinghuaAI/CPM-Generate 🤗 |
🤗 | |
| nezha_gen | huawei_noah | Tongjilibo/chinese_nezha_gpt_L-12_H-768_A-12 🤗 |
||
| gpt2-chinese-cluecorpussmall | UER | uer/gpt2-chinese-cluecorpussmall 🤗 |
🤗 | |
| gpt2-ml | imcaspar | Tongjilibo/gpt2-ml_15g_corpus 🤗 |
||
Tongjilibo/gpt2-ml_30g_corpus 🤗 |
||||
| torch,BaiduYun(84dh) | ||||
| bart | bart_base_chinese | 复旦fnlp | fnlp/bart-base-chinese 🤗 |
|
| fnlp/bart-base-chinese-v1.0 | 🤗 | |||
| 🤗 | ||||
| t5 | t5 | UER | uer/t5-small-chinese-cluecorpussmall 🤗 |
|
uer/t5-base-chinese-cluecorpussmall 🤗 |
🤗 | |||
| 🤗 | ||||
| mt5 | 谷歌 | google/mt5-base 🤗 |
🤗 | |
| t5_pegasus | 追一科技 | Tongjilibo/chinese_t5_pegasus_small 🤗 |
||
Tongjilibo/chinese_t5_pegasus_base 🤗 |
||||
| chatyuan | clue-ai | ClueAI/ChatYuan-large-v1 🤗 |
||
ClueAI/ChatYuan-large-v2 🤗 |
🤗 | |||
| 🤗 | ||||
| PromptCLUE | clue-ai | ClueAI/PromptCLUE-base 🤗 |
🤗 | |
| chatglm | ChatGLM-6B | zai-org | zai-org/chatglm-6b 🤗 |
|
zai-org/chatglm-6b-int8 🤗 |
||||
zai-org/chatglm-6b-int4 🤗 |
||||
zai-org/chatglm-6b-v0.1.0🤗 |
🤗 | |||
| 🤗 | ||||
| 🤗 | ||||
| 🤗 | ||||
| ChatGLM2-6B | zai-org | zai-org/chatglm2-6b 🤗 |
||
zai-org/chatglm2-6b-int4 🤗 |
||||
zai-org/chatglm2-6b-32k 🤗 |
🤗 | |||
| 🤗 | ||||
| 🤗 | ||||
| ChatGLM3 | zai-org | zai-org/chatglm3-6b 🤗 |
||
zai-org/chatglm3-6b-32k 🤗 |
🤗 | |||
| 🤗 | ||||
| GLM-4 | zai-org | zai-org/glm-4-9b 🤗 |
||
zai-org/glm-4-9b-chat 🤗 |
||||
zai-org/glm-4-9b-chat-1m 🤗 |
||||
zai-org/glm-4v-9b 🤗 |
||||
zai-org/GLM-4-9B-0414 🤗 |
||||
zai-org/GLM-Z1-9B-0414 🤗 |
🤗 | |||
| 🤗 | ||||
| 🤗 | ||||
| 🤗 |
|
|llama|llama|meta|meta-llama/llama-7b
meta-llama/llama-13b|🤗
🤗|
||llama-2|meta|meta-llama/Llama-2-7b-hf🤗
meta-llama/Llama-2-7b-chat-hf🤗
meta-llama/Llama-2-13b-hf🤗
meta-llama/Llama-2-13b-chat-hf🤗|🤗
🤗
🤗
🤗|
||llama-3|meta|meta-llama/Meta-Llama-3-8B 🤗
meta-llama/Meta-Llama-3-8B-Instruct 🤗|🤗
🤗|
||llama-3.1|meta|meta-llama/Meta-Llama-3.1-8B 🤗
meta-llama/Meta-Llama-3.1-8B-Instruct 🤗|🤗
🤗|
||llama-3.2|meta|meta-llama/Llama-3.2-1B 🤗
meta-llama/Llama-3.2-1B-Instruct 🤗
meta-llama/Llama-3.2-3B 🤗
meta-llama/Llama-3.2-3B-Instruct 🤗|🤗
🤗
🤗
🤗|
||llama-3.2-vision|meta|meta-llama/Llama-3.2-11B-Vision 🤗
meta-llama/Llama-3.2-11B-Vision-Instruct 🤗|🤗
🤗|
|llama-series|Chinese-LLaMA-Alpaca|HFL|hfl/chinese-alpaca-plus-lora-7b 🤗
hfl/chinese-llama-plus-lora-7b 🤗
(使用前需要合并lora权重)|🤗
🤗
|
||Chinese-LLaMA-Alpaca-2|HFL||待添加|
||Chinese-LLaMA-Alpaca-3|HFL||待添加|
||Belle_llama|LianjiaTech|BelleGroup/BELLE-LLaMA-7B-2M-enc🤗|合成说明、🤗|
||Ziya|IDEA-CCNL|IDEA-CCNL/Ziya-LLaMA-13B-v1🤗
IDEA-CCNL/Ziya-LLaMA-13B-v1.1🤗
IDEA-CCNL/Ziya-LLaMA-13B-Pretrain-v1🤗|🤗
🤗
|
||vicuna|lmsys|lmsys/vicuna-7b-v1.5 🤗|🤗|
|Baichuan|Baichuan|baichuan-inc|baichuan-inc/Baichuan-7B 🤗
baichuan-inc/Baichuan-13B-Base 🤗
baichuan-inc/Baichuan-13B-Chat 🤗|🤗
🤗
🤗|
||Baichuan2|baichuan-inc|baichuan-inc/Baichuan2-7B-Base 🤗
baichuan-inc/Baichuan2-7B-Chat 🤗
baichuan-inc/Baichuan2-13B-Base 🤗
baichuan-inc/Baichuan2-13B-Chat 🤗|🤗
🤗
🤗
🤗|
|Yi|Yi|01-ai|01-ai/Yi-6B 🤗
01-ai/Yi-6B-200K 🤗
01-ai/Yi-9B 🤗
01-ai/Yi-9B-200K 🤗|🤗
🤗
🤗
🤗|
||Yi-1.5|01-ai|01-ai/Yi-1.5-6B 🤗
01-ai/Yi-1.5-6B-Chat 🤗
01-ai/Yi-1.5-9B 🤗
01-ai/Yi-1.5-9B-32K 🤗
01-ai/Yi-1.5-9B-Chat 🤗
01-ai/Yi-1.5-9B-Chat-16K 🤗|🤗
🤗
🤗
🤗
🤗
🤗|
|bloom|bloom|bigscience|bigscience/bloom-560m 🤗
bigscience/bloomz-560m 🤗|🤗
🤗|
|Qwen|Qwen|阿里云|Qwen/Qwen-1_8B 🤗
Qwen/Qwen-1_8B-Chat 🤗
Qwen/Qwen-7B 🤗
Qwen/Qwen-7B-Chat 🤗
Qwen/Qwen-14B 🤗
Qwen/Qwen-14B-Chat 🤗|🤗
🤗
🤗
🤗
🤗
🤗|
||Qwen1.5|阿里云|Qwen/Qwen1.5-0.5B 🤗
Qwen/Qwen1.5-0.5B-Chat 🤗
Qwen/Qwen1.5-1.8B 🤗
Qwen/Qwen1.5-1.8B-Chat 🤗
Qwen/Qwen1.5-7B 🤗
Qwen/Qwen1.5-7B-Chat 🤗
Qwen/Qwen1.5-14B 🤗
Qwen/Qwen1.5-14B-Chat 🤗|🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗|
||Qwen2|阿里云|Qwen/Qwen2-0.5B 🤗
Qwen/Qwen2-0.5B-Instruct 🤗
Qwen/Qwen2-1.5B 🤗
Qwen/Qwen2-1.5B-Instruct 🤗
Qwen/Qwen2-7B 🤗
Qwen/Qwen2-7B-Instruct 🤗|🤗
🤗
🤗
🤗
🤗
🤗|
||Qwen2-VL|阿里云|Qwen/Qwen2-VL-2B-Instruct 🤗
Qwen/Qwen2-VL-7B-Instruct 🤗|🤗
🤗|
||Qwen2.5|阿里云|Qwen/Qwen2.5-0.5B 🤗
Qwen/Qwen2.5-0.5B-Instruct 🤗
Qwen/Qwen2.5-1.5B 🤗
Qwen/Qwen2.5-1.5B-Instruct 🤗
Qwen/Qwen2.5-3B 🤗
Qwen/Qwen2.5-3B-Instruct 🤗
Qwen/Qwen2.5-7B 🤗
Qwen/Qwen2.5-7B-Instruct 🤗
Qwen/Qwen2.5-14B 🤗
Qwen/Qwen2.5-14B-Instruct 🤗|🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗|
||Qwen2.5-VL|阿里云|Qwen/Qwen2.5-VL-3B-Instruct 🤗
Qwen/Qwen2.5-VL-7B-Instruct 🤗
Qwen/Qwen2.5-VL-32B-Instruct 🤗|🤗
🤗
🤗|
||Qwen3|阿里云|Qwen/Qwen3-0.6B-Base 🤗
Qwen/Qwen3-0.6B 🤗
Qwen/Qwen3-0.6B-GPTQ-Int8 🤗
Qwen/Qwen3-1.7B-Base 🤗
Qwen/Qwen3-1.7B 🤗
Qwen/Qwen3-4B-Base 🤗
Qwen/Qwen3-4B 🤗
Qwen/Qwen3-4B-AWQ 🤗
Qwen/Qwen3-8B-Base 🤗
Qwen/Qwen3-8B 🤗
Qwen/Qwen3-14B-Base 🤗
Qwen/Qwen3-14B 🤗
Qwen/Qwen3-32B 🤗
Qwen/Qwen3-4B-Instruct-2507 🤗
Qwen/Qwen3-4B-Thinking-2507 🤗
Qwen/Qwen3-30B-A3B-Instruct-2507 🤗
Qwen/Qwen3-30B-A3B-Thinking-2507 🤗|🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗|
||Qwen3-VL|阿里云|Qwen/Qwen3-VL-2B-Instruct 🤗
Qwen/Qwen3-VL-2B-Thinking 🤗
Qwen/Qwen3-VL-4B-Instruct 🤗
Qwen/Qwen3-VL-4B-Thinking 🤗
Qwen/Qwen3-VL-8B-Instruct 🤗
Qwen/Qwen3-VL-8B-Thinking 🤗
Qwen/Qwen3-VL-30B-A3B-Instruct 🤗
Qwen/Qwen3-VL-30B-A3B-Thinking 🤗
Qwen/Qwen3-VL-32B-Instruct 🤗
Qwen/Qwen3-VL-32B-Thinking 🤗|🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗
🤗|
||Qwen3-Embedding|阿里云|Qwen/Qwen3-Embedding-0.6B 🤗
Qwen/Qwen3-Embedding-4B 🤗
Qwen/Qwen3-Embedding-8B 🤗|🤗
🤗
🤗|
||Qwen3-Reranker|阿里云|Qwen/Qwen3-Reranker-0.6B 🤗
Qwen/Qwen3-Reranker-4B 🤗
Qwen/Qwen3-Reranker-8B 🤗|🤗
🤗
🤗|
|Intern|InternLM|上海人工智能实验室|internlm/internlm-7b 🤗
internlm/internlm-chat-7b 🤗|🤗
🤗|
||InternLM2|上海人工智能实验室|internlm/internlm2-1_8b 🤗
internlm/internlm2-chat-1_8b 🤗
internlm/internlm2-7b 🤗
internlm/internlm2-chat-7b 🤗
internlm/internlm2-20b 🤗
internlm/internlm2-chat-20b 🤗|🤗
🤗
🤗
🤗
|
||InternLM2.5|上海人工智能实验室|internlm/internlm2_5-7b 🤗
internlm/internlm2_5-7b-chat 🤗
internlm/internlm2_5-7b-chat-1m 🤗|🤗
🤗
🤗|
||InternLM3|上海人工智能实验室|internlm/internlm3-8b-instruct 🤗|🤗|
||InternVL1.0-1.5|上海人工智能实验室|OpenGVLab/Mini-InternVL-Chat-4B-V1-5 🤗
OpenGVLab/Mini-InternVL-Chat-2B-V1-5 🤗|待添加|
||InternVL2.0|上海人工智能实验室|OpenGVLab/InternVL2-1B 🤗
OpenGVLab/InternVL2-2B 🤗
OpenGVLab/InternVL2-4B 🤗
OpenGVLab/InternVL2-8B 🤗|待添加|
||InternVL2.5|上海人工智能实验室|OpenGVLab/InternVL2_5-1B 🤗
OpenGVLab/InternVL2_5-2B 🤗
OpenGVLab/InternVL2_5-4B 🤗
OpenGVLab/InternVL2_5-8B 🤗|🤗
待添加
待添加
待添加|
|Falcon|Falcon|tiiuae|tiiuae/falcon-rw-1b 🤗
tiiuae/falcon-7b 🤗
tiiuae/falcon-7b-instruct 🤗|🤗
🤗
🤗|
|DeepSeek|DeepSeek-MoE|深度求索|deepseek-ai/deepseek-moe-16b-base 🤗
deepseek-ai/deepseek-moe-16b-chat 🤗|🤗
🤗|
||DeepSeek-LLM|深度求索|deepseek-ai/deepseek-llm-7b-base 🤗
deepseek-ai/deepseek-llm-7b-chat 🤗|🤗
🤗|
||DeepSeek-V2|深度求索|deepseek-ai/DeepSeek-V2-Lite 🤗
deepseek-ai/DeepSeek-V2-Lite-Chat 🤗|🤗
🤗|
||DeepSeek-Coder|深度求索|deepseek-ai/deepseek-coder-1.3b-base 🤗
deepseek-ai/deepseek-coder-1.3b-instruct 🤗
deepseek-ai/deepseek-coder-6.7b-base 🤗
deepseek-ai/deepseek-coder-6.7b-instruct 🤗
deepseek-ai/deepseek-coder-7b-base-v1.5 🤗
deepseek-ai/deepseek-coder-7b-instruct-v1.5 🤗|🤗
🤗
🤗
🤗
🤗
🤗|
||DeepSeek-Coder-V2|深度求索|deepseek-ai/DeepSeek-Coder-V2-Lite-Base 🤗
deepseek-ai/DeepSeek-Coder-V2-Lite-Instruct 🤗|🤗
🤗|
||DeepSeek-Math|深度求索|deepseek-ai/deepseek-math-7b-base 🤗
deepseek-ai/deepseek-math-7b-instruct 🤗
deepseek-ai/deepseek-math-7b-rl 🤗|🤗
🤗
🤗|
||DeepSeek-R1|深度求索|deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B 🤗
deepseek-ai/DeepSeek-R1-Distill-Qwen-7B 🤗
deepseek-ai/DeepSeek-R1-Distill-Llama-8B 🤗
deepseek-ai/DeepSeek-R1-Distill-Qwen-14B 🤗
deepseek-ai/DeepSeek-R1-Distill-Qwen-32B 🤗
deepseek-ai/DeepSeek-R1-0528-Qwen3-8B 🤗|🤗
🤗
🤗
🤗
🤗
🤗|
|Seed-OSS|Seed-OSS|ByteDance|ByteDance-Seed/Seed-OSS-36B-Instruct 🤗
ByteDance-Seed/Seed-OSS-36B-Base 🤗
ByteDance-Seed/Seed-OSS-36B-Base-woSyn 🤗||
|Ernie4_5|Ernie4_5|百度|baidu/ERNIE-4.5-0.3B-Base-PT 🤗
baidu/ERNIE-4.5-0.3B-PT 🤗
baidu/ERNIE-4.5-21B-A3B-Base-PT 🤗
baidu/ERNIE-4.5-21B-A3B-PT 🤗
baidu/ERNIE-4.5-VL-28B-A3B-Base-PT 🤗
baidu/ERNIE-4.5-VL-28B-A3B-PT 🤗|🤗
🤗|
|PaddleOCR|PaddleOCR-VL|百度|PaddlePaddle/PaddleOCR-VL 🤗|🤗|
||PaddleOCR-VL-1.5|百度|PaddlePaddle/PaddleOCR-VL-1.5 🤗|🤗|
|MiniCPM|MiniCPM|OpenBMB|openbmb/MiniCPM-2B-sft-bf16 🤗
openbmb/MiniCPM-2B-dpo-bf16 🤗
openbmb/MiniCPM-2B-128k 🤗
openbmb/MiniCPM-1B-sft-bf16 🤗
openbmb/MiniCPM3-4B 🤗
openbmb/MiniCPM4-0.5B 🤗
openbmb/MiniCPM4-8B 🤗|🤗
🤗
🤗
🤗
待添加
待添加
待添加|
||MiniCPM-o|OpenBMB|openbmb/MiniCPM-Llama3-V-2_5 🤗
openbmb/MiniCPM-V-2_6 🤗
openbmb/MiniCPM-o-2_6 🤗
openbmb/MiniCPM-V-4 🤗|🤗
🤗
待添加
待添加|
|embedding|text2vec-base-chinese|shibing624|shibing624/text2vec-base-chinese 🤗|🤗|
||m3e|moka-ai|moka-ai/m3e-base 🤗|🤗|
||bge|BAAI|BAAI/bge-large-en-v1.5 🤗
BAAI/bge-large-zh-v1.5 🤗
BAAI/bge-base-en-v1.5 🤗
BAAI/bge-base-zh-v1.5 🤗
BAAI/bge-small-en-v1.5 🤗
BAAI/bge-small-zh-v1.5 🤗|🤗
🤗
🤗
🤗
🤗
🤗|
||gte|thenlper|thenlper/gte-large-zh 🤗
thenlper/gte-base-zh 🤗|🤗
🤗|
*注:
-
高亮格式(如bert-base-chinese)的表示可直接build_transformer_model()联网下载 -
国内镜像网站加速下载
HF_ENDPOINT=https://hf-mirror.com python your_script.pyexport HF_ENDPOINT=https://hf-mirror.com后再执行python代码- 在python代码开头如下设置
import os
os.environ['HF_ENDPOINT'] = "https://hf-mirror.com"
6. 鸣谢
- 感谢苏神实现的bert4keras,本实现有不少地方参考了bert4keras的源码,在此衷心感谢大佬的无私奉献;
- 其次感谢项目bert4pytorch,也是在该项目的指引下给了我用pytorch来复现bert4keras的想法和思路。
7. 引用
@misc{bert4torch,
  title={bert4torch},
  author={Bo Li},
  year={2022},
  howpublished={\url{https://github.com/Tongjilibo/bert4torch}},
}
8. 其他
-
Wechat & Star History Chart
-
微信群人数超过200个(有邀请限制),可添加个人微信拉群,备注:bert4torch-姓名-公司名
[](https://github.com/Tongjilibo) [微信号](https://github.com/Tongjilibo) [](https://github.com/Tongjilibo) [微信群](https://github.com/Tongjilibo) [](https://star-history.com/#Tongjilibo/bert4torch&Date) [Star History Chart](https://star-history.com/#Tongjilibo/bert4torch&Date)