ChatPaper2XMind
中文|English
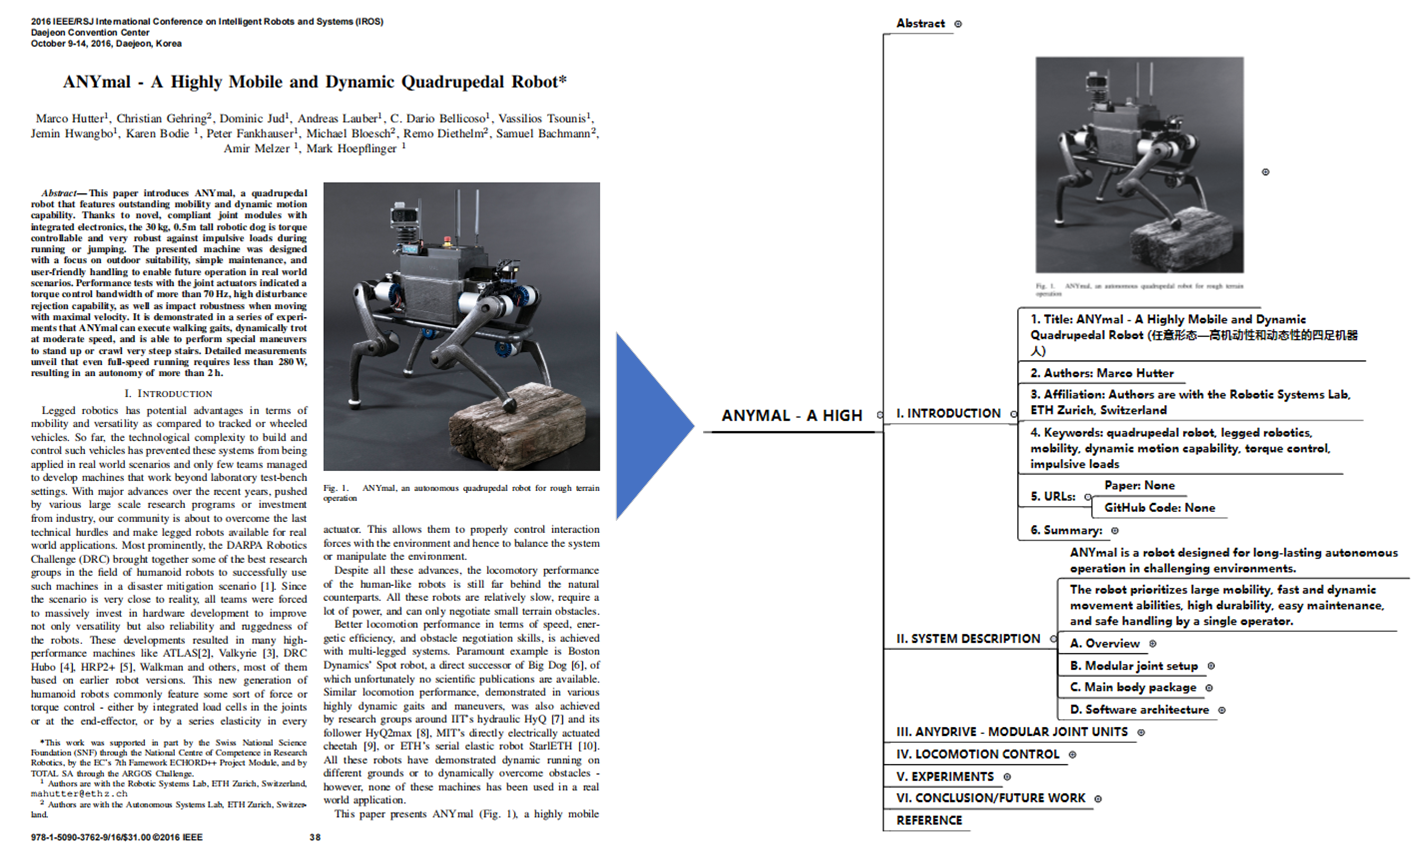
ChatPaper2XMind论文XMind笔记生成工具:使用ChatGPT将PDF转换为带有图片和公式的简洁XMind笔记,提高阅读效率。
注意:受限于ChatGPT生成模型准确性,生成的Xmind笔记更适合作为笔记草稿,在此基础上制作阅读笔记,而不能直接将其当做论文阅读。
目录
功能展示
安装与使用
Release版本

拖拽pdf文件或包含pdf的文件夹至输入框中,即可一键生成。
源码运行
1. 环境设置
git clone --recursive https://github.com/MasterYip/ChatPaper2Xmind.git
cd
pip install -r requirements.txt
pip install -r ./XmindCopilot/requirements.txt
2. Config配置(config.py)
OpenAI API设置
"""OpenAI API"""
APIBASE = ""                    # OpenAI API base, default is "https://api.openai.com/v1" for now (Leave it as empty if you are not sure)
APIKEYS = [""]                  # Your OpenAI API keys
MODEL = "gpt-3.5-turbo"         # GPT model name
LANGUAGE = "English"            # Only partially support Chinese
KEYWORD = "Science&Engineering" # Keyword for GPT model (What field you want the model to focus on)
PROXY = None                    # Your proxy address
# Note: If you are in China, you may need to use a proxy to access OpenAI API
# (If your system's global proxy is set, you can leave it as None)
# PROXY = "http://127.0.0.1:7890"
- APIBASE: OpenAI模型请求服务器URL
- 可以更换为任意支持openai请求格式的模型(ChatGLM/LLaMA等)
- APIKEYS(必须配置): 用于OpenAI模型请求的APIKEY
- 可添加多个APIKEY,支持多线程请求
- 如使用其他模型,APIKEYS的列表长度决定了请求线程数量,内容可为任意值
- 没有APIKEY的同学可以参考ChatGPT_API_NoKey配置伪API服务器,并更改openai.api_base来实现伪API访问,此情况下APIKEY需设置任意值(不能为空)
- MODEL: OpenAI模型选择
- LANGUAGE: 生成语言
- KEYWORD: 论文所属领域
- PROXY: 代理服务器
- 如果你在中国地区,可能需要使用代理访问OpenAI官网
- 保留为None时,将跟随系统全局代理
生成格式设置
"""Generation"""
GEN_IMGS = True
GEN_EQUATIONS = True

# PDFFigure2
USE_PDFFIGURE2 = True       # Use PDFFigure2 to generate images & tables (This requires you to install JVM)
SNAP_WITH_CAPTION = True    # Generate images & tables with caption (Only valid when USE_PDFFIGURE2 is True)

# Max generation item number
TEXT2LIST_MAX_NUM = 4       # Max number of items for each list
TEXT2TREE_MAX_NUM = 4       # Max number of subtopics for each topic
FAKE_GPT_RESPONSE = "Fake"  # Fake GPT response when GPT_ENABLE is False
if True:  # Use true GPT model
    GPT_ENABLE = True
    THREAD_RATE_LIMIT = 100       # Each APIKEY can send 3 requests per minute (limited by OpenAI)
else:    # Use fake GPT model
    GPT_ENABLE = False
    THREAD_RATE_LIMIT = 6000
- GEN_IMGS: 捕获并生成论文图片
- GEN_EQUATIONS: 捕获并生成论文公式
- USE_PDFFIGURE2: 使用PDFFIGURE2来捕获论文图片 (需要Java环境,如没有安装Java环境,请设置为False)
- SNAP_WITH_CAPTION: USE_PDFFIGURE2为True时,截取图片以及图片标题
- TEXT2LIST_MAX_NUM(暂时无效)
- TEXT2TREE_MAX_NUM(暂时无效)
- FAKE_GPT_RESPONSE: 不使用ChatGPT时的伪GPT响应
- GPT_ENABLE: 是否使用GPT
- 如不使用ChatGPT生成文本概要,仅生成论文目录以及图片公式,可将其设置为False
- THREAD_RATE_LIMIT: 单个线程(单个APIKEY)的每分钟请求次数
- OpenAI对请求频率存在限制,普通套餐通常为3/min
PDF标题/公式/图片/表格匹配设置
"""PDF Parser - Regular Expression"""
# Special title
ABS_MATCHSTR = "ABSTRACT|Abstract|abstract"
INTRO_MATCHSTR = "I.[\s]{1,3}(INTRODUCTION|Introduction|introduction)"
REF_MATCHSTR = "Reference|REFERENCE|Bibliography"
APD_MATCHSTR = "APPENDIX|Appendix"  # Not used for now
# General title
# FIXME: Misidentification exists
SECTION_TITLE_MATCHSTR = ["[IVX1-9]{1,4}[\.\s][\sA-Za-z]{1,}|[1-9]{1,2}[\s\.\n][\sA-Za-z]{1,}",  # Level 1
                          "[A-M]{1}\.[\sA-Za-z]{1,}|[1-9]\.[1-9]\.[\sA-Za-z]{1,}"]  # Level 2
# Equation & Image
EQUATION_MATCHSTR = '[\s]{0,}\([\d]{1,}[a-zA-Z]{0,1}\)'
IMG_MATCHSTR = 'Fig.[\s]{1,3}[\d]{1,2}|Figure[\s]{1,3}[\d]{1,2}|Tab.[\s]{1,3}[\dIVX]{1,3}|Table[\s]{1,3}[\dIVX]{1,3}'  # Figure & Table
Xmind风格模板
"""Xmind Sytle Template"""
TEMPLATE_XMIND_PATH = 'template.xmind'
调试信息
"""Debuging"""
DEBUG_MODE = False
3. 开箱使用
将PDF论文转换为XMind
cd
python paper2xmind.py --path
运行演示
python paper2xmind.py
常见错误
1.'PDFFigure2PaperParser' object has no attribute 'pdf'
FileNotFoundError: [WinError 2] 系统找不到指定的文件。
Exception ignored in:
Traceback (most recent call last):
File "D:\git\ChatPaper2Xmind\pdf_parser.py", line 31, in del
self.pdf.close()
^^^^^^^^
AttributeError: 'PDFFigure2PaperParser' object has no attribute 'pdf'
- PDF输入路径有误
- PDF文件不存在
- 输入路径包含空格,没有用双引号括起来
- 没有安装Java环境,且使用PDFFIGURE2生成图片
- 设置USE_PDFFIGURE2=False 或 安装Java环境并添加至系统环境变量PATH
2.ImportError: cannot import name 'xmind' from 'XmindCopilot' (unknown location)
Traceback (most recent call last):
File "D:\academic chatgpt series\ChatPaper2Xmind-main\paper2xmind.py", line 3, in
from XmindCopilot import xmind, fileshrink
ImportError: cannot import name 'xmind' from 'XmindCopilot' (unknown location)
- Git未正常拉取XmindCopilot仓库
- 需正确执行环境配置
git clone --recursive https://github.com/MasterYip/ChatPaper2Xmind.git
cd
pip install -r requirements.txt
pip install -r ./XmindCopilot/requirements.txt
未来工作
- 减少GPT请求次数以加快XMind生成速度
- 添加元数据和资源解析功能
- 添加Markdown笔记生成功能
- 优化公式检测(边界检测)
鸣谢
感谢以下项目对本项目的宝贵贡献:
以及其他不小心被忽略的项目 :)
特别感谢开源社区和所有为该项目作出贡献的贡献者。
许可证
本项目在MIT许可下发布。有关详细信息,请参阅LICENSE文件。
作者
Master Yip
电子邮件:2205929492@qq.com
GitHub:Master Yip
QQ 交流群:
加群验证问题答案:Github