Прогнозирование нагрузки на каждый час суток с помощью PatchTST и Temporal Fusion Transformer: сравнительный системный анализ с традиционными методами бустинга (CatBoost) и нейросетевыми моделями на базе N-HiTS
Информационная система для сравнительного анализа моделей прогнозирования почасовой нагрузки: PatchTST, Temporal Fusion Transformer (TFT), N-HiTS и CatBoost. Включает предобработку данных, обучение моделей, валидацию и визуализацию результатов для поддержки принятия решений на энергорынках.
Русская локализация | English Localization | 中文本地化
А. Э. Дзгоев, Е. В. Климкин, В. В. Черняускас, А. В. Брайловский, Р. Н. Резеньков
МИРЭА – Российский технологический университет
119454, Россия, Москва, проспект Вернадского, 78
Известия Кабардино-Балкарского научного центра РАН. 2026. Том 28. № 3. С. 49–70.
DOI: 10.35330/1991-6639-2026-28-3-49-70
УДК: 519.876.5.7:621.311+004.032.26+004.85 MSC: 93A30; 68T05; 62M20
Поступила: 01.04.2026, одобрена после рецензирования: 04.05.2026, принята к публикации: 11.06.2026
Научное сотрудничество
Авторы готовы к научному сотрудничеству с университетами, датацентрами, энергетическими компаниями и производственными предприятиями в области применения вышеописанных моделей, включая трансформеры, для задач прогнозирования нагрузки.
Готовы к проведению пилотирования моделей в производственных и энергетических компаниях с последующим внедрением.
Для цитирования
Дзгоев А. Э., Климкин Е. В., Черняускас В. В., Брайловский А. В., Резеньков Р. Н. Прогнозирование нагрузки на каждый час суток с помощью PatchTST и Temporal Fusion Transformer: сравнительный системный анализ с традиционными методами бустинга (CatBoost) и нейросетевыми моделями на базе N-HiTS // Известия Кабардино-Балкарского научного центра РАН. 2026. Т. 28. № 3. С. 49–70. DOI: 10.35330/1991-6639-2026-28-3-49-70
Аннотация
В современных условиях динамичного поведения спроса и влияния внешних факторов традиционные статистические авторегрессионные методы моделирования (ARIMA, SARIMAX) часто уступают место алгоритмам машинного обучения (Gradient Boosting) и современным архитектурам глубокого обучения (Transformers).
Цель исследования – решение задачи выбора лучшей модели прогнозирования электропотребления на каждый час следующих суток в условиях ограниченности информации с применением современных методов машинного и глубокого обучения: CatBoost, Temporal Fusion Transformer (TFT), PatchTST, N‑HiTS.
Материалы и методы исследования. Код программы написан на языке Python и представлен на открытой платформе GitHub по адресу: https://github.com/KEV0143/Comparative-analysis-of-hourly-load-forecasting-using-PatchTST-TFT-NHiTS-and-CatBoost.
Результаты. В рамках каждого из рассматриваемых методов разработаны новые качественные и адекватные математические модели для прогнозирования электропотребления. Важный математический результат состоит в том, что решение задачи – прогнозирование электропотребления для управления энергосбережением на предприятии – сведено к научно обоснованному выбору одной лучшей модели, что важно с точки зрения как теоретического исследования алгоритмов современного машинного и глубокого обучения моделей, так и их практического применения, учитывая возрастающий объем данных. Задача является значимой для целей оптимизации расхода электроэнергии на предприятии и в регионе в целом.
Заключение. В результате проведенного теоретического анализа и вычислительного эксперимента на реальных данных энергетической компании Российской Федерации получен важный практический вывод о применимости модели CatBoost для решения задач оптимизации расхода электроэнергии на предприятиях. Все полученные в статье выводы подтверждаются результатами проведенных статистических тестов.
Ключевые слова: системный анализ моделей, математическая статистика, краткосрочное прогнозирование, потребление электроэнергии, сравнительный системный анализ, машинное обучение, глубокое обучение, CatBoost, Temporal Fusion Transformer (TFT), PatchTST, N‑HiTS
ВВЕДЕНИЕ
Оперативное и краткосрочное прогнозирование потребления электроэнергии является важной задачей для участников – субъектов оптового рынка электроэнергии и мощности (ОРЭМ) [1]. Высокие ошибки прогнозирования (до 17 % в год) приводят производственные и энергетические предприятия к значительным финансовым потерям из-за штрафов за отклонения, а также снижают эффективность планирования режимов работы генерации и энергосистемы региона [2, 3].
В современных условиях динамичного поведения спроса и влияния внешних факторов традиционные статистические авторегрессионные методы моделирования (ARIMA, SARIMAX) часто уступают место алгоритмам машинного обучения (Gradient Boosting) и современным архитектурам глубокого обучения (Transformers). В данной работе проводится сравнение четырех современных методов машинного обучения моделей: CatBoost, Temporal Fusion Transformer (TFT), N‑HiTS и PatchTST по качеству восстановления закономерностей и прогнозирования потребления электроэнергии на реальных данных российской энергетической компании.
Моделирование и прогнозирование почасового электропотребления для принятия решений при управлении энергосистемой региона представляет собой научно-прикладную задачу на пересечении методов системного анализа, машинного обучения, анализа временных рядов и электроэнергетики. Сложность выбора оптимальной математической модели обусловлена нестационарным, мультимодальным и стохастическим характером данных о нагрузке, на которые влияет большое количество различных независимых переменных ($X$): от метеорологических условий и календарных факторов до экономической активности и особенностей поведения электропотребления. Однако мы придерживаемся научной философии, когда математическая суть (или математический смысл) и польза модели заключаются в том, что факторов должно быть меньше, чем наблюдаемых данных. Если математическая модель с небольшим числом параметров объясняет большую часть наблюдений, является полезной, адекватной и качественной, то это уже большое научное достижение. Исследователям необходимо проверять, на каких данных модель работает, а на каких нет, что свидетельствует о том, что универсальных моделей не существует.
Именно поэтому ученые во всем мире продолжают исследовать, разрабатывать и сравнивать различные математические модели и методы их получения – от статистических и ансамблевых (ARIMA, Gradient Boosting) до современных архитектур глубокого обучения (LSTM, Transformers, гибридные модели) – в поисках наиболее точных и устойчивых решений для определенного набора данных. Даже незначительное снижение ошибки прогнозирования на доли процента (например, снижение MAPE с 2,5 % до 2,0 %) имеет колоссальный экономический эффект, особенно для крупных горно-металлургических компаний и дата-центров. Для крупных промышленных предприятий это означает оптимизацию расходов при оплате за потребленную электроэнергию и сокращение штрафов за отклонения при прогнозировании; для сетевых и генерирующих компаний – повышение надежности, эффективное планирование диспетчерских режимов и снижение затрат на резервные мощности; для центров обработки данных (ЦОД) – прямое снижение эксплуатационных расходов и повышение энергоэффективности [4].
Для крупных промышленных предприятий – субъектов ОРЭМ, таких как горно-металлургические комбинаты, химические и автомобильные заводы, выпускающих энергоемкую продукцию, а также для агрохолдингов электропотребление является одной из главных финансовых статей себестоимости. Точный почасовой прогноз на следующие сутки позволяет таким компаниям эффективно участвовать в ОРЭМ, заключать оптимальные договоры, минимизируя затраты на покупку необходимой энергии. Ошибка в прогнозе ведет либо к закупке недостающей электроэнергии по высокой спотовой цене на балансирующем рынке (БР), либо к продаже излишков энергии по невыгодной цене. Для стимулирования компаний к точному прогнозированию Системный оператор Единой энергетической системы России (СО ЕЭС) накладывает на них штрафы за отклонение прогнозных значений от фактических [5].
Для энергетических компаний точное почасовое прогнозирование – основа безопасного и экономичного функционирования всей энергосистемы в регионе страны. Энергосбытовые компании используют прогнозы для формирования информации об объемах закупок электроэнергии для всего региона. Сетевые компании – для планирования ремонтов, выявления потерь электроэнергии (технических и коммерческих) и управления нагрузкой сетей, предотвращая возможные аварии (так называемая предиктивная аналитика). Для Системного оператора ЕЭС России прогнозирование совокупного электропотребления является основой при составлении суточного графика работы электростанций, обеспечении частотной стабильности и расчете необходимых резервных мощностей. Заниженные прогнозные оценки могут привести к дефициту мощности и отключениям потребителей, завышенные прогнозные значения – к неоправданно дорогому запуску избыточных генерирующих мощностей (например, «газовых» турбин), что в масштабах страны ведет к финансовым потерям в миллиарды рублей [6, 7].
С развитием технологий искусственного интеллекта центры обработки данных (ЦОД, дата-центры) превратились в крупнейших потребителей электроэнергии, а их затраты на энергоснабжение достигают 40–50 % от общих эксплуатационных расходов. Корректный почасовой прогноз нагрузки важен для ЦОД как в оперативном, так и в стратегическом управлении. Он позволяет оптимизировать работу систем охлаждения (самых энергоемких после IT-оборудования) и эффективно задействовать резервные источники питания. В будущем, с ростом требований к «зеленой» энергетике, ЦОД будут стремиться к максимальной интеграции с локальными источниками ВИЭ (солнечные панели, ветрогенераторы), где прогноз собственного потребления станет необходимым условием для балансировки микросистемы и снижения углеродного следа [8–10].
Новизна постановки задачи в настоящей работе определяется комплексным, сравнительным и системным анализом современных разнородных математических моделей прогнозирования электропотребления. Указанные модели разработаны с применением различных методов машинного и глубокого обучения на реальных производственных данных энергетического предприятия Центрального региона России.
ПОСТАНОВКА ЗАДАЧИ И ПРЕДВАРИТЕЛЬНЫЙ СТАТИСТИЧЕСКИЙ СИСТЕМНЫЙ АНАЛИЗ ИМЕЮЩИХСЯ РЕАЛЬНЫХ ДАННЫХ ЭЛЕКТРОПОТРЕБЛЕНИЯ
В данной статье представлен системный сравнительный анализ современных методов машинного и глубокого обучения, охватывающий принципиально разные методы – от градиентного бустинга (CatBoost) до нейросетевых модельных архитектур, специализированных для временных рядов (N‑HiTS, Temporal Fusion Transformer, PatchTST). Новизна исследования заключается в научно обоснованной оценке их эффективности на практической задаче почасового прогнозирования электропотребления при управлении энергосистемами и энергосбережением на промышленных предприятиях.
Предварительный статистический анализ имеющихся реальных данных
Исследование проводилось на реальных данных крупной энергетической компании центрального региона Российской Федерации по одной группе точки поставки (ГТП-1) о потреблении мощности (МВт·ч) и температуре окружающей среды (°C).
Характеристика выборки
Общий объем выборки составил 97177 наблюдений (часовые значения электропотребления, охватывающие период более 11 лет – с 2012-го по 2023 год). Диапазон значений электропотребления варьирует от 2293,76 до 7 755,18 МВт·ч.
Проведены статистические расчеты целевой переменной – электропотребления за каждый час суток:
- среднее выборочное значение – 4681,33 МВт·ч ($\pm 987,74$ МВт·ч);
- медиана – 4649,02 МВт·ч. Близкие значения выборочной средней и медианы указывают на относительную сбалансированность распределения;
- асимметрия (Skewness) – 0,0896. Распределение имеет незначительную правостороннюю асимметрию («хвост» в сторону высоких значений электропотребления);
- эксцесс (Kurtosis) – -0,5303;
- стандартное отклонение – 987,74 МВт·ч;
- мода – 2836,56 МВт·ч. Распределение является плосковершинным (platykurtic), что означает отсутствие часто происходящих экстремальных выбросов и более равномерное распределение значений вокруг среднего по сравнению с нормальным (Гауссовским) законом. Это объясняется суточной цикличностью: потребление регулярно проходит через низкие (ночь) и высокие (день) значения;
- межквартильный размах – 50 % всех наблюдений находится в диапазоне от 3985 МВт·ч. до 5400 МВт·ч.
Проведенный статистический анализ часовых данных электропотребления ГТП-1 за период с 02.01.2012 по 31.01.2023 ($n = 97,177$ наблюдений) выявил следующие закономерности:
-
характер распределения: распределение электропотребления, представленное на рис. 1, демонстрирует признаки, характерные для мультимодального распределения, обусловленного суточными, недельными и сезонными циклами [11]. Значения средней выборочной (4681,33 МВт·ч) и медианы (4649,02 МВт·ч) близки, что указывает на относительно симметричное центральное «ядро» распределения. Однако отметим, что значение моды (2836,56 МВт·ч) существенно ниже, что предполагает наличие низких значений, типичных для ночных часов с минимальной нагрузкой;
-
асимметрия и эксцесс: незначительный положительный коэффициент асимметрии ($\text{Skewness} = 0,0896$) свидетельствует о слабо выраженном «тяжелом» правом «хвосте», обусловленном периодами экстремально высокого потребления (например, пиковые нагрузки электропотребления). Отрицательный эксцесс ($\text{Kurtosis} = -0,5303$) характеризует имеющееся распределение как платикуртическое (platykurtic), что означает более пологую форму кривой плотности по сравнению с нормальным распределением и меньшую частоту экстремальных выбросов. Это согласуется с исследованиями ученых [12], отмечающими, что суточные профили нагрузки, усредненные за длительный период, часто демонстрируют сглаженное распределение из-за наложения множества циклических групп значений электропотребления;
-
волатильность: стандартное отклонение (987,74 МВт·ч) составляет около 21 % от среднего значения, что указывает на существенную внутрисуточную изменчивость. Межквартильный размах ($\text{IQR} \approx 1415$ МВт·ч) подтверждает, что основная часть значений почасового электропотребления сосредоточена в диапазоне умеренных нагрузок, в то время как экстремальные значения (как низкие, так и высокие) относительно редки.
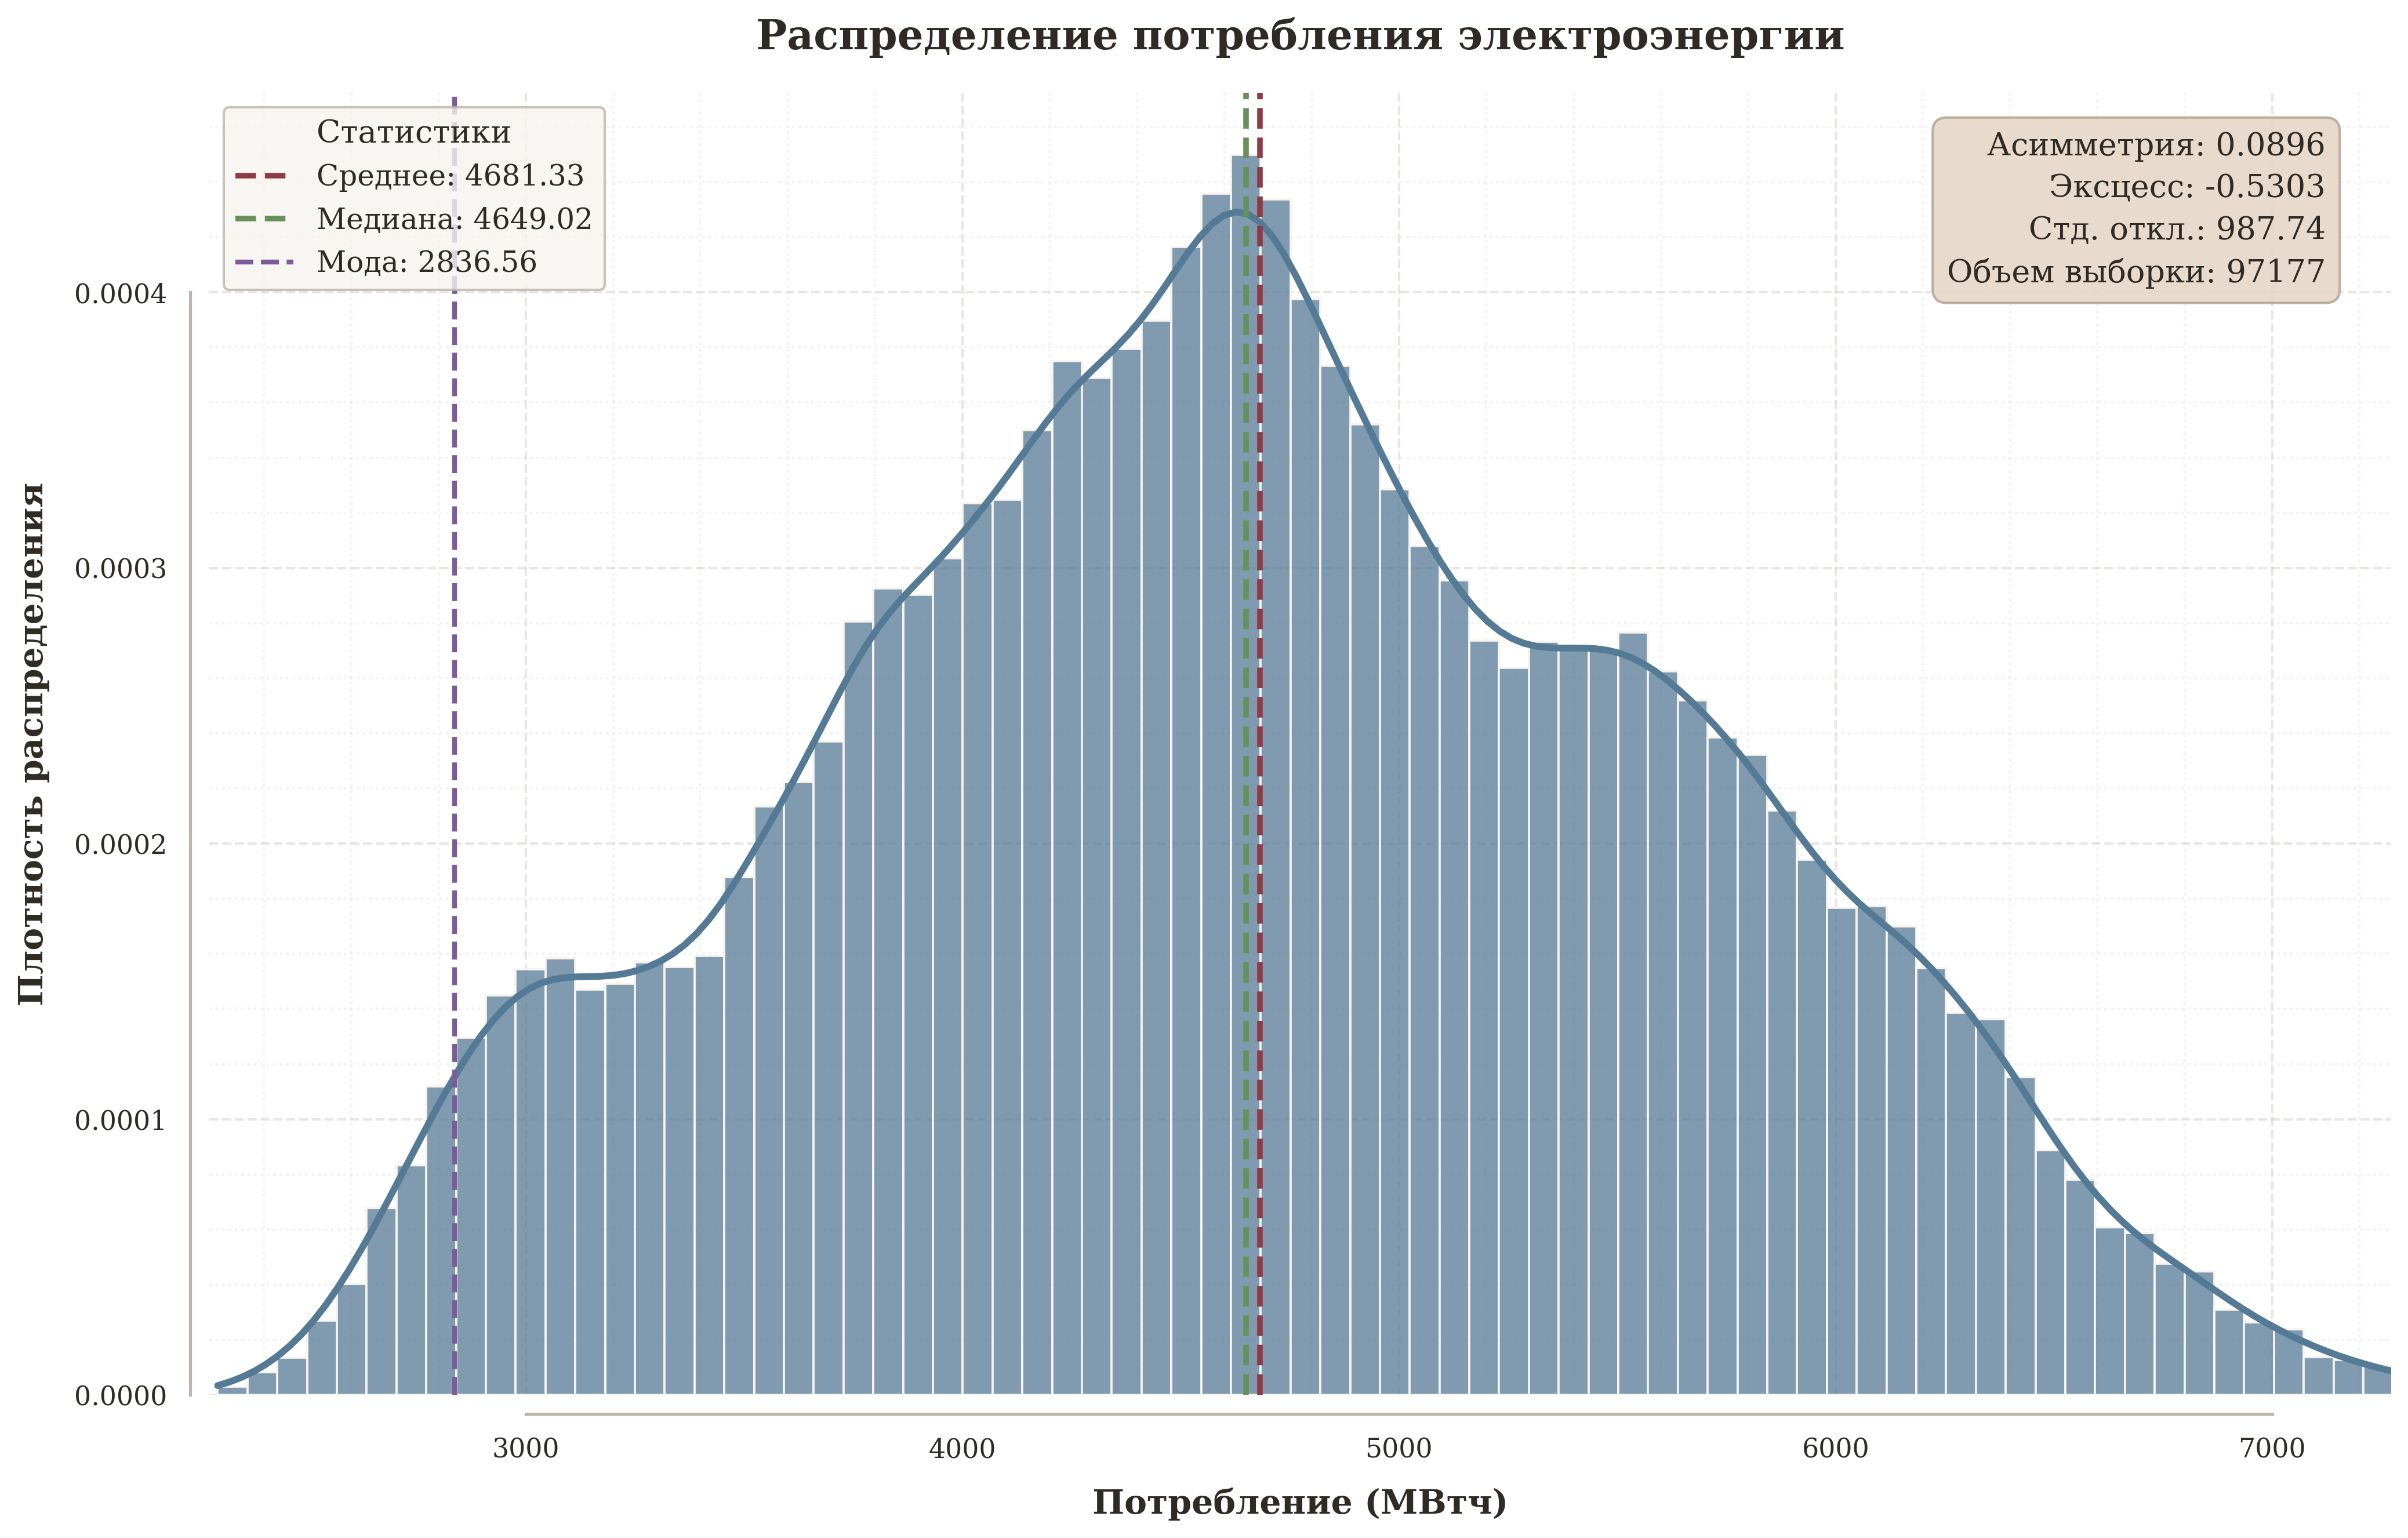
Рис. 1. Распределение электропотребления и результаты предварительного статистического анализа / Fig. 1. Electricity consumption distribution and preliminary statistical analysis results
Проведен статистический анализ значений независимой переменной (температура окружающей среды). Имеющиеся температурные значения характеризуются высокой вариативностью: от –29,9 °C до +34,4 °C, что подтверждает необходимость учета климатического фактора (например, использование калориферов для отопления зимой и кондиционирования летом).
Распределение вероятности температуры окружающей среды также является платикуртическим ($\text{Kurtosis} = -0,5670$) с близкими значениями средней (6,84 °C) и медианы (6,30 °C), а также слабой отрицательной асимметрией (–0,0841). Это указывает на относительную симметричность распределения вокруг среднего значения с небольшим смещением в сторону более низких температур. Широкий разброс значений (стандартное отклонение = 10,61 °C) отражает годовой климатический цикл. График распределения вероятности значений температуры окружающей среды представлен на рис. 2.
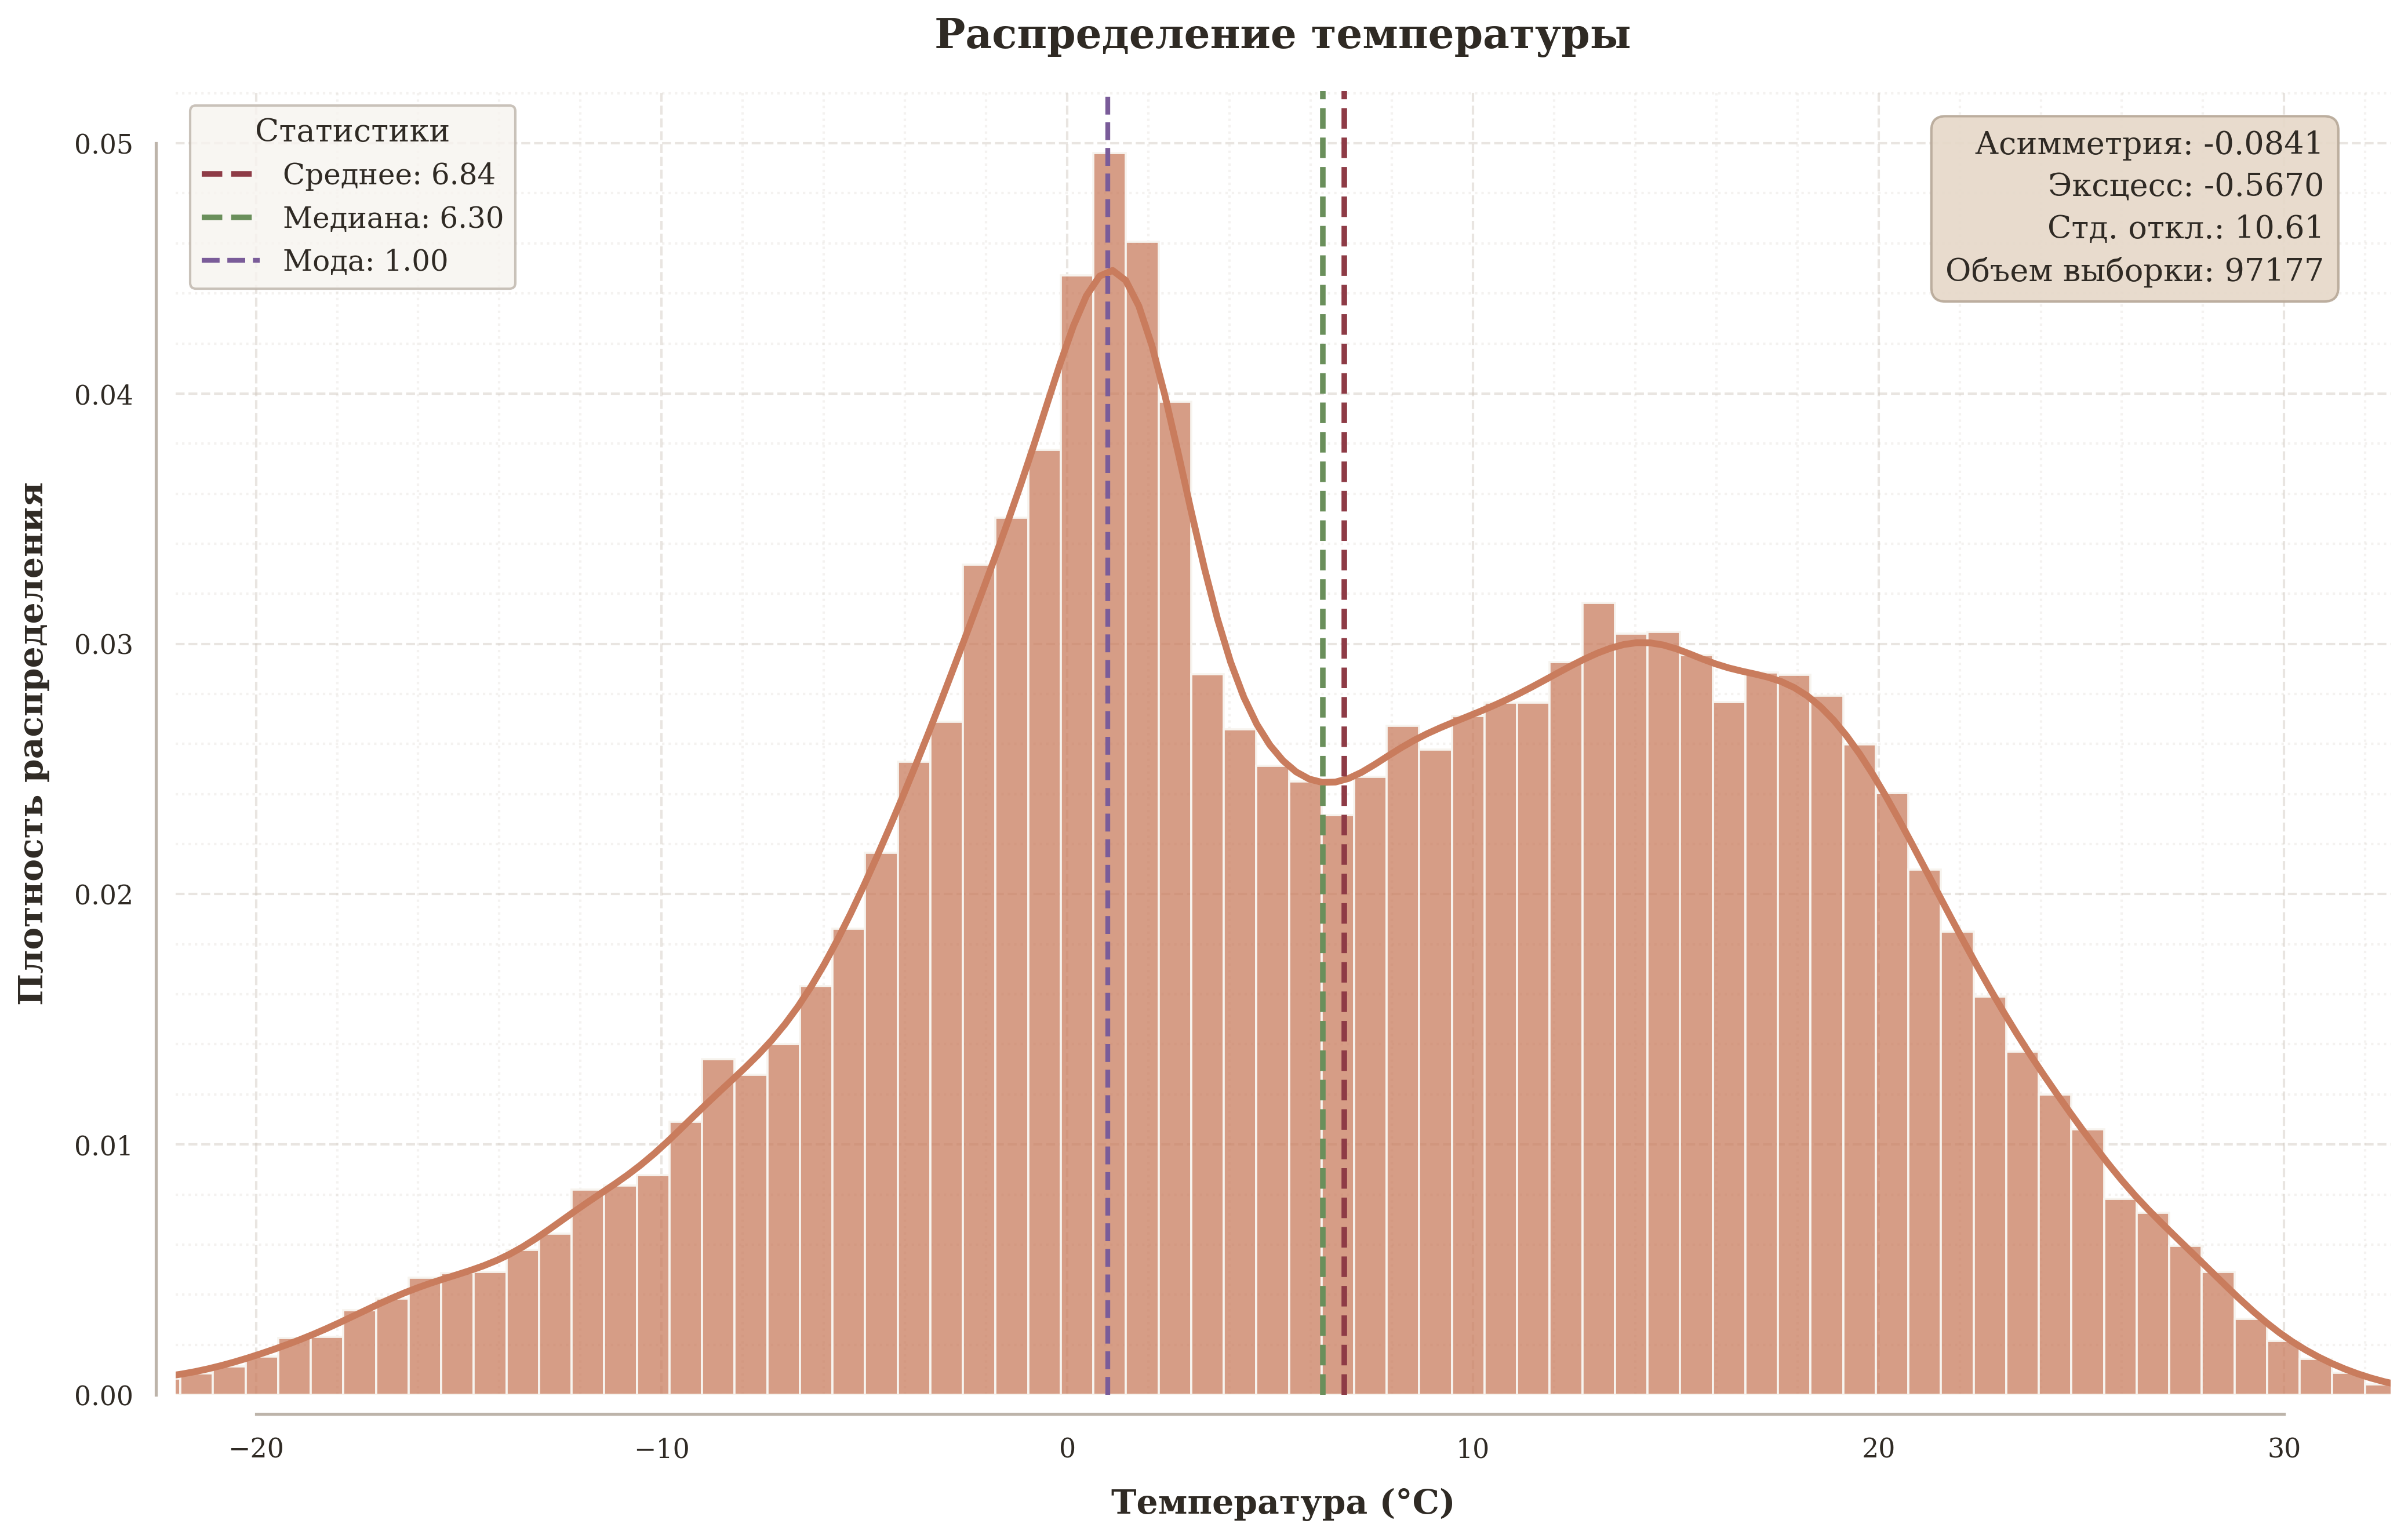
Рис. 2. Распределение значений температуры окружающей среды и результаты предварительного статистического анализа / Fig. 2. Ambient temperature distribution and preliminary statistical analysis results
Графики временных рядов электропотребления и температуры, представленные на рис. 3, демонстрируют:
-
выраженную суточную цикличность с минимумами в ночные часы и максимумами в дневные;
-
сезонную зависимость: потребление электроэнергии коррелирует с температурой. Мы наблюдаем пики как в зимний (отопление), так и в летний периоды (кондиционирование), что соответствует модели «U-образной» зависимости, описанной в работе [13];
-
долгосрочный тренд и антропогенные эффекты: на фоне циклических компонент могут наблюдаться слабые тренды, связанные с изменениями в экономике, энергоэффективности или структуре потребителей [14].

Рис. 3. Графики электропотребления и температуры окружающей среды за 11 лет / Fig. 3. Energy consumption and ambient temperature graphs for 11 years
Таким образом, исходные данные электропотребления представляют собой нестационарный мультисезонный временной ряд с зависимостью от температуры и других факторов (день недели, праздники). Это требует для моделирования и прогнозирования применения современных математических методов, способных улавливать сложные нелинейные зависимости и взаимодействия факторов.
МЕТОДЫ МАШИННОГО И ГЛУБОКОГО ОБУЧЕНИЯ, ИСПОЛЬЗОВАННЫЕ ДЛЯ РАЗРАБОТКИ МАТЕМАТИЧЕСКИХ МОДЕЛЕЙ-КАНДИДАТОВ ПРИ ПРОГНОЗИРОВАНИИ ЭЛЕКТРОПОТРЕБЛЕНИЯ НА КАЖДЫЙ ЧАС СЛЕДУЮЩИХ СУТОК
Обоснование выбора моделей
Для решения задачи моделирования и краткосрочного прогнозирования нагрузки (Short-Term Load Forecasting – STLF) с часовой дискретизацией нами выбраны современные методы, охватывающие различные парадигмы машинного и глубокого обучения моделей:
- CatBoost – выбран за способность эффективно работать с категориальными и временны́ми признаками [15];
- TFT (Temporal Fusion Transformer) – выбран за возможность интерпретировать временную динамику и выявлять сложные зависимости между статическими и динамическими переменными [16];
- N‑HiTS (Neural Hierarchical Interpolation for Time Series) – выбран как современная модель, снижающая вычислительную сложность за счет иерархической интерполяции, что важно для долгосрочного прогнозирования [17];
- PatchTST – выбран в связи с использованием сегментации ряда на «патчи», что позволяет трансформеру лучше улавливать локальные семантические зависимости [18].
Данный выбор обосновывается необходимостью:
- учета сложных нелинейных взаимосвязей между нагрузкой, температурой и временными факторами;
- выявления долгосрочных зависимостей в данных;
- обеспечения интерпретируемости и надежности прогноза.
Метод градиентного бустинга на деревьях принятия решений (CatBoost)
CatBoost [19] является представителем класса алгоритмов градиентного бустинга, который применяется в задачах системного анализа и обработки табличных данных с категориальными признаками. Для прогнозирования нагрузки его преимущества заключаются в следующем:
- автоматическая обработка категориальных признаков – эффективная работа с такими важными факторами, как час дня, день недели, тип дня (рабочий/выходной/праздничный), месяц, что полезно при учете суточной и недельной сезонности;
- устойчивость к переобучению – благодаря упорядоченному бустингу и регуляризации;
- интерпретируемость – возможность оценки важности признаков (Feature Importance), что позволяет валидировать физическую и экономическую обоснованность модели (например, подтвердить значимость температуры и пикового электропотребления).
Рассмотрим алгоритм обновления моделей и вычисления значений для оценки градиента в CatBoost [19].
Пусть задана выборка ${(X_k, Y_k)}_{k=1}^n$, упорядоченная согласно случайной перестановке $\sigma$, и число деревьев $I$. Обозначим $M_i(X)$ – модель после $i$-го шага обучения для объекта $X$. Инициализируем $M_i(X) = 0$ для всех $i = 1, \dots, n$. На каждой итерации $\text{iter} = 1, \dots, I$ для каждого объекта $i = 1, \dots, n$ вычисляются градиенты функции потерь $L(y, a)$ по предсказаниям модели на предыдущем шаге. Для всех $j = 1, \dots, i - 1$ градиент определяется по формуле 1:
$$ g_j = \left. \frac{\partial L(y_j, a)}{\partial a} \right|_{a = M_i(X_j)} $$
Затем на основе множества пар ${(X_j, g_j)}_{j=1}^{i-1}$ строится одно решающее дерево $M$ с использованием алгоритма построения дерева в градиентном бустинге. После чего модель для объекта $i$ обновляется по правилу:
$$ M_i \leftarrow M_i + M $$
По завершении всех итераций алгоритм возвращает значения моделей $M_1, \dots, M_n$ и предсказания $M_1(X_1), M_2(X_2), \dots, M_n(X_n)$ [19].
Temporal Fusion Transformer (TFT)
Модель TFT [20] является современной нейросетевой архитектурой глубокого обучения моделей. Алгоритм TFT специально разработан для интерпретируемого многомерного прогнозирования временных рядов. TFT явным образом разделяет и обрабатывает известные будущие значения независимых переменных $X$ (например, календарные признаки), наблюдаемые факторы (лаговые значения электропотребления, температуры окружающей среды). Такой алгоритм соответствует задаче, где температура воздуха на будущий час следующих суток может быть известна из информационных ресурсов метеопрогнозирования. Механизм «внимания» позволяет модели напрямую устанавливать зависимости между любыми двумя временными точками прошлого периода, что эффективнее рекуррентных сетей для длинных последовательностей. TFT обеспечивает интерпретируемость на уровне признаков и временных шагов, показывая, какие исторические периоды и какие переменные были наиболее важны для конкретного прогноза [20].
PatchTST (GluonTS)
PatchTST представляет собой прорывной подход, применяющий архитектуру Transformer к временным рядам через патчинг. В отличие от модели TFT PatchTST оптимизирован для работы с одномерными временными рядами и демонстрирует точность за счет двух новых методов обработки данных: разбиения временного ряда на субрядные патчи (patches) и использования канальной независимости (каждый ряд прогнозируется отдельно). Это позволяет глубоко изучать внутренние временные зависимости электропотребления. Подход демонстрирует качественную производительность на большой выборке данных зависимой переменной и часто превосходит классические методы глубокого обучения [21].
N‑HiTS
N‑HiTS – это современная иерархическая архитектура на основе полностью связных сетей (FCN), разработанная специально для долгосрочного прогнозирования. Модель использует несколько ветвей (stacks), каждая из которых учится предсказывать тренд на разной степени сглаживания (разной скорости) и интерполяционных слоев. Это позволяет чрезвычайно эффективно моделировать мультисезонность (суточную, недельную, годовую) в матрицах имеющихся данных. N‑HiTS достигает точности при значительно меньших вычислительных затратах и числе параметров по сравнению с Transformer-архитектурами, что важно для оперативного и краткосрочного прогнозирования электропотребления [17].
Представленный статистический анализ имеющихся реальных данных подтверждает сложный, циклический и зависимый от внешних факторов характер временного ряда электропотребления. Выбор ансамбля методов CatBoost, TFT, PatchTST и N‑HiTS является научно обоснованным и комплексным. Он позволяет:
- использовать сильные стороны разных моделей (бустинг, архитектуры нейронных сетей с механизмом «внимания», иерархические FCN);
- провести сравнительный анализ для выявления наиболее адекватной модели для конкретного профиля группы точки поставки электроэнергии;
- обеспечить робастность прогнозной системы за счет ансамблирования или выбора наилучшей модели;
- получить как точечные прогнозы, так и интерпретацию факторов, влияющих на потребление.
Дальнейшее исследование будет направлено на обучение, валидацию и сравнительный анализ качества этих моделей с учетом специфики исходного временного ряда, описанной в данном анализе.
ИССЛЕДОВАНИЕ ФАКТОРОВ И ИХ РАНЖИРОВАНИЕ
В результате проведенного исследования были выявлены следующие факторы, распределенные на две основные группы:
- Временные (календарные) – час, день недели, месяц, а также их циклические представления (sin/cos) и бинарный признак выходного дня (выходной день / рабочий день).
- Исторические (лаговые) – значения электропотребления с лагами (в т.ч. 1–12, 24 и 168 часов), скользящие средние по потреблению электроэнергии (например, за 6/24/168 часов) и температура окружающей среды (лаговые значения).
Проведено ранжирование факторов по степени влияния на зависимую переменную потребления электроэнергии.
Анализ важности независимых переменных имеющихся данных показал, что наибольший вклад в прогнозные значения вносят авторегрессионная составляющая временного ряда и суточный календарный профиль.
Графический результат ранжирования факторов представлен на рис. 4.

Рис. 4. Ранжирование факторов и вклад факторов в модель / Fig. 4. Factor ranking and feature contributions to the model
Факторы $sin$ и $cos$ используются для возможности учета циклического характера электропотребления на предприятии. Нагрузка повторяется по часам суток, дням недели и месяцам. Например, 23:00 и 00:00 являются соседними моментами времени, и по режиму электропотребления эти часы ближе друг к другу, чем 23:00 и 12:00. Однако при числовой записи часа этот факт не отражается. Использование $sin$ и $cos$ позволяет задать такую периодичность без разрывов и тем самым точнее описывать влияние календарных факторов на электропотребление. На рис. 4 отображено, что по степени влияния на электропотребление, по имеющимся данным, фактор «Час» ($cos$) на втором месте, а фактор «Час» ($sin$) на шестом месте.
Проведен системный анализ ранжирования факторов по их группам. Результаты представлены на рис. 5.

Рис. 5. Ранжирование факторов по их группам / Fig. 5. Factor ranking by group
Необходимо отметить, что электропотребление – цикличный процесс, обусловленный жизнедеятельностью человека, поэтому исторические лаги поведения электропотребления имеют большее влияние на целевую зависимую переменную, чем климатические по имеющимся данным.
РАЗДЕЛЕНИЕ ИСХОДНОЙ ВЫБОРКИ И ОБУЧЕНИЕ РЕГРЕССИОННЫХ МОДЕЛЕЙ
Исходная выборка данных была разделена хронологически, чтобы избежать так называемого «заглядывания в будущее» («data leakage»):
- обучающая выборка (train) – основной массив данных (первые ~90 % данных);
- валидационная выборка (validation) – следующие 9 % для настройки гиперпараметров моделей и оценки качества;
- тестовая выборка (test) – последние 168 часов (24 ч, 72 часа, 168 часов) для финальной оценки качества и адекватности моделей и проверки точности прогнозирования электропотребления.
Настройка гиперпараметров
Для исследуемых моделей экспериментально был подобран горизонт прогноза 168 часов. Количество эпох варьировало от 20 до 60. Оценка точности оценивалась по функции потерь RMSE. В табл. 1 представлены значения основных гиперпараметров моделей и их описание.
CatBoost (Gradient Boosting) N‑HiTS. В качестве базового решения (baseline) использовался алгоритм градиентного бустинга. Глубина дерева ($\text{Depth} = 6$): выбрано среднее значение между смещением и дисперсией. Более глубокие деревья ($\text{Depth} = 8\text{--}10$) на имеющейся выборке приводят к быстрому переобучению модели. Итерации (1000): достаточное количество деревьев для сходимости функции потерь при скорости обучения ($\text{Learning Rate}$) 0.03.
N‑HiTS (Neural Hierarchical Interpolation). Модель основана на иерархическом прогнозировании через стеки (stacks) с различной частотой дискретизации. Коэффициенты пулинга ([8, 4, 1]) – основной гиперпараметр. Первый блок ($\text{kernel size} = 8$) сглаживает входные данные, улавливая тренд. Второй блок (4) моделирует среднесрочные колебания, а третий (1) работает с исходным сигналом для восстановления высокочастотных деталей. Ширина MLP (512): использование широких полносвязных слоев позволяет модели аппроксимировать сложные нелинейные зависимости.
Табл. 1. Основные гиперпараметры моделей / Table 1. Core model hyperparameters.
| Модель | Гиперпараметр | Значение | Описание |
|---|---|---|---|
| CatBoost | Iterations | 1000 | Количество деревьев ансамбля |
| CatBoost | Depth | 6 | Глубина дерева |
| CatBoost | Learning Rate | 0,03 | Скорость обучения (eta) |
| N‑HiTS | n_stacks | 3 | Количество частотных блоков |
| N‑HiTS | Pooling Sizes | [8, 4, 1] | Ядра иерархической интерполяции |
| N‑HiTS | MLP Width | 512 | Размер скрытых слоев |
| PatchTST | Patch Length | 16 | Длина сегмента (токена) |
| PatchTST | Stride | 8 | Шаг патчинга (overlap 50%) |
| PatchTST | d_model | 128 | Размерность эмбеддинга |
| TFT | Hidden Size | 64 | Размер скрытого состояния |
| TFT | LSTM Layers | 2 | Число рекуррентных слоев |
| TFT | Attention Heads | 4 | Число «экспертов» механизма внимания |
PatchTST (Patch Time Series Transformer). Трансформерная архитектура модели, рассматривающая временной ряд как последовательность сегментов (патчей). Длина патча (16) и Шаг (8): временной ряд разбивается на отрезки длиной 16 часов. Шаг (stride), равный 8, обеспечивает 50 % перекрытие соседних патчей, что позволяет сохранить непрерывность и устранить артефакты на границах сегментов.
TFT (Temporal Fusion Transformer). Гибридная архитектура модели, объединяющая механизмы внимания и LSTM. Hidden Size (64): размерность скрытого пространства намеренно ограничена значением 64. Эксперименты показали, что увеличение до 128 или 256 кратно увеличивает время обучения, но дает незначительный прирост точности. LSTM Layers (2): двухслойный энкодер для захвата локальной темпоральной динамики перед передачей данных в блок Self-Attention.
ОЦЕНКА КРИТЕРИЕВ КАЧЕСТВА И ВЫБОР МОДЕЛИ
На обучающей выборке модели показали сходимость функции потерь. Модель CatBoost продемонстрировала наиболее плавное снижение ошибки без признаков переобучения. Сложные нейросетевые модели (особенно PatchTST) продемонстрировали нестабильность (высокую волатильность Loss-функции), что свидетельствует о необходимости большего объема данных или более тонкой настройки гиперпараметров для трансформеров на одномерном временном ряде. Результаты оценки качества моделей представлены в табл. 2.
Модель CatBoost по сравнению с другими моделями показала наилучшие результаты на имеющихся данных, что говорит о высокой эффективности градиентного бустинга для задач с выраженной сезонностью и календарными зависимостями. Модель TFT показала второй результат, но следует отметить, что на периоде прогнозирования в 168 часов наблюдается снижение ошибки по сравнению с 72 часами, что говорит о способности этой модели описывать недельные циклы. Также необходимо сказать, что с увеличением периода прогнозирования до 168 часов наблюдается заметное ухудшение качества у модели PatchTST (коэффициент детерминации $R^2$ снижается до 0,88), что свидетельствует о трудностях трансформерных архитектур в долгосрочном прогнозировании на данном наборе данных без достаточного объема выборки для обучения.
Табл. 2. Результаты оценки качества моделей / Table 2. Model performance evaluation results.
| Период прогноза | Модель | MAE | RMSE | MAPE (%) | $R^2$ |
|---|---|---|---|---|---|
| 24 часа | N‑HiTS | 120,81 | 145,75 | 2,01 | 0,96 |
| 24 часа | PatchTST | 139,53 | 162,84 | 2,27 | 0,95 |
| 24 часа | TFT | 69,15 | 87,03 | 1,13 | 0,99 |
| 24 часа | CatBoost | 38,25 | 46,24 | 0,62 | 1,00 |
| 72 часа | N‑HiTS | 127,58 | 151,11 | 2,15 | 0,95 |
| 72 часа | PatchTST | 147,78 | 175,12 | 2,42 | 0,94 |
| 72 часа | TFT | 78,99 | 107,41 | 1,32 | 0,98 |
| 72 часа | CatBoost | 39,23 | 47,19 | 0,65 | 1,00 |
| 168 часов | N‑HiTS | 132,03 | 157,73 | 2,19 | 0,95 |
| 168 часов | PatchTST | 203,06 | 241,52 | 3,27 | 0,88 |
| 168 часов | TFT | 73,56 | 103,33 | 1,22 | 0,98 |
| 168 часов | CatBoost | 41,28 | 50,67 | 0,68 | 0,99 |
На рис. 6 представлены графические результаты сравнения моделей по динамике функции потерь и по разбросу ошибок прогнозирования. CatBoost демонстрирует монотонное снижение ошибки. Модель выходит на плато к 40 % итераций, что говорит нам о предсказуемости результата. Трансформеры (PatchTST, N‑HiTS) показывают высокую волатильность функции потерь. В частности, график PatchTST свидетельствует о том, что модель не может найти устойчивый глобальный минимум на имеющемся объеме данных. Анализ распределения остатков (ошибок) на валидационной выборке показывает: модель CatBoost имеет самый узкий межквартильный размах, что означает минимальную дисперсию ошибки. Модели PatchTST и N‑HiTS имеют «широкие» распределения с большим количеством выбросов.
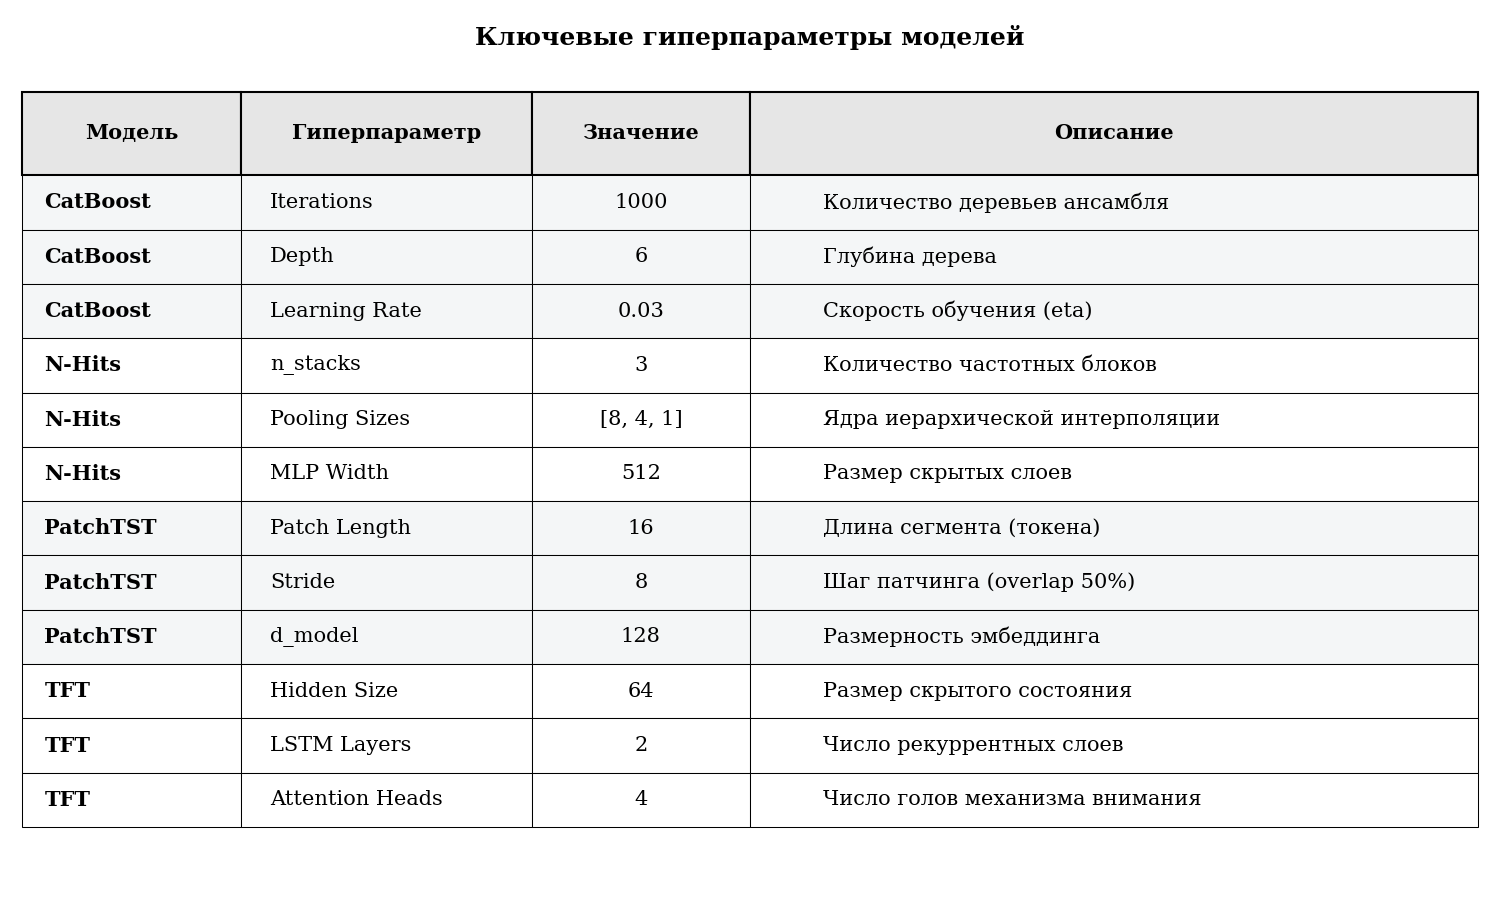
Рис. 6. Сравнение моделей по функции потерь и по разбросу ошибок прогнозирования / Fig. 6. Model comparison by loss function and forecast error distribution
Подтверждает текущие расчеты и сравнение моделей по значениям стандартного отклонения $\sigma$, представленное в табл. 3.
Табл. 3. Сравнение моделей по значениям среднеквадратической ошибки и стандартного отклонения / Table 3. Model comparison based on mean squared error and standard deviation.
| Модель | Std Dev ($\sigma$) |
|---|---|
| CatBoost | 0,012 |
| TFT | 0,058 |
| N‑HiTS | 0,142 |
| PatchTST | 0,2015 |
Низкое значение $\sigma$ у CatBoost указывает на устойчивую сходимость, тогда как высокие значения модели PatchTST свидетельствуют о волатильности процесса обучения.
В результате проведенного исследования для прогнозирования электропотребления была выбрана модель CatBoost.
ПРОГНОЗИРОВАНИЕ ЭЛЕКТРОПОТРЕБЛЕНИЯ НА КАЖДЫЙ ЧАС СУТОК
Проведены расчеты прогнозирования электропотребления для различных периодов: 24 – 72 – 168 часов на основе исследуемых моделей искусственного интеллекта. Результаты прогнозирования представлены на рис. 7–9.
На периоде прогнозирования «сутки вперед» модель CatBoost показала лучшие результаты по сравнению с другими моделями. Средняя абсолютная процентная ошибка (MAPE) составляет 0,62 %, что является высоким показателем для задач прогнозирования потребления электроэнергии. Модель TFT показала ошибку 1,13 %. Модели N‑HiTS и PatchTST демонстрируют отставание от вышеописанных моделей с ошибкой MAPE выше 2,0 %, что говорит нам о сложности настройки трансформерных архитектур на коротком периоде.
При увеличении периода прогнозирования до трех суток наблюдается проверка моделей на устойчивость к накоплению ошибки. CatBoost подтверждает свою робастность: метрики ухудшились незначительно. Это указывает на то, что модель эффективно использует лаговые признаки и календарные факторы.
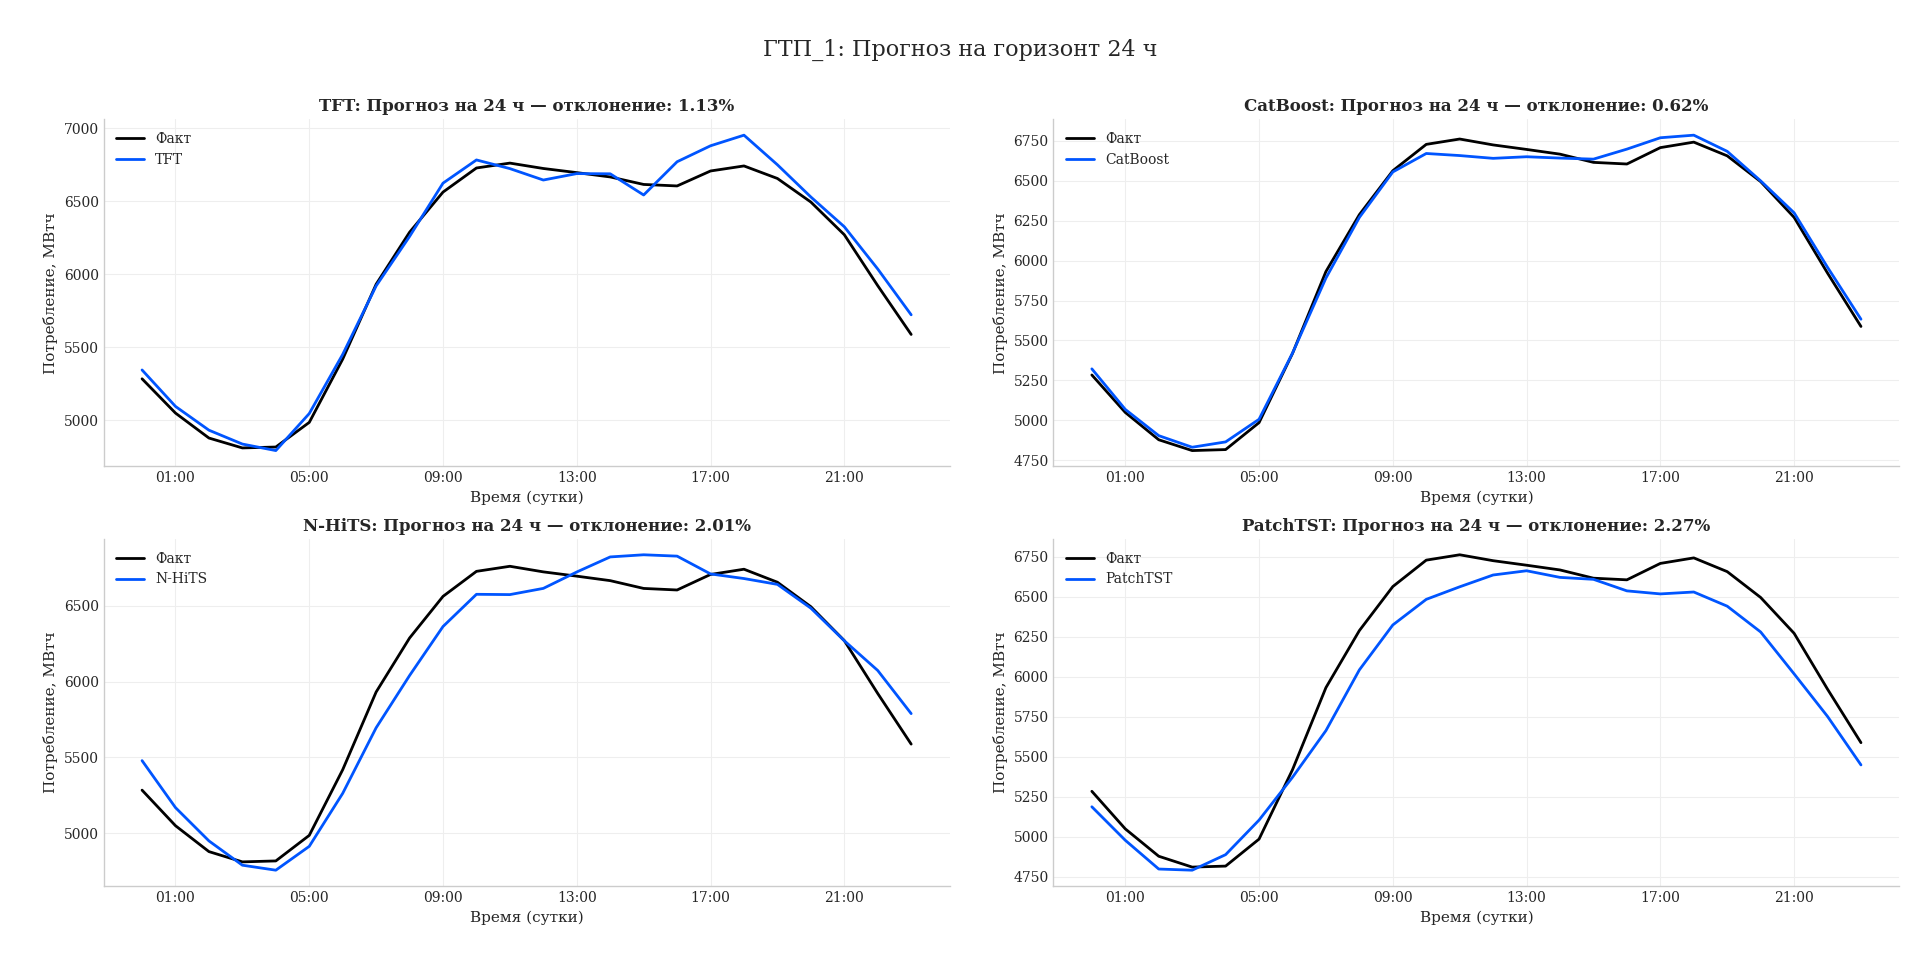
Рис. 7. Прогнозирование электропотребления на 24 часа / Fig. 7. 24-hour electricity consumption forecasting
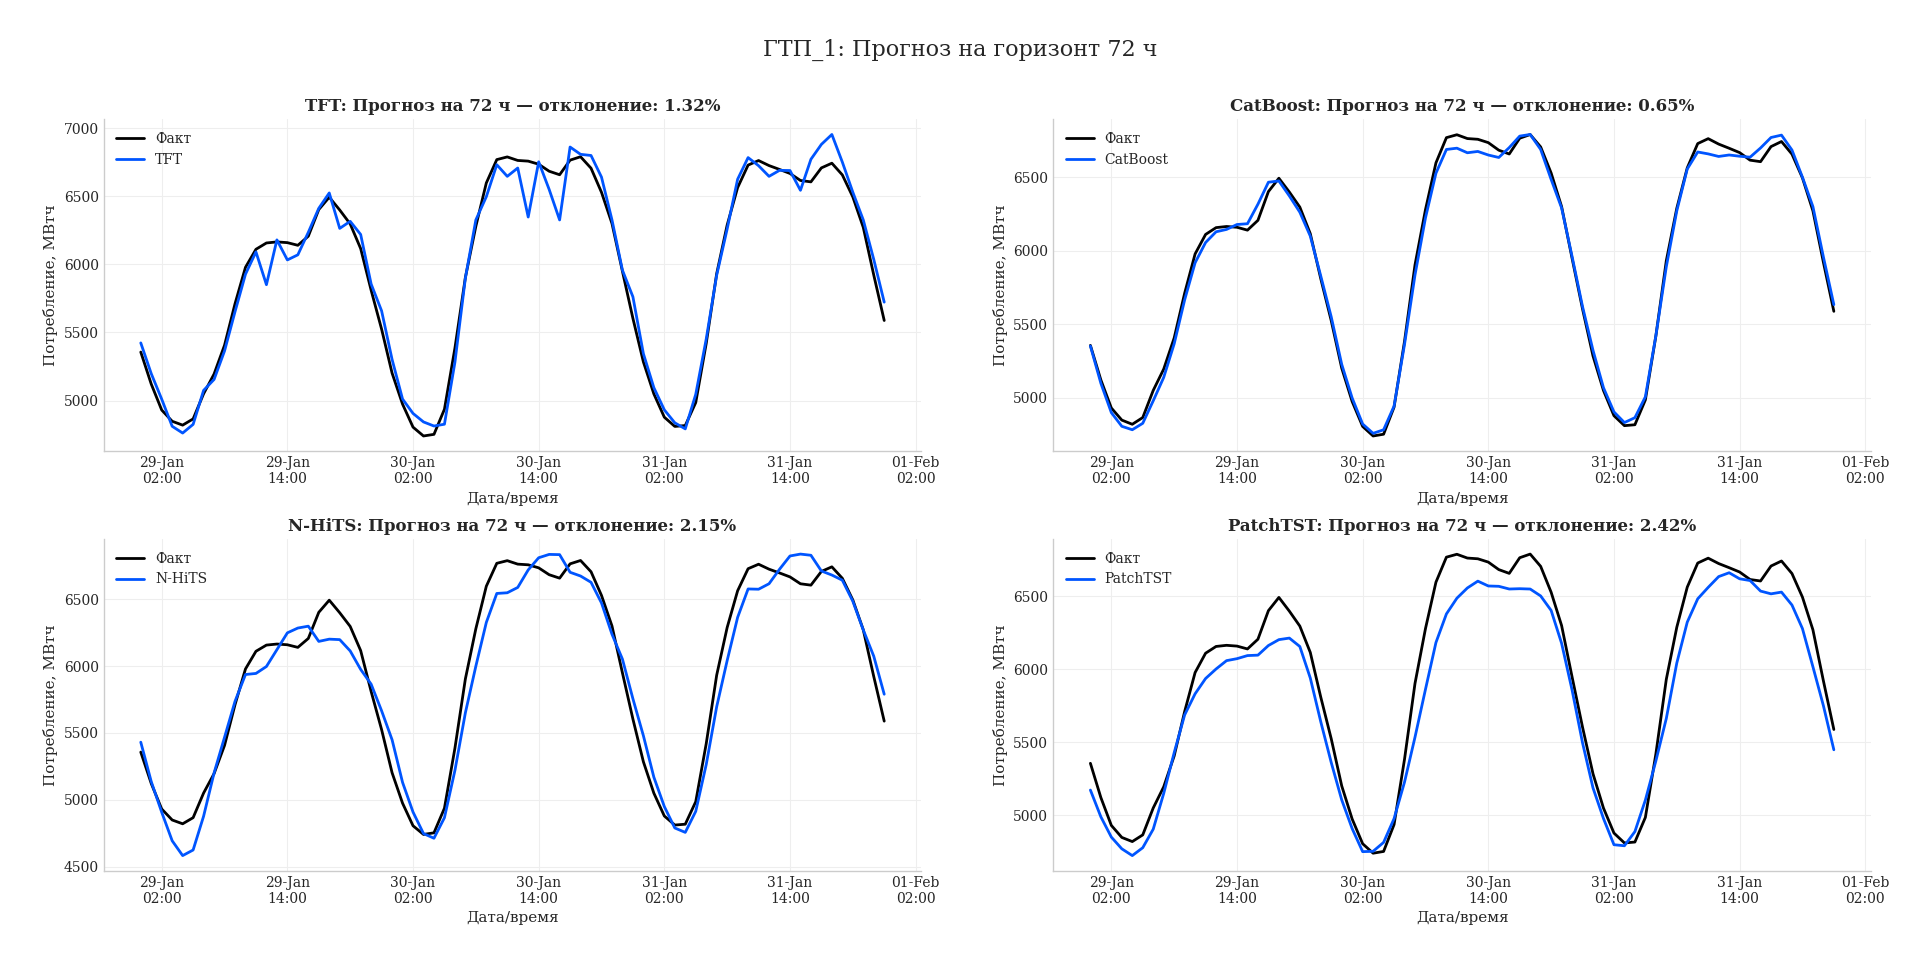
Рис. 8. Прогнозирование электропотребления на 72 часа / Fig. 8. 72-hour electricity consumption forecasting
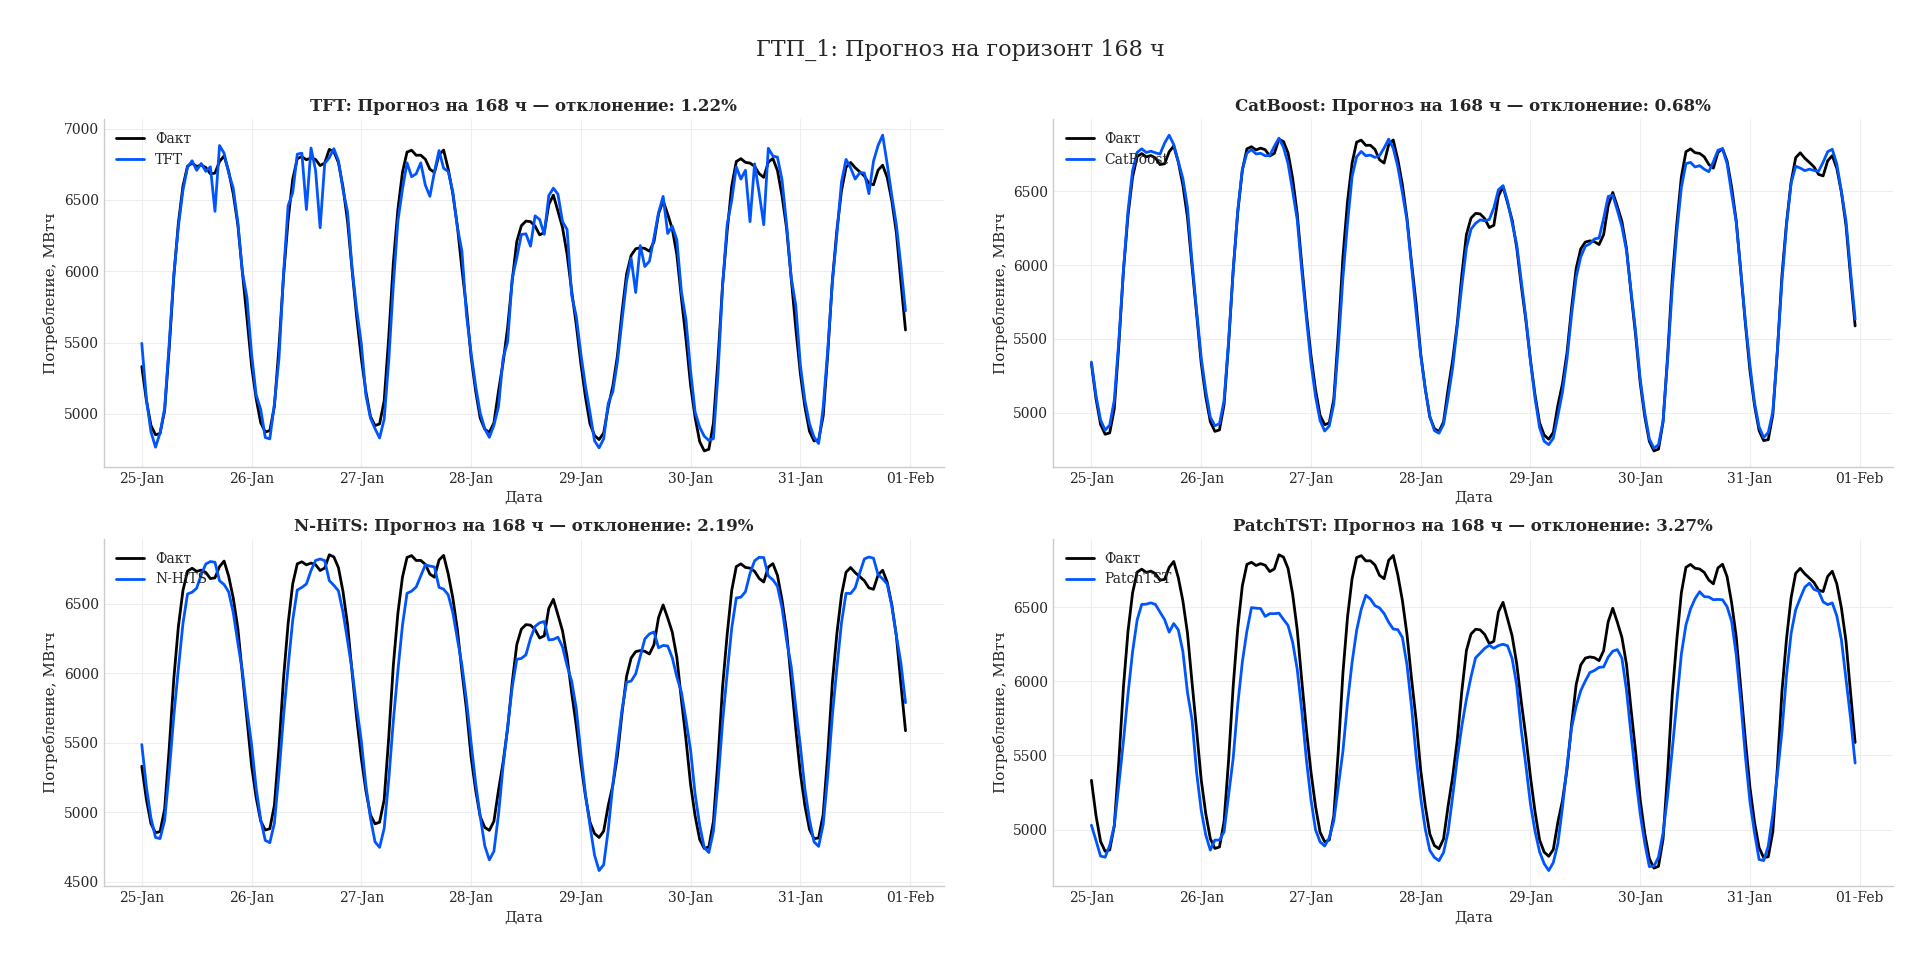
Рис. 9. Прогнозирование электропотребления на 168 часов / Fig. 9. 168-hour electricity consumption forecasting
Отметим поведение модели TFT: на периоде прогнозирования 168 часов ошибка RMSE (103,33) оказалась ниже, чем на периоде в 72 часа (107,41). Это объясняется архитектурой Temporal Fusion Transformer, которая эффективно описывает недельные циклы. Модель PatchTST демонстрирует резкое падение качества: коэффициент детерминации снизился до 0,88, а ошибка MAPE выросла до 3,27 %. Это подтверждает нестабильность данной архитектуры для имеющихся данных.
СТАТИСТИЧЕСКИЙ СИСТЕМНЫЙ АНАЛИЗ ОСТАТКОВ (RESIDUALS) И ДИАГНОСТИКА
Для оценки качества модели CatBoost был проведен системный анализ остатков прогнозирования, рассчитанных по формуле (2):
$$ \text{Residuals} = Y_{\text{forecast}} - Y_{\text{actual}} $$
Анализ статистических свойств полученного ряда ошибок (за период тестовой недели, 168 часов) показал следующие результаты:
- Систематическая ошибка (Bias) – среднее значение остатков составляет 8,14 МВт·ч. Учитывая, что среднее потребление по выборке составляет более 4600 МВт·ч, относительное смещение прогноза составляет менее 0,2 %. Это свидетельствует об отсутствии значимой систематической недооценки или переоценки объема потребления моделью.
- Дисперсия ошибки – стандартное отклонение остатков ($\sigma$) составляет 50,16 МВт·ч. Это значение характеризует средний разброс ошибки и используется для построения доверительных интервалов.
- Форма распределения:
- Асимметрия (Skewness) – -0,0283. Значение практически равно нулю, что указывает на симметрию распределения ошибок (количество положительных и отрицательных ошибок сбалансировано).
- Эксцесс (Kurtosis) – 0,0751. Значение, близкое к нулю, подтверждает, что «хвосты» распределения соответствуют нормальному закону (нет аномально частого появления экстремальных ошибок).
Гистограмма распределения остатков, представленная на рис. 10, визуально подтверждает форму колокола (кривой Гаусса), центрированного вблизи нуля.

Рис. 10. Гистограмма распределения остатков / Fig. 10. Histogram of residual distribution
Для верификации статистической надежности модели была проведена серия тестов.
Проверка на нормальность распределения остатков (Normality Test). Был использован критерий Шапиро-Уилка, который показал следующие результаты: $W = 0,9871$, $p\text{-value} = 0,1249$. Так как $p\text{-value} > 0,05$ (уровень значимости), нулевая гипотеза о нормальном распределении остатков не отвергается. График (Q-Q Plot), представленный на рис. 11, демонстрирует, что точки остатков лежат практически на теоретической прямой, что также подтверждает нормальность.

Рис. 11. Графический результат проверки остатков на нормальное распределение / Fig. 11. Graphical results of the residual normality test
Проверка на автокорреляцию остатков (Autocorrelation). Для проверки гипотезы о независимости ошибок были использованы Q-тест Льюнг-Бокса и анализ автокорреляционной функции (ACF), графически представленный на рис. 12. В результате было получено значение $p\text{-value} < 0,05$ на лагах остатков 24 и 48 часов. Следовательно, в остатках сохраняется периодическая зависимость из-за сложной внутрисуточной структуры электропотребления, которую модель не выявила. Однако, учитывая величину ошибки ($\text{MAPE } 0,68\text{ %}$) и подтвержденную нормальность распределения, полученная автокорреляция в остатках не является критической для практического применения модели при прогнозировании электропотребления в энергетических организациях и на промышленных предприятиях.

Рис. 12. Графические результаты значений автокорреляции в остатках / Fig. 12. Autocorrelation function (ACF) plot for residuals
Оценка гомоскедастичности остатков. Анализ динамики остатков во времени, графически представленный на рис. 13, показывает, что дисперсия ошибки остается относительно постоянной на протяжении всего периода прогноза. Отсутствуют явные эффекты расширения коридора ошибок, что говорит о стабильности модели вне зависимости от уровня нагрузки.

Рис. 13. Графические результаты оценки гомоскедастичности остатков / Fig. 13. Graphical assessment of residual homoscedasticity
В результате проведенной оценки адекватности был сделан вывод, что модель CatBoost признана статистически адекватной. Нормальность остатков позволяет корректно строить вероятностные доверительные интервалы для оценок прогнозирования электропотребления на предприятии.
ЗАКЛЮЧЕНИЕ
В статье проведен системный статистический анализ современных методов машинного обучения и искусственного интеллекта для создания и настройки моделей прогнозирования электропотребления на каждый час суток. Обоснованы настройки гиперпараметров для каждой модели для имеющихся реальных данных энергетической компании. Представлены научные доказательства выбора лучшей регрессионной модели из набора моделей-кандидатов в решении задач прогнозирования электропотребления на имеющихся реальных данных предприятия.
Данная задача является значимой при решении проблем составления прогнозных заявок электропотребления предприятий для оптового рынка электроэнергии и мощности, а также для выбора режима нагрузки в энергосистеме страны. Решение задачи обеспечивает значительную экономию денежных средств на предприятии за счет уменьшения ошибки прогнозирования в среднем до 1 %.
Обоснованный метод моделирования и модель CatBoost при анализе данных представляют собой эффективный инструмент искусственного интеллекта при решении задачи прогнозирования электропотребления на каждый час суток.
В результате проведенного системного анализа данных и рассмотренных методов машинного обучения получен практически значимый результат: решение многокритериальной задачи прогнозирования может быть сведено к использованию модели CatBoost, способной как описывать имеющиеся данные, так и определять изменения целевого процесса. Все полученные в данном исследовании теоретические выводы подтверждаются результатами проведенных расчетов.
В дальнейшем планируется добавление в набор моделей-кандидатов других методов машинного обучения и искусственного интеллекта. Продолжение исследования заключается в развитии и усовершенствовании метода обработки данных, в адаптации выбранных регрессионных моделей к изменениям в данных.
СПИСОК ЛИТЕРАТУРЫ
-
Карпенко С. М., Карпенко Н. В., Ематин Е. А., Марат Ш. Планирование электропотребления промышленного предприятия в условиях оптового рынка электроэнергии // Энергобезопасность и энергосбережение. 2024. № 6. С. 35–40. EDN: CKFPVC
-
Карпенко С. М., Карпенко Н. В., Ематин Е. А., Джунджу Д. Многофакторный статистический анализ показателей оптового рынка электроэнергии (на примере ценовой зоны) // Энергобезопасность и энергосбережение. 2024. № 4. С. 37–42. EDN: QBTQHW
-
Бык Ф. Л., Мышкина Л. С. Экономическая эффективность современной электроэнергетики // Энергетик. 2022. № 1. С. 17–21. EDN: OGTFOW
-
Hong T., Fan S. Probabilistic electric load forecasting: A Tutorial Review. International Journal of Forecasting. 2016. Vol. 32. No. 3. Pp. 914–938. DOI: 10.1016/j.ijforecast.2015.11.011
-
Dudek G. Pattern-based local linear regression models for short-term load forecasting. Electric Power System Research. 2016. No. 130. Pp. 139–147. DOI: 10.1016/j.epsr.2015.09.001
-
Gochhait S., Sharma D.K. Regression model-based short-term load forecasting for load despatch centre. Journal of Applied Engineering and Technological Science. 2023. Vol. 4(2). Pp. 693–710. DOI: 10.37385/jaets.v4i2.1682
-
Lee M.H.L., Ser Y.C., Selvachandran G., Pham T.H. A comparative study of forecasting electricity consumption using machine learning models. Mathematics. 2022. Vol. 10. Article 1329. DOI: 10.3390/math10081329
-
Dayarathna M., Wen Yo., Fan Rui. Data center energy consumption modeling: a survey. IEEE Communications Surveys & Tutorials. 2016. Vol. 18. No. 1. DOI: 10.1109/COMST.2015.2481183
-
Mughees M., Li Y., Chen Y., Li Y.R. Short-term load forecasting for ai-data center. IEEE PES General Meeting 2025. Electrical Engineering and Systems Science. 2025. DOI: 10.48550/arXiv.2503.07756
-
Ye Z., Gao W., Hu Q. et al. Deep learning workload scheduling in GPU datacenters: A survey. ACM Computing Surveys. 2024. Vol. 56. No. 6. Pp. 1–38. DOI: 10.1145/3638757
-
Munkhammar J., Meer D., Widén J. Very short term load forecasting of residential electricity consumption using the Markov-chain mixture distribution (MCM) model. Applied Energy. 2021. 282(A):116180. DOI: 10.1016/j.apenergy.2020.116180
-
Hippert H.S., Pedreira C.E., Souza R.C. Neural networks for short-term load forecasting: a review and evaluation. IEEE Transactions on Power Systems. Vol. 16. No. 1. Pp. 44–55. 2001. DOI: 10.1109/59.910780
-
Sailor D.J., Munoz J.R. Sensitivity of electricity and natural gas consumption to climate in the U.S.A. Methodology and results for eight states. Energy. 1997. Vol. 22. No. 10. Pp. 987–998. DOI: 10.1016/S0360-5442(97)00034-0
-
Hong T., Pinson P., Fan S. et al. Probabilistic energy forecasting: global energy forecasting competition 2014 and beyond. International Journal of Forecasting. 2016. Vol. 32. No. 3. Pp. 896–913. DOI: 10.1016/j.ijforecast.2016.02.001
-
Wang A., Yu Q., Wang J. et al. Electric load forecasting based on deep ensemble learning. Applied Sciences. 2023. Vol. 13. No. 17. P. 9706. DOI: 10.3390/app13179706
-
Lim B., Arık Ö.S., Loeff N., Pfister T. Temporal Fusion Transformer for interpretable multi-horizon time series forecasting. International Journal of Forecasting. 2021. Vol. 37. No. 1. DOI: 10.1016/j.ijforecast.2021.03.012
-
Challu C., Olivares K.G., Oreshkin B.N. et al. N‑HiTS: Neural hierarchical interpolation for time series forecasting. Proceedings of the AAAI Conference on Artificial Intelligence. 2023. Vol. 37. No. 6. Pp. 6989–6997. DOI: 10.48550/arXiv.2201.12886
-
Ahmad H., Mortazavi S.K., Bahnasawi M.E. et al. Enhanced time series forecasting: integrating PatchTST with BERT Layers. Conference: 5th International Conference on Applied Mathematics & Computer Science (ICAMCS 2025). At: Venice, Italy, September 27–29, 2025. DOI: 10.1109/ICAMCS62774.2024.00014
-
Dorogush A.V., Ershov V., Gulin A. CatBoost: gradient boosting with categorical features support. DOI: 10.48550/arXiv.1810.11363.2018
-
Lim B., Arık S.Ö., Loeff N., Pfister T. Temporal Fusion Transformer for interpretable multi-horizon time series forecasting. International Journal of Forecasting. Vol. 37. No. 4. 2021. Pp. 1748–1764. DOI: 10.1016/j.ijforecast.2021.03.012
-
Nie Y., Nguyen N.H., Sinthong P., Kalagnanam J. A time series is worth 64 words: long-term forecasting with transformers (PatchTST). Proceedings of the International Conference on Learning Representations (ICLR 2023). https://arxiv.org/pdf/2211.14730.pdf
ДОПОЛНИТЕЛЬНАЯ ИНФОРМАЦИЯ
Конфликт интересов
Авторы заявляют об отсутствии конфликта интересов.
Вклад авторов
Дзгоев А. Э. – научное руководство исследованием, постановка задачи, поиск и подготовка реальных данных, прогнозирование потребления электроэнергии, интерпретация результатов, оценка качества и адекватности моделей, разработка регрессионных моделей, описание результатов, тестирование моделей на реальных данных энергетической компании;
Климкин Е. В. – разработка регрессионных моделей, настройка гиперпараметров модели, обучение моделей, проведение расчетов, написание кода программы на Python, составление графиков по результатам расчетов, проверка остатков модели;
Черняускас В. В. – анализ данных, подготовка датасета, оценка автокорреляции;
Брайловский А. В. – расчет значений критериев качества моделей, проверка моделей на качество, оценка гетероскедастичности;
Резеньков Р. Н. – проверка математических моделей на адекватность, расчет ошибки прогнозирования MAPE (%).
Финансирование
Исследование проведено без спонсорской поддержки.
Информация об авторах
- Дзгоев Алан Эдуардович, канд. техн. наук, доцент, доцент кафедры «Цифровая трансформация» Института информационных технологий, МИРЭА – Российский технологический университет; 119454, Россия, Москва, проспект Вернадского, 78;
dzgoev@mirea.ru, ORCID: 0000-0002-1314-6151, SPIN-код: 8092-8784 - Климкин Егор Владимирович, студент, кафедра прикладной математики, Институт информационных технологий, МИРЭА – Российский технологический университет; 119454, Россия, Москва, проспект Вернадского, 78;
KlimkinEVK@yandex.ru, ORCID: 0009-0001-3876-3041, SPIN-код: 7018-6703 - Черняускас Владислав Витаутович, ст. преподаватель кафедры «Цифровая трансформация», Институт информационных технологий, МИРЭА – Российский технологический университет; 119454, Россия, Москва, проспект Вернадского, 78;
chernyauskas-vladislav@yandex.ru, ORCID: 0009-0002-8438-3418, SPIN-код: 5867-6366 - Брайловский Андрей Валерьевич, ассистент кафедры «Цифровая трансформация», Институт информационных технологий, МИРЭА – Российский технологический университет; 119454, Россия, Москва, проспект Вернадского, 78;
brajlovskij@mirea.ru, ORCID: 0009-0006-1794-7825, SPIN-код: 5900-1835 - Резеньков Роман Николаевич, канд. техн. наук, доцент, доцент кафедры «Цифровая трансформация», Институт информационных технологий, МИРЭА – Российский технологический университет; 119454, Россия, Москва, проспект Вернадского, 78;
rezenkov@mirea.ru, ORCID: 0009-0005-5542-2125