← 开源
Henry-23

VideoChat

实时交互数字人,可自定义形象与音色,支持音色克隆,对话延迟低至3s。Real-time voice interactive digital human, customizable appearance and voice, supporting voice cloning, with initial package delay as low as 3s.

ApplicationsPersonalPython
在 GitHub 打开
增长势头
+124 小时新增 Star+0.1%
1.32k
Star
173
Fork
+5
本周
1
贡献者
创建于 2024-10-18 · 更新于 2026-10-16 · 今日第 5635 名
主要开发者
Henry-23

Henry-23/VideoChat 排名第 5,635,有 1,322 个星标。

同类别比较

Henry-23/VideoChat 排名第 5,635,此处有 8 个同类条目;spiculedata/saiku 排名第 5,626。

同类别比较
名称排名指标
specstoryai/getspecstory5,613
语言:
Go
星标数:
1,354
分叉数:
91
简介:
Install our local first extensions for your favorite AI IDE or Terminal Agent. Process your histories into reusable skills with Lore. Sync your conversations to the cloud. File issues and requests.
ttop32/MouseTooltipTranslator5,617
语言:
JavaScript
星标数:
1,351
分叉数:
185
简介:
Mouseover Translate Any Language At Once - Chrome Extension: PDF Translator, EBOOK, EPUB, OCR, TTS, NETFLIX, YOUTUBE DUAL SUBTITLES, GOOGLE DOCS, AI, VIEWER, GMAIL, WRITING, IMAGE, DUAL SUBS, MANGA, HOVER, DICTIONARY, WEBTOON, EDGE, JAPANESE, ENGLISH
SSShooter/ebook-to-mindmap5,623
语言:
TypeScript
星标数:
1,333
分叉数:
157
简介:
AI-powered Summaries by Extracting Content from EPUB and PDF. epub、pdf 拆书 AI 总结
spiculedata/saiku5,626
语言:
Java
星标数:
1,331
分叉数:
658
简介:
Open-source semantic layer: one cube for Excel (MDX/XMLA), dashboards, and AI agents (MCP). Mondrian + Apache Calcite.
hhyqhh/inno-agent5,650
语言:
TypeScript
星标数:
1,299
分叉数:
231
chonyy/AI-basketball-analysis5,651
语言:
Python
星标数:
1,298
分叉数:
236
简介:
:basketball::robot::basketball: AI web app and API to analyze basketball shots and shooting pose.
blakeblackshear/frigate-hass-integration5,667
语言:
Python
星标数:
1,279
分叉数:
198
简介:
Frigate integration for Home Assistant
openai/codex-action5,672
语言:
JavaScript
星标数:
1,270
分叉数:
179
关键参数与规格
关键参数与规格
参数值
语言Python
类别Applications
子类别Personal
关键词AI character, Video production, Voice
星标数1,322
分叉数173
贡献者1
创建日期2024-10-18
更新日期2026-10-16
1 天星标数1
7 天星标数5
排名5,635
上次排名5,784
排名变化149
7 天星标排名5,589
上次 7 天星标排名5,602
7 天星标排名变化13
总星标排名8,963
上次总星标排名8,956
总星标排名变化-7
国家China
README 摘录

数字人对话demo 实时语音交互数字人,支持端到端(MLLM - THG)和级联(ASR-LLM-TTS-THG)。 技术介绍:量子位推文 **中文简体** | **English** Star History 技术选型 ASR (Automatic Speech Recognition): FunASR LLM (Large Language Model): Qwen End-to-end MLLM (Multimodal Large Language Model): GLM-4-Voice TTS (Text to speech): GPT-SoVITS, CosyVoice, edge-tts THG

(Talking Head Generation): MuseTalk 本地部署 0. 显存需求 级联方案(ASR-LLM-TTS-THG):约8G,首包约3s(单张A100)。 2 requirements中的版本仅供参考,最新依赖请查看对应模块的Repo说明 2. 1 创空间下载(推荐) 创空间仓库已设置 追踪权重文件,如果

是通过 克隆,则无需额外配置 2. 1 使用API-KEY(默认) 对于LLM模块和TTS模块,如果本地机器性能有限,可使用阿里云大模型服务平台百炼提供的Qwen API和CosyVoice API,请在app. 2 不使用API-KEY 如果不使用API-KEY,请参

考以下说明修改相关代码。 可参考如下方式安装 : 安装完成后,参考这个链接进行部署,使用 初始化实例调用本地推理服务。 若不使用API-KEY,可直接删除 相关的内容,使用 调用Edge浏览器的免费TTS服务

进行推理。 demo中可使用音色克隆功能,上传任意语音内容的参考音频后开始对话,或将音色永久添加到demo中: 1. 右侧视频流播放卡顿:需等待Gradio优化Video Streaming效果 3.

常见问题

记录了多少星标和分叉?

Henry-23/VideoChat 有 1,322 个星标和 173 个分叉。

仓库排名是多少?

Henry-23/VideoChat 排名第 5,635。

记录的语言和类别是什么?

Henry-23/VideoChat 有 1,322 个星标,语言为 Python,类别为 Applications。

哪个仓库排名最接近?

Henry-23/VideoChat 与 spiculedata/saiku 比较,后者排名第 5,626,有 1,331 个星标。

README

数字人对话demo

实时语音交互数字人,支持端到端(MLLM - THG)和级联(ASR-LLM-TTS-THG)。可自定义形象与音色,支持音色克隆,首包延迟低至3s。

技术介绍:量子位推文

中文简体 | English

Star History

技术选型

本地部署

0. 显存需求

  • 级联方案(ASR-LLM-TTS-THG):约8G,首包约3s(单张A100)。

  • 端到端语音方案(MLLM-THG):约20G,首包约7s(单张A100)。

如果不需要使用端到端 MLLM,请选择仅包含级联方案的cascade_only分支。

$ git checkout cascade_only

1. 环境配置

  • ubuntu 22.04
  • python 3.10
  • CUDA 12.2
$ git lfs install
$ git clone https://www.modelscope.cn/studios/AI-ModelScope/video_chat.git
$ conda create -n metahuman python=3.10
$ conda activate metahuman
$ cd video_chat
$ pip install -r requirements.txt

requirements中的版本仅供参考,最新依赖请查看对应模块的Repo说明

2. 权重下载

2.1 创空间下载(推荐)

创空间仓库已设置git lfs追踪权重文件,如果是通过git clone https://www.modelscope.cn/studios/AI-ModelScope/video_chat.git克隆,则无需额外配置

2.2 手动下载

2.2.1 MuseTalk

参考这个链接

目录如下:

./weights/
├── dwpose
│   └── dw-ll_ucoco_384.pth
├── face-parse-bisent
│   ├── 79999_iter.pth
│   └── resnet18-5c106cde.pth
├── musetalk
│   ├── musetalk.json
│   └── pytorch_model.bin
├── sd-vae-ft-mse
│   ├── config.json
│   └── diffusion_pytorch_model.bin
└── whisper
    └── tiny.pt
2.2.2 GPT-SoVITS

参考这个链接

2.2.3 GLM-4-Voice

在app.py中添加如下代码即可完成下载。

from modelscope import snapshot_download
snapshot_download('ZhipuAI/glm-4-voice-tokenizer',cache_dir='./weights')
snapshot_download('ZhipuAI/glm-4-voice-decoder',cache_dir='./weights')
snapshot_download('ZhipuAI/glm-4-voice-9b',cache_dir='./weights')

3. 其他配置

LLM模块和TTS模块提供了多种方式,可自行选择推理方式

3.1 使用API-KEY(默认)

对于LLM模块和TTS模块,如果本地机器性能有限,可使用阿里云大模型服务平台百炼提供的Qwen API和CosyVoice API,请在app.py(line 14)中配置API-KEY。

参考这个链接完成API-KEY的获取与配置。

os.environ["DASHSCOPE_API_KEY"] = "INPUT YOUR API-KEY HERE"

3.2 不使用API-KEY

如果不使用API-KEY,请参考以下说明修改相关代码。

3.2.1 LLM模块

src/llm.py中提供了Qwen和Qwen_API两个类分别处理本地推理和调用API。若不使用API-KEY,有以下两种方式进行本地推理:

  1. 使用Qwen完成本地推理。
  2. Qwen_API默认调用API完成推理,若不使用API-KEY,还可以使用vLLM加速LLM推理。可参考如下方式安装vLLM:
    $ git clone https://github.com/vllm-project/vllm.git
    $ cd vllm
    $ python use_existing_torch.py
    $ pip install -r requirements-build.txt
    $ pip install -e . --no-build-isolation
    
    安装完成后,参考这个链接进行部署,使用Qwen_API(api_key="EMPTY",base_url="http://localhost:8000/v1")初始化实例调用本地推理服务。
3.2.2 TTS模块

src/tts.py中提供了GPT_SoVits_TTS和CosyVoice_API分别处理本地推理和调用API。若不使用API-KEY,可直接删除CosyVoice_API相关的内容,使用Edge_TTS调用Edge浏览器的免费TTS服务进行推理。

4. 启动服务

$ python app.py

5. 使用自定义数字人(可选)

5.1 自定义数字人形象

  1. 在/data/video/中添加录制好的数字人形象视频
  2. 修改/src/thg.py中Muse_Talk类的avatar_list,加入(形象名, bbox_shfit),关于bbox_shift的说明参考这个链接
  3. 在/app.py中Gradio的avatar_name中加入数字人形象名后重新启动服务,等待完成初始化即可。

5.2 自定义数字人音色

GPT-SoVits支持自定义音色。demo中可使用音色克隆功能,上传任意语音内容的参考音频后开始对话,或将音色永久添加到demo中:

  1. 在/data/audio中添加音色参考音频,音频长度3-10s,命名格式为x.wav
  2. 在/app.py中Gradio的avatar_voice中加入音色名(命名格式为x (GPT-SoVits))后重新启动服务。
  3. TTS选型选择GPT-SoVits,开始对话

6. 已知问题

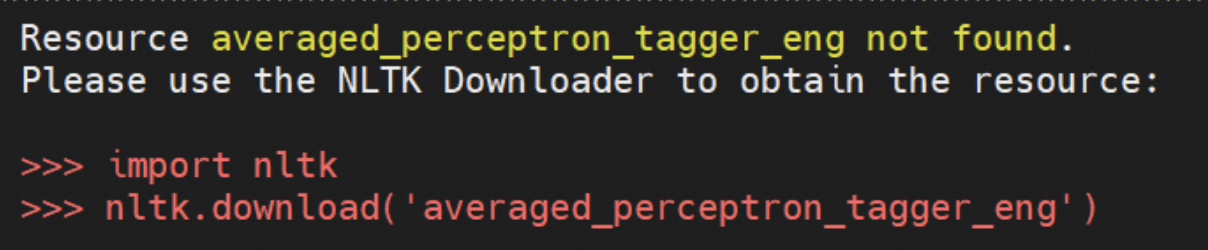
  1. 报错无法找到某资源:按照报错提示下载对应的资源即可

  2. 右侧视频流播放卡顿:需等待Gradio优化Video Streaming效果

  3. 与模型加载相关:检查权重是否下载完整

排名相邻
同类项目